Matriz de confusión, precisión, recall y F1-score
Cada métrica de clasificación usada para evaluar un modelo (exactitud, precisión, recall, F1 y más) se calcula directamente a partir de solo cuatro números: la matriz de confusión. Esta entrada cubre la anatomía completa de esa matriz y de cada métrica derivada de ella, tanto para problemas binarios como multiclase. Una vez que entiendes estas métricas en un único umbral, la curva ROC y el AUC resumen cómo se intercambian a medida que el umbral varía.
La matriz de confusión
Un clasificador binario que ya se ha comprometido con una decisión (positivo o negativo) puede compararse con las etiquetas reales. Cada observación cae en exactamente una de cuatro celdas:
| Predicho positivo | Predicho negativo | |
|---|---|---|
| Realmente positivo | Verdadero Positivo (VP) | Falso Negativo (FN) |
| Realmente negativo | Falso Positivo (FP) | Verdadero Negativo (VN) |
Un ejemplo concreto ayuda a recordar las cuatro celdas. Piensa en un filtro de spam que decide, para cada correo entrante, si es spam:
- Verdadero Positivo (VP): spam correctamente detectado y enviado a la carpeta de spam.
- Falso Negativo (FN): spam que se coló y llegó a la bandeja de entrada, un fallo por omisión.
- Falso Positivo (FP): un correo real y legítimo enviado por error a la carpeta de spam, una falsa alarma.
- Verdadero Negativo (VN): un correo real correctamente mantenido en la bandeja de entrada.
Cada métrica de esta entrada no es más que un ratio distinto calculado a partir de estos cuatro recuentos.
Métricas derivadas de la matriz
Cada métrica de abajo no es más que un ratio distinto de los cuatro recuentos anteriores, pero cada una responde a una pregunta distinta sobre el comportamiento del clasificador.
\[\text{Exactitud} = \frac{VP+VN}{VP+FP+FN+VN} \qquad \text{Precisión} = \frac{VP}{VP+FP}\] \[\text{Recall (Sensibilidad)} = \frac{VP}{VP+FN} \qquad \text{Especificidad} = \frac{VN}{VN+FP}\] \[F_1 = \frac{2 \cdot \text{Precisión} \cdot \text{Recall}}{\text{Precisión}+\text{Recall}}\]
La precisión responde a una pregunta de falsas alarmas: de todo lo que marqué como positivo, ¿cuánto era realmente correcto? El recall responde a una pregunta de casos perdidos: de todo lo que era realmente positivo, ¿cuánto detecté? Ambas se intercambian entre sí: un modelo que marca todo como positivo obtiene un recall perfecto (100%), porque nunca pierde un positivo real, pero una precisión pésima, porque la mayoría de sus marcas positivas son erróneas. Un modelo que solo marca los casos de los que está más seguro hace lo contrario: precisión alta, recall bajo.
El \(F_1\) es la media armónica de la precisión y el recall, no la media aritmética, y esa elección es deliberada. La media armónica castiga un desequilibrio grande entre ambas mucho más que una media simple, así que un modelo no puede lograr un buen F1 siendo excelente en una y pésimo en la otra: las dos tienen que ser razonablemente buenas a la vez.
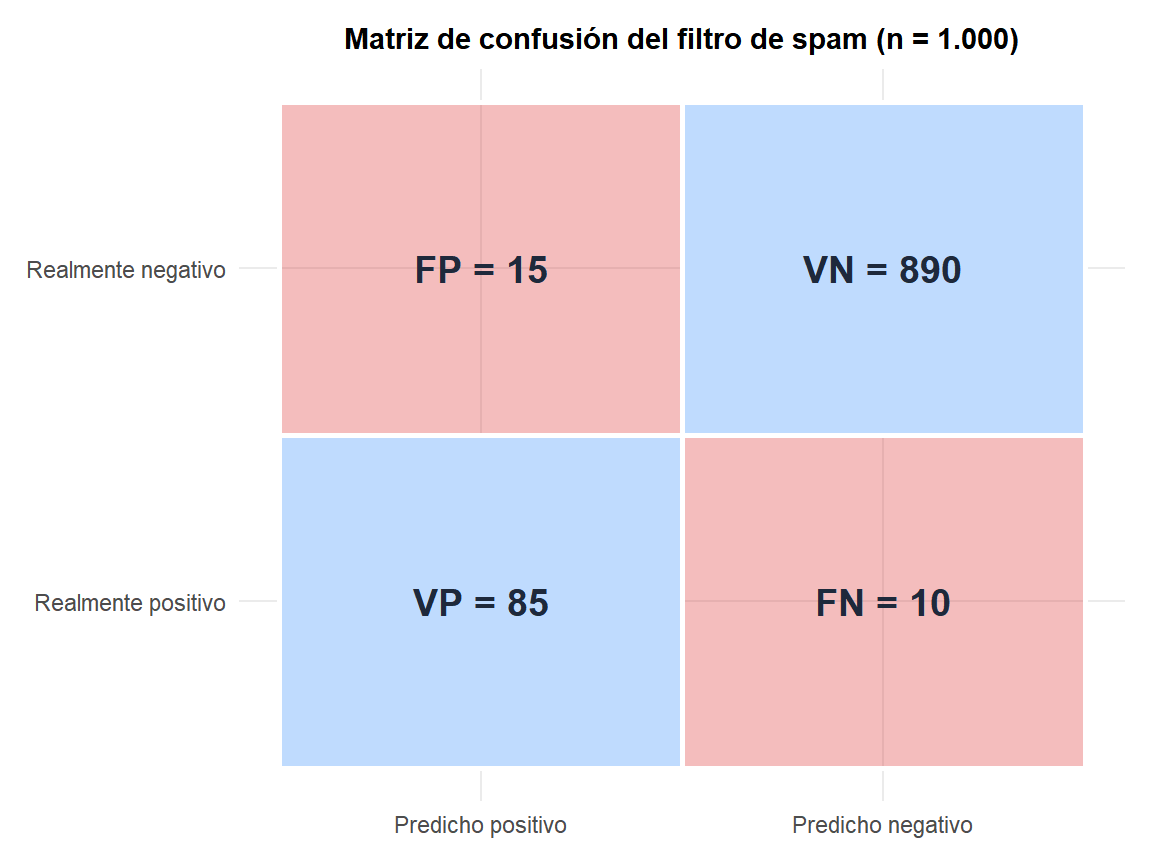
\[VP = 85 \qquad FP = 15 \qquad FN = 10 \qquad VN = 890 \qquad n = 1000\]
\[\text{Exactitud} = \frac{85+890}{1000} = 0{,}975 \qquad \text{Precisión} = \frac{85}{85+15} = 0{,}850\] \[\text{Recall} = \frac{85}{85+10} = 0{,}8947 \qquad \text{Especificidad} = \frac{890}{890+15} = 0{,}9834\] \[F_1 = \frac{2 \times 0{,}850 \times 0{,}8947}{0{,}850+0{,}8947} = 0{,}8718\]
La exactitud parece excelente (97,5%), pero este conjunto de datos está desequilibrado: solo \(VP+FN=95\) de los 1.000 correos son realmente spam (prevalencia del 9,5%). Un clasificador trivial que siempre prediga “no es spam” acertaría \(VN+FP = 905\) de 1.000, una exactitud de 0,905 (90,5%), solo 7 puntos porcentuales por debajo del clasificador real, a pesar de ser completamente inútil (no detecta ni un solo correo de spam, recall = 0). Esto es exactamente por qué la exactitud por sí sola es un número engañoso como titular en datos desequilibrados: la precisión, el recall y el F1 cuentan la historia real.

El caso multiclase: promediado macro, micro y ponderado
Con más de dos clases, no hay una única celda de la matriz de confusión a la que llamar “positiva”. En su lugar, cada clase se trata por turnos como “positiva” y todas las demás como “negativas” (uno contra el resto), lo que produce una precisión, un recall y un F1 por clase. Esos números por clase después hay que combinarlos en una única puntuación resumen, y hay tres formas estándar de hacerlo.
\[\text{Promedio macro} = \frac{1}{k}\sum_{i=1}^k \text{métrica}_i\] \[\text{Promedio ponderado} = \sum_{i=1}^k \frac{n_i}{n}\, \text{métrica}_i\] \[\text{Promedio micro} = \frac{\sum_i VP_i}{\sum_i VP_i + \sum_i FP_i}\]
El promedio macro toma la media sin ponderar entre clases. El promedio ponderado pondera la métrica de cada clase por su soporte \(n_i\). El promedio micro agrupa antes los VP/FP/FN de todas las clases y calcula un único ratio, lo que en un problema multiclase de una sola etiqueta equivale exactamente a la exactitud global.
Matriz de confusión (filas = clase real, columnas = clase predicha):
| Predicho Gato | Predicho Perro | Predicho Pájaro | Total (soporte) | |
|---|---|---|---|---|
| Real Gato | 50 | 8 | 2 | 60 |
| Real Perro | 5 | 40 | 5 | 50 |
| Real Pájaro | 3 | 7 | 30 | 40 |
Precisión, recall y F1 por clase (cada clase tratada como “positiva” por turnos, p. ej. para Gato: \(VP=50\), \(FP=5+3=8\), \(FN=8+2=10\)):
| Clase | Precisión | Recall | F1 | Soporte |
|---|---|---|---|---|
| Gato | 0,8621 | 0,8333 | 0,8475 | 60 |
| Perro | 0,7273 | 0,8000 | 0,7619 | 50 |
| Pájaro | 0,8108 | 0,7500 | 0,7792 | 40 |
F1 promedio macro \(= (0{,}8475+0{,}7619+0{,}7792)/3 = 0{,}7962\) (trata las tres clases como igual de importantes, sin importar cuántos ejemplos haya de cada una).
F1 promedio ponderado \(= (0{,}8475{\times}60 + 0{,}7619{\times}50 + 0{,}7792{\times}40)/150 = 0{,}8007\) (pondera el F1 de cada clase según su frecuencia en los datos, así que está dominado por el rendimiento en las clases mayoritarias).
Promedio micro (= exactitud global aquí) \(= (50+40+30)/150 = 0{,}8000\).
Los tres números resumen responden a una pregunta genuinamente distinta, y pueden divergir mucho cuando los tamaños de las clases son muy desiguales, indica siempre explícitamente qué método de promediado usa una métrica reportada.
⚠️ El promedio macro puede ocultar un mal rendimiento en clases raras, y viceversa
Si una clase es rara (soporte pequeño) y el modelo funciona terriblemente en ella, el F1 con PROMEDIO MACRO reflejará claramente ese mal rendimiento (todas las clases cuentan igual, así que una clase mala arrastra visiblemente el promedio macro hacia abajo), pero el F1 con PROMEDIO PONDERADO (y la exactitud a secas) puede parecer engañosamente bueno, ya que la clase rara apenas mueve un número ponderado por soporte. Esto es exactamente la misma trampa de datos desequilibrados que el ejemplo binario del spam anterior, generalizada a varias clases: cuando una clase rara concreta importa mucho (p. ej., detectar un subtipo raro de enfermedad, o un tipo raro de fraude entre varias categorías de fraude), informa del promedio macro Y de la precisión/recall propios de esa clase concreta, no solo de un número agregado que una clase mayoritaria puede dominar.
Ejecutarlo en R
Las métricas binarias se pueden calcular a mano a partir de los cuatro recuentos, pero caret y yardstick gestionan directamente el flujo completo binario y multiclase, incluido el promediado macro/micro:
# Caso binario
VP <- 85; FP <- 15; FN <- 10; VN <- 890
precision <- VP / (VP + FP)
recall    <- VP / (VP + FN)
f1        <- 2 * precision * recall / (precision + recall)

# Usando caret sobre vectores reales de etiquetas predichas/reales
library(caret)
confusionMatrix(pred_labels, true_labels, positive = "spam", mode = "prec_recall")

# Multiclase: detalle completo por clase + resumen macro/ponderado
library(yardstick)
library(dplyr)
df <- data.frame(truth = factor(c("Cat","Cat","Dog","Bird")),
                  estimate = factor(c("Cat","Dog","Dog","Bird")))
df %>% yardstick::precision(truth, estimate, estimator = "macro")
df %>% yardstick::f_meas(truth, estimate, estimator = "macro")
df %>% yardstick::f_meas(truth, estimate, estimator = "micro")
💡 Qué métrica optimizar
No existe una única métrica “mejor”, depende completamente del coste relativo de los dos tipos de error. Optimiza el RECALL cuando perder un caso positivo es costoso (cribado médico para una enfermedad grave, detección de fraude donde un fraude no detectado sale muy caro). Optimiza la PRECISIÓN cuando una falsa alarma es costosa (un filtro de spam que entierra por error un correo importante, un sistema de recomendación que muestra sugerencias irrelevantes y molestas). Usa el F1 como número único equilibrado cuando ambos tipos de error importan aproximadamente igual y necesitas un solo número para comparar modelos o ajustar un umbral; pero mira siempre también la precisión y el recall por separado, el F1 por sí solo puede ocultar cuál de los dos está causando una puntuación baja.

