Corrección de Bonferroni
Cuando realizas muchos contrastes de hipótesis a la vez, cada uno individualmente con \(\alpha=0{,}05\), la probabilidad de que al menos uno produzca un falso positivo por puro azar crece rápidamente con el número de contrastes. La corrección de Bonferroni es la solución más simple y más utilizada: ajusta el umbral de significación en proporción al número de contrastes que has realizado.
El problema de las comparaciones múltiples
Con \(m\) contrastes independientes, cada uno realizado con un nivel de significación \(\alpha\), la probabilidad de al menos un falso positivo en el conjunto completo (la tasa de error familywise, FWER) es:
\[P(\text{al menos un falso positivo}) = 1-(1-\alpha)^m\]
Esto crece mucho más rápido de lo que la intuición sugiere. Manteniendo cada contraste individual con \(\alpha=0{,}05\):
| Número de contrastes (\(m\)) | FWER: \(1-(0{,}95)^m\) |
|---|---|
| 1 | 0,050 |
| 5 | 0,226 |
| 10 | 0,401 |
| 20 | 0,642 |
Con solo 20 contrastes independientes con un \(\alpha=0{,}05\) bruto cada uno, hay aproximadamente un 64% de probabilidad de al menos un resultado “significativo” espurio, incluso si todas y cada una de las hipótesis nulas son exactamente ciertas. Realizar muchos contrastes e informar de cualquiera que cruce \(p<0{,}05\), sin ningún ajuste, garantiza casi con total seguridad la aparición de falsos descubrimientos.
Cuándo es (y no es) necesaria la corrección
La corrección es necesaria siempre que varios contrastes de hipótesis se consideren en conjunto como una sola familia, y que cualquiera de ellos calificado erróneamente como significativo cuente como un fallo de la afirmación general. Situaciones típicas:
- Comparar todos los pares de grupos tras un resultado significativo en ANOVA (consulta la sección de contrastes post-hoc del tutorial de ANOVA).
- Contrastar docenas o cientos de biomarcadores, genes o métricas de una web en busca de una diferencia entre dos condiciones.
- Repetir el mismo contraste en muchos subgrupos, regiones o periodos de tiempo, buscando en la práctica “el que funciona”.
En general, la corrección no es necesaria para un único contraste de hipótesis preregistrado y planificado de antemano. Si decides de antemano exactamente qué contraste responde a tu pregunta de investigación y realizas solo ese contraste, no existe ningún problema de comparaciones múltiples que corregir. El problema aparece específicamente cuando empiezas a contrastar muchas cosas a la vez y consideras destacable cualquiera de ellas que cruce \(p<0{,}05\).
La corrección de Bonferroni
La solución es sorprendentemente sencilla: divide el umbral de significación entre el número de contrastes \(m\).
\[\alpha_{\text{Bonferroni}} = \frac{\alpha}{m}\]
De forma equivalente, y más habitual en la práctica, multiplica cada p-valor individual por \(m\) (con un tope de 1) y compara el p-valor ajustado con el \(\alpha\) original:
\[p_{\text{ajust},i} = \min(p_i \times m,\ 1)\]
Ambas formulaciones dan lugar a decisiones idénticas: un contraste supera la corrección exactamente cuando su p-valor bruto está por debajo de \(\alpha/m\), que es exactamente cuando su p-valor ajustado está por debajo de \(\alpha\). Esto garantiza que la tasa de error familywise se mantenga en \(\alpha\) o por debajo, sin importar la estructura de correlación entre los contrastes. Funciona incluso cuando los contrastes no son independientes, lo cual es parte de la razón por la que sigue siendo tan popular a pesar de ser conservadora.
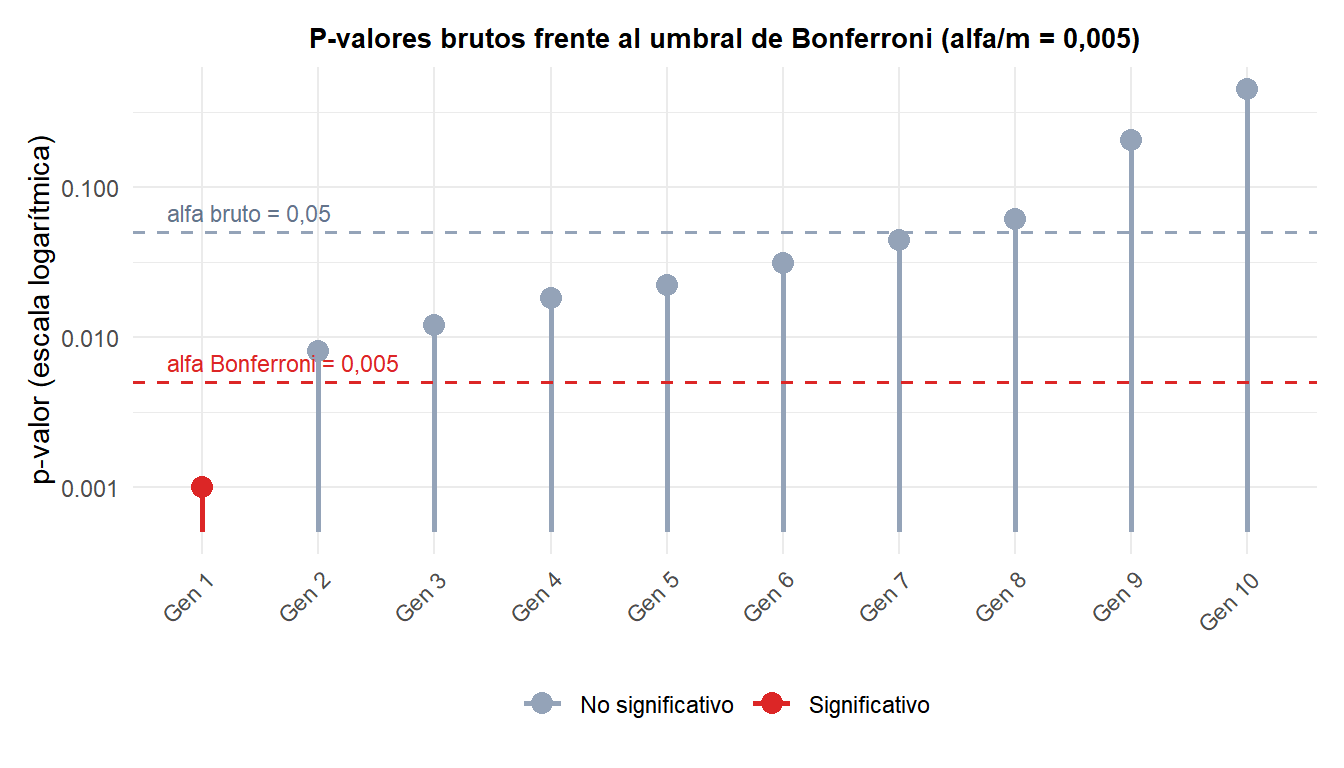
Un investigador compara los niveles de expresión de 10 genes entre dos condiciones, realizando 10 pruebas t independientes y obteniendo estos p-valores brutos:
\[0{,}001,\ 0{,}008,\ 0{,}012,\ 0{,}018,\ 0{,}022,\ 0{,}031,\ 0{,}044,\ 0{,}061,\ 0{,}204,\ 0{,}450\]
Con el umbral bruto \(\alpha=0{,}05\), 7 de los 10 genes parecen “significativos” (todos excepto los tres últimos: 0,061, 0,204, 0,450). Pero con \(m=10\) contrastes, el umbral corregido por Bonferroni es \(\alpha/m = 0{,}05/10 = 0{,}005\).
| p-valor bruto | p-valor ajustado por Bonferroni (\(p \times 10\), con tope 1) | ¿Significativo con \(\alpha=0{,}05\) ajustado? |
|---|---|---|
| 0,001 | 0,010 | Sí |
| 0,008 | 0,080 | No |
| 0,012 | 0,120 | No |
| 0,018 | 0,180 | No |
| 0,022 | 0,220 | No |
| 0,031 | 0,310 | No |
| 0,044 | 0,440 | No |
| 0,061 | 0,610 | No |
| 0,204 | 1,000 | No |
| 0,450 | 1,000 | No |
Solo 1 de los 10 genes sobrevive a la corrección. Lo que parecían 7 “hallazgos” con el umbral bruto se reduce a un único resultado robusto una vez que la corrección tiene en cuenta que se realizaron 10 contrastes. Este es precisamente el sentido de la corrección: la mayoría de esos resultados “significativos” brutos eran exactamente el tipo de falsos positivos que predice el problema de las comparaciones múltiples.

El método escalonado de Holm: una mejora estricta de Bonferroni
El procedimiento de Holm es uniformemente más potente que la Bonferroni simple, y sigue controlando exactamente la tasa de error familywise en \(\alpha\), así que rara vez hay una buena razón para preferir la Bonferroni simple en la práctica. Funciona como un procedimiento escalonado:
- Ordena los p-valores de forma ascendente: \(p_{(1)} \leq p_{(2)} \leq \cdots \leq p_{(m)}\).
- Compara el \(i\)-ésimo p-valor más pequeño con \(\alpha/(m-i+1)\).
- Empezando por \(i=1\), rechaza cada hipótesis mientras su p-valor esté por debajo de su umbral. Detente en el primer fallo, y no rechaces esa hipótesis ni ninguna con un p-valor mayor.
Para el ejemplo de expresión génica, el procedimiento de Holm también rechaza únicamente el p-valor más pequeño. El más pequeño, 0,001, se compara con \(\alpha/(10-1+1) = 0{,}05/10 = 0{,}005\) y lo supera. El segundo más pequeño, 0,008, se compara con \(\alpha/(10-2+1) = 0{,}05/9 \approx 0{,}0056\) y falla, ya que \(0{,}008 > 0{,}0056\). El procedimiento escalonado se detiene ahí, así que la conclusión final es la misma que con la Bonferroni simple en este ejemplo concreto: solo 1 de los 10 genes es significativo. Pero esta coincidencia es propia de este conjunto de datos, no una regla general: el método de Holm nunca es menos potente que Bonferroni, y a menudo es más potente, así que debería ser la opción práctica por defecto siempre que se busque una corrección simple de la tasa de error familywise.
La razón por la que Holm solo puede mejorar a Bonferroni está en los propios umbrales. La Bonferroni simple compara todos y cada uno de los p-valores con el mismo umbral estricto \(\alpha/m\). Los umbrales escalonados de Holm empiezan en ese mismo valor estricto para el p-valor más pequeño, pero se relajan en cada paso siguiente, desde \(\alpha/m\) hacia \(\alpha/(m-1)\), \(\alpha/(m-2)\), y así sucesivamente, ya que quedan menos hipótesis “en juego” una vez que las anteriores ya han sido rechazadas. Esto significa que el procedimiento de Holm nunca puede rechazar menos hipótesis que Bonferroni, y a menudo rechaza estrictamente más, mientras ofrece exactamente la misma garantía sobre la tasa de error familywise.
⚠️ Bonferroni es conservadora, y controla una tasa de error distinta de la que podrías esperar
Bonferroni (y Holm) controlan la tasa de error familywise: la probabilidad de cualquier falso positivo entre los \(m\) contrastes. Es un estándar estricto, apropiado cuando incluso un único falso positivo resultaría costoso, por ejemplo aprobar una única variante de fármaco ineficaz, o señalar erróneamente a un único empleado por fraude. Pero se vuelve extremadamente conservadora a medida que \(m\) crece. En contextos exploratorios con cientos o miles de contrastes, como cribar miles de genes o cientos de métricas de un test A/B de una web, Bonferroni sepultará casi cualquier efecto real y verdadero bajo un número abrumador de comparaciones. Para esos escenarios exploratorios a gran escala, controla en su lugar la tasa de falsos descubrimientos (la proporción esperada de falsos positivos entre los resultados que consideras significativos), usando el procedimiento de Benjamini-Hochberg.
Benjamini-Hochberg (FDR): una alternativa menos conservadora para contrastes a gran escala
El enfoque de la tasa de falsos descubrimientos (FDR) plantea una pregunta distinta a la de la tasa de error familywise. FWER pregunta “¿cuál es la probabilidad de cualquier falso positivo?”. FDR pregunta en cambio “de los resultados que señalo como significativos, ¿qué fracción se espera que sean falsos?”. Tolerar una fracción pequeña y controlada de falsos positivos entre tus hallazgos, en lugar de protegerte frente a cualquiera de ellos, es mucho menos conservador y mucho más potente para detectar efectos reales cuando \(m\) es grande.
El procedimiento de Benjamini-Hochberg (BH):
- Ordena los p-valores de forma ascendente: \(p_{(1)} \leq p_{(2)} \leq \cdots \leq p_{(m)}\).
- Encuentra el \(i\) más grande tal que \(p_{(i)} \leq \frac{i}{m}\alpha\).
- Rechaza todas las hipótesis hasta esa \(i\)-ésima, inclusive.
A diferencia de Bonferroni y Holm, cuyos umbrales se vuelven más estrictos (o se mantienen igual) al crecer \(m\), los umbrales de BH, \(\frac{i}{m}\alpha\), aumentan de forma lineal con el rango \(i\). El p-valor más grande está permitido hasta llegar a \(\alpha\) mismo, mientras que el más pequeño se mantiene en el umbral más estricto \(\alpha/m\). Esta escala progresiva es lo que hace que BH sea mucho menos conservador que aplicar un umbral fijo \(\alpha/m\) a todos los contrastes.
Aplicando BH a los mismos 10 p-valores de genes, con \(\alpha=0{,}05\) y \(m=10\):
| Rango \(i\) | p-valor \(p_{(i)}\) | Umbral \(\frac{i}{10}\alpha\) | ¿Por debajo del umbral? |
|---|---|---|---|
| 1 | 0,001 | 0,005 | Sí |
| 2 | 0,008 | 0,010 | Sí |
| 3 | 0,012 | 0,015 | Sí |
| 4 | 0,018 | 0,020 | Sí |
| 5 | 0,022 | 0,025 | Sí |
| 6 | 0,031 | 0,030 | No |
| 7 | 0,044 | 0,035 | No |
| 8 | 0,061 | 0,040 | No |
| 9 | 0,204 | 0,045 | No |
| 10 | 0,450 | 0,050 | No |
El rango más alto que aún queda por debajo de su propio umbral es \(i=5\), así que el procedimiento rechaza las primeras 5 hipótesis (p-valores 0,001, 0,008, 0,012, 0,018 y 0,022), frente a solo 1 con Bonferroni o Holm. Fíjate en que el rango 6 (p = 0,031) falla su umbral aunque el rango 5 lo haya superado: BH busca el rango cualificado más grande en toda la lista ordenada, no se detiene simplemente en el primer fallo como hace el procedimiento escalonado de Holm.
Los mismos datos, tres números muy distintos de resultados “significativos”: 7 con el umbral bruto, 1 con Bonferroni o Holm, y 5 con BH. Esto muestra de forma muy concreta por qué elegir la corrección adecuada para tu pregunta de investigación real, FWER frente a FDR, importa tanto como corregir por comparaciones múltiples en primer lugar.
Aplicar la corrección en R
Los mismos diez p-valores de arriba, corregidos de las tres formas con una sola función incorporada:
pvalores <- c(0.001, 0.008, 0.012, 0.018, 0.022, 0.031, 0.044, 0.061, 0.204, 0.450)

p.adjust(pvalores, method = "bonferroni")   # la más simple y conservadora
p.adjust(pvalores, method = "holm")         # uniformemente más potente que Bonferroni
p.adjust(pvalores, method = "BH")           # Benjamini-Hochberg, controla FDR en vez de FWER

# Decisión con alfa = 0.05
data.frame(p = pvalores,
           bonferroni = p.adjust(pvalores, method = "bonferroni") < 0.05,
           holm       = p.adjust(pvalores, method = "holm")       < 0.05,
           BH         = p.adjust(pvalores, method = "BH")         < 0.05)
💡 Qué corrección usar
Usa Bonferroni solo cuando necesites la explicación más simple posible y tengas muy pocos contrastes (un puñado), o necesites una corrección que sea válida incluso bajo una dependencia desconocida o arbitraria entre los contrastes. En casi cualquier otro caso, prefiere el método de Holm frente a la Bonferroni simple: es estrictamente más potente, ofrece la misma garantía, y es igual de sencillo de aplicar. Para cribados exploratorios a gran escala, con muchas docenas o cientos de contrastes, donde puedas tolerar una fracción pequeña y controlada de falsos positivos entre tus hallazgos en lugar de protegerte frente a cualquiera de ellos, usa en su lugar Benjamini-Hochberg. La elección correcta depende de si un único falso positivo resultaría costoso (usa FWER: Bonferroni o Holm) o si lo que principalmente quieres controlar es la proporción global de pistas falsas entre tus hallazgos (usa FDR: Benjamini-Hochberg).

