Test HSD de Tukey
Tras un ANOVA significativo, solo sabemos que al menos una media de grupo difiere de las demás, no cuáles. El test HSD de Tukey (Diferencia Significativa Honesta) responde a esa pregunta, contrastando todas las comparaciones por pares de medias de grupo mientras controla la tasa de error de tipo I global (familiar) en el \(\alpha\) elegido. El test F global del ANOVA es un requisito previo: el HSD de Tukey solo tiene sentido una vez que ese test ya ha rechazado \(H_0\).
¿Por qué no aplicar directamente tests t por pares?
El problema de las comparaciones múltiples ya se introdujo en la entrada sobre el ANOVA, pero merece la pena ver los números exactos para este ejemplo. Con \(k=3\) grupos hay \(\binom{3}{2}=3\) comparaciones por pares posibles. Si cada una se contrasta con un test t independiente a \(\alpha=0,05\), la probabilidad de al menos un falso positivo entre las 3 comparaciones es:
\[1 - 0{,}95^3 \approx 0{,}143\]
Eso es casi tres veces la tasa nominal del 5%, solo por realizar tres tests sobre los mismos datos. En general, para \(m\) comparaciones independientes realizadas cada una al nivel \(\alpha\), la tasa de error familiar es \(1-(1-\alpha)^m\), que crece rápidamente: con 5 grupos hay \(\binom{5}{2}=10\) comparaciones y la tasa de error familiar supera el 40%. El HSD de Tukey soluciona esto usando un valor crítico más amplio, diseñado específicamente para este problema, de modo que la probabilidad de cualquier falso positivo entre todas las comparaciones se mantiene en \(\alpha\), sin importar cuántos pares se contrasten.
La distribución del rango estudentizado y la fórmula del HSD
El método de Tukey se basa en el estadístico del rango estudentizado \(q\), la distribución de (la mayor media de grupo menos la menor media de grupo) dividida entre el error estándar, en \(k\) grupos normales independientes. En lugar de comparar cada par frente al valor crítico t habitual, cada comparación se juzga frente al valor crítico de esta distribución del rango, que ya tiene en cuenta que se están comparando \(k\) medias simultáneamente.
Para tamaños de grupo iguales \(n\), la diferencia mínima entre dos medias necesaria para considerarse “significativa” es:
\[\text{HSD} = q_{\alpha,\,k,\,N-k} \sqrt{\frac{CM_D}{n}}\]
donde \(q_{\alpha,k,N-k}\) es el valor crítico de la distribución del rango estudentizado (\(k\) = número de grupos, \(N-k\) = grados de libertad residuales/dentro del ANOVA), y \(CM_D\) es el cuadrado medio dentro de grupos de la tabla ANOVA, la misma estimación de varianza combinada que usa el propio test F. Cualquier par de medias de grupo cuya diferencia absoluta supere el HSD se declara significativamente distinto.
El valor crítico del rango estudentizado \(q_{\alpha,k,N-k}\) es siempre mayor que el valor crítico t de dos muestras correspondiente, y crece con \(k\): comparar más grupos hace más difícil que un par concreto supere el umbral, que es exactamente la “penalización” que mantiene la tasa de error familiar en \(\alpha\) en lugar de dejar que se infle con cada comparación adicional. Cuando \(k=2\), solo hay una comparación posible y el test del rango estudentizado se reduce a un test t de dos muestras ordinario.
Aplicando el HSD de Tukey al ejemplo de las dietas
El ANOVA ya dijo que las tres dietas no son todas iguales; el HSD de Tukey es lo que concreta qué pares exactos provocan ese resultado:
Recordemos el ejemplo de pérdida de peso con tres dietas: Dieta A (\(n=5\), \(\bar y_A = 5{,}4\)), Dieta B (\(n=5\), \(\bar y_B = 8{,}4\)), Dieta C (\(n=5\), \(\bar y_C = 2{,}8\)). La tabla ANOVA dio \(CM_D = 1{,}100\) con \(gl_D = N-k = 12\), y el test F global ya era significativo (\(F=35{,}70\), \(p<0,001\)), por lo que una comparación post-hoc está justificada.
El valor crítico de la distribución del rango estudentizado para \(k=3\) grupos y \(gl_D=12\) a \(\alpha=0,05\) es \(q_{0,05,3,12} = 3{,}773\).
\[\text{HSD} = 3{,}773 \times \sqrt{\frac{1{,}100}{5}} = 3{,}773 \times 0{,}4690 = 1{,}770\]
Cualquier diferencia por pares en valor absoluto mayor que 1,770 kg es estadísticamente significativa a \(\alpha=0,05\).
| Comparación | Diferencia | IC 95% | ¿Significativa? |
|---|---|---|---|
| B \(-\) A | 3,0 | (1,230, 4,770) | Sí (\(p=0,0019\)) |
| C \(-\) A | \(-2,6\) | (\(-4,370\), \(-0,830\)) | Sí (\(p=0,0053\)) |
| C \(-\) B | \(-5,6\) | (\(-7,370\), \(-3,830\)) | Sí (\(p<0,0001\)) |
Las tres diferencias por pares superan 1,770 kg en valor absoluto, así que las tres son significativas: la dieta B produce una pérdida de peso significativamente mayor que la dieta A, que a su vez supera significativamente a la dieta C. Las tres dietas forman un orden estricto, no solo “al menos una difiere”.

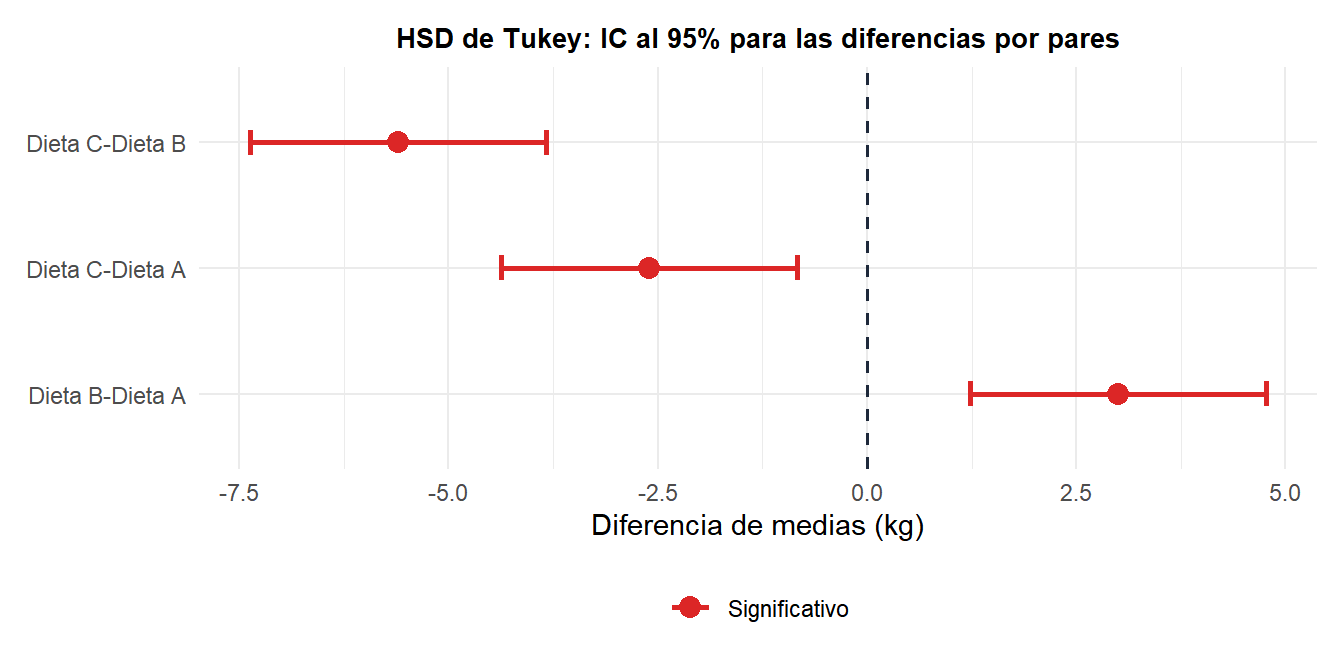
Los tres marcadores aparecen en rojo porque cada intervalo queda enteramente a un lado del 0: ninguna de las tres comparaciones se acerca a la línea de referencia discontinua, lo que es coherente con tres dietas claramente separadas en cuanto a efecto, no solo distinguibles por poco en el umbral \(\alpha=0,05\).
Interpretar directamente el intervalo de confianza
Un intervalo de confianza por pares que excluye el 0 equivale exactamente a que ese par sea significativo. Para B \(-\) A, el intervalo (1,230, 4,770) excluye el 0, lo que confirma la significación sin necesidad siquiera de mirar el p-valor. El intervalo además indica el rango plausible del tamaño real del efecto: la dieta B supera a la dieta A entre aproximadamente 1,2 y 4,8 kg, información que el p-valor por sí solo nunca revela. La misma lógica se aplica a las otras dos comparaciones: ningún intervalo contiene el 0, así que ambas son significativas, y ambas ofrecen un rango concreto para el tamaño de la diferencia.
Supuestos
Dado que el HSD de Tukey reutiliza la estimación de varianza combinada del modelo ANOVA, \(CM_D\), hereda todos los supuestos del ANOVA:
- Independencia: las observaciones son independientes dentro de cada grupo y entre grupos.
- Normalidad: los residuos son aproximadamente normales dentro de cada grupo, verificada con el test de Shapiro-Wilk o gráficos Q-Q.
- Homocedasticidad: varianzas iguales entre grupos, verificada con el test de Levene. Este supuesto es el que más importa específicamente para el HSD de Tukey, ya que cada comparación usa el mismo \(CM_D\) combinado como estimación de la varianza. Si un grupo es realmente más variable que los demás, las comparaciones que lo incluyen reciben una estimación de dispersión demasiado pequeña o demasiado grande, lo que distorsiona la amplitud de cada intervalo HSD que lo involucra.
Los tamaños de grupo desiguales se gestionan con una variante, el método de Tukey-Kramer, que sustituye \(\sqrt{CM_D/n}\) por:
\[\sqrt{\frac{CM_D}{2}\left(\frac{1}{n_i}+\frac{1}{n_j}\right)}\]
para cada par concreto \(i,j\), de modo que los pares que incluyen grupos más pequeños obtienen automáticamente un intervalo más amplio y conservador.
⚠️ El HSD de Tukey no es la única opción post-hoc, y la elección importa
El HSD de Tukey está diseñado específicamente para todas las comparaciones por pares y es la opción más potente exactamente para ese escenario. Si solo interesa comparar cada grupo con un único grupo de referencia o control (no todos los pares entre sí), el test de Dunnett es más potente porque no “paga” por comparaciones que no se necesitan. Si es necesario contrastar contrastes más generales y no por pares (por ejemplo, “¿difiere el promedio de A y B de C?”), el método de Scheffé es la opción apropiada, más conservadora. La corrección de Bonferroni también sirve para comparaciones por pares, pero en general es más conservadora (menos potente) que el HSD de Tukey para este uso concreto, ya que el método de Tukey está adaptado exactamente al escenario de todas las medias por pares, mientras que Bonferroni es una corrección genérica válida para cualquier conjunto de tests.
Realizar el test en R
TukeyHSD() toma directamente un objeto aov() ya ajustado y devuelve todas las comparaciones por pares con su intervalo de confianza y p-valor ajustados:
perdida <- c(4,5,6,5,7, 8,7,9,10,8, 3,2,4,3,2)
dieta <- factor(rep(c("A","B","C"), each = 5))

fit <- aov(perdida ~ dieta)
summary(fit)          # confirma primero que el test F global es significativo
TukeyHSD(fit)          # comparaciones por pares con IC al 95%
plot(TukeyHSD(fit))    # gráfico base R de los intervalos

# Verificación manual del valor crítico
qtukey(0.95, nmeans = 3, df = 12)   # = 3.773
TukeyHSD() devuelve las columnas diff, lwr y upr para cada comparación por pares, con la diferencia de medias y su intervalo de confianza al 95%, además de una columna p adj ya ajustada por el número de comparaciones, que puede compararse directamente con \(\alpha\) sin necesidad de ninguna corrección adicional. plot(TukeyHSD(fit)) dibuja el mismo tipo de gráfico de intervalos mostrado antes usando los gráficos base de R.
💡 El orden correcto de las operaciones
Nunca apliques el HSD de Tukey (ni ningún otro test post-hoc) antes de comprobar que el test F global del ANOVA es significativo. Si el ANOVA no rechaza \(H_0\), no hay ninguna afirmación de “al menos un grupo difiere” que desglosar, y contrastar formalmente las comparaciones por pares de todos modos anula por completo el propósito de controlar la tasa de error familiar: simplemente volverías al problema de comparaciones múltiples sin corregir que el ANOVA pretendía evitar.

