Distribución multinomial
La distribución multinomial generaliza la distribución binomial de dos resultados por ensayo a cualquier número fijo de categorías. A lo largo de \(n\) ensayos independientes, cada uno cayendo en exactamente una de \(k\) categorías con probabilidades fijas, da la probabilidad conjunta de observar una combinación concreta de recuentos por categoría.
Definición
Un vector aleatorio \((X_1, X_2, \ldots, X_k)\) sigue una distribución multinomial con parámetros \(n\) (número de ensayos) y \(p_1, p_2, \ldots, p_k\) (probabilidades de cada categoría, que suman 1), escrito \((X_1,\ldots,X_k) \sim \text{Multinomial}(n, p_1,\ldots,p_k)\), si:
\[P(X_1=x_1,\ldots,X_k=x_k) = \frac{n!}{x_1!\, x_2! \cdots x_k!}\, p_1^{x_1} p_2^{x_2} \cdots p_k^{x_k}, \quad \sum_{i=1}^k x_i = n\]
Cada \(X_i\) cuenta cuántos de los \(n\) ensayos cayeron en la categoría \(i\). Los recuentos no son libres de variar de forma independiente: como cada ensayo cae en exactamente una categoría, siempre deben sumar el total fijo \(n\). Cuando \(k=2\), esto se reduce exactamente a la distribución binomial, siendo \(X_1\) el habitual “número de éxitos” y \(X_2 = n - X_1\) el número de fracasos.
Propiedades
Para \((X_1,\ldots,X_k) \sim \text{Multinomial}(n, p_1,\ldots,p_k)\):
- Distribución marginal
Cada \(X_i\) individual, por sí sola, sigue una distribución binomial: \(X_i \sim \text{Binomial}(n, p_i)\). Cada ensayo o bien cae en la categoría \(i\) (un “éxito” con probabilidad \(p_i\)) o bien cae en alguna otra categoría (un “fracaso” con probabilidad \(1-p_i\)), que es exactamente el planteamiento binomial.
- Valor esperado
\[E(X_i) = np_i\]
- Varianza
\[\text{Var}(X_i) = np_i(1-p_i)\]
Idéntica a la varianza binomial, ya que la distribución marginal es binomial.
- Covarianza entre categorías
\[\text{Cov}(X_i, X_j) = -np_ip_j, \quad i \neq j\]
Esta covarianza siempre es negativa. Como cada ensayo cae en exactamente una categoría, los recuentos compiten por el mismo total fijo \(n\): si caen más ensayos de los esperados en la categoría \(i\), quedan estrictamente menos disponibles para la categoría \(j\). Las categorías no pueden subir o bajar juntas, así que tratarlas como binomiales independientes e ignorar esta correlación negativa da un comportamiento conjunto equivocado.
Ejemplo resuelto: clientes eligiendo entre tres productos
Poner un número tanto a la probabilidad conjunta de un resultado concreto como a la covarianza negativa entre categorías hace tangibles las dos propiedades de arriba.
Una empresa sabe que, históricamente, los clientes eligen entre tres productos A, B y C con probabilidades \(p = (0{,}5,\ 0{,}3,\ 0{,}2)\). Se observa una muestra de \(n=50\) clientes independientes, y el reparto exacto resulta ser 28 que eligen A, 14 que eligen B, y 8 que eligen C.
La probabilidad conjunta de este reparto exacto:
\[P(X_A=28, X_B=14, X_C=8) = \frac{50!}{28!\,14!\,8!}(0{,}5)^{28}(0{,}3)^{14}(0{,}2)^{8} \approx 0{,}0129\]
Mirando solo el producto A por separado, su distribución marginal es \(X_A \sim \text{Binomial}(50;\, 0{,}5)\), con \(E(X_A) = 25\) y \(\text{Var}(X_A) = 12{,}5\). Observar 28 son 3 por encima del recuento esperado de 25, una probabilidad de \(P(X_A=28) \approx 0{,}0788\) de categoría única bajo esa binomial marginal.
La covarianza negativa se ve inmediatamente en los datos: \(\text{Cov}(X_A,X_B) = -50 \times 0{,}5 \times 0{,}3 = -7{,}5\), \(\text{Cov}(X_A,X_C) = -50 \times 0{,}5 \times 0{,}2 = -5\), y \(\text{Cov}(X_B,X_C) = -50 \times 0{,}3 \times 0{,}2 = -3\). Una simulación directa de 200.000 extracciones de esta multinomial lo confirma: las covarianzas empíricas salen en \(-7{,}508\), \(-5{,}066\) y \(-2{,}979\), muy cerca de los valores teóricos, y la correlación empírica entre \(X_A\) y \(X_B\) por sí sola es de unos \(-0{,}654\), una relación negativa fuerte impulsada enteramente por la restricción del total fijo.

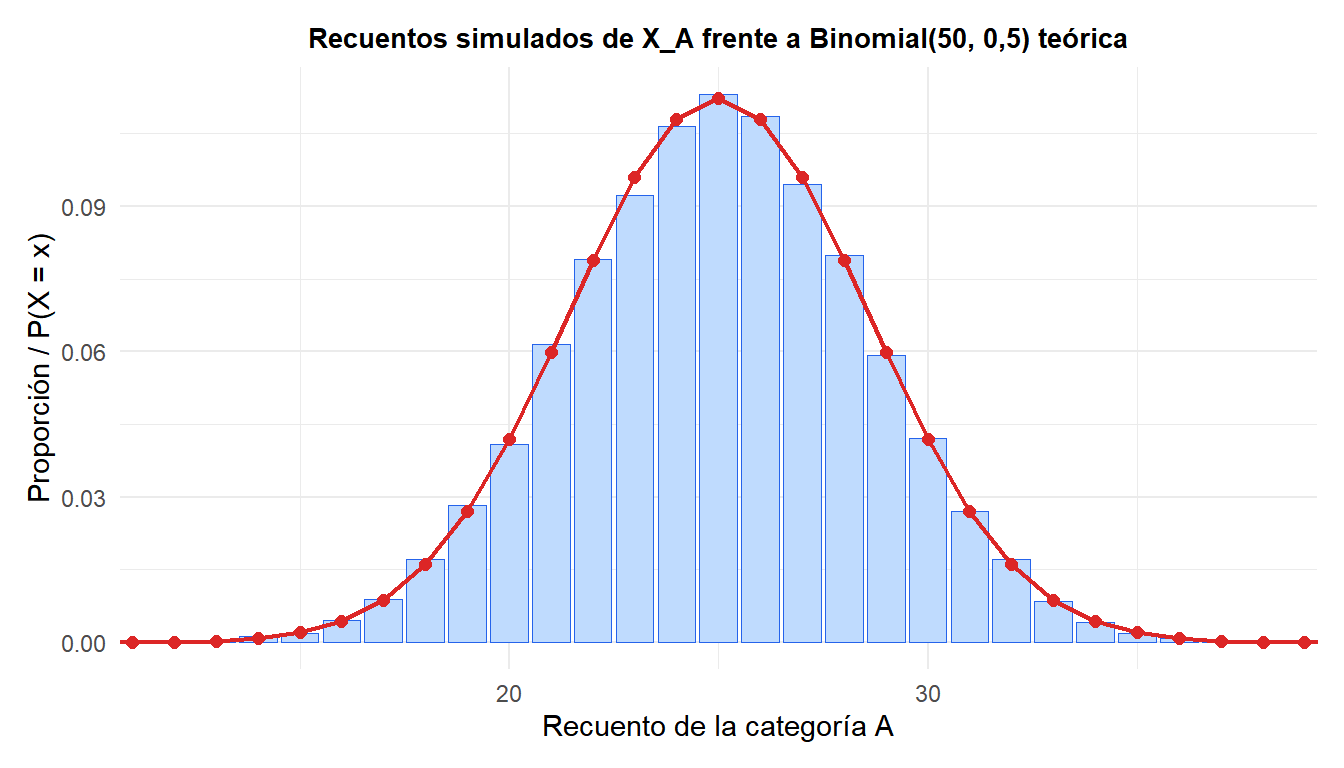
Las barras azules son las frecuencias simuladas del recuento de la categoría A a lo largo de 50.000 extracciones multinomiales independientes. La curva roja es la PMF teórica exacta de \(\text{Binomial}(50, 0{,}5)\). Coinciden prácticamente a la perfección, confirmando la propiedad marginal: al mirar cualquier categoría aislada, la multinomial se comporta exactamente como una binomial.
⚠️ Las categorías no son binomiales independientes
Cada \(X_i\) es individualmente binomial, pero \((X_1,\ldots,X_k)\) en conjunto no es un grupo de binomiales independientes, la covarianza negativa de arriba es real e ignorarla es un error habitual. Esto importa sobre todo al contrastar si los recuentos observados por categoría encajan con unas probabilidades hipotetizadas: la herramienta estándar es un test chi-cuadrado de bondad de ajuste, que tiene en cuenta correctamente que los recuentos deben sumar \(n\), en vez de hacer \(k\) tests binomiales independientes por separado.
Hacerlo en R
R base cubre la probabilidad exacta, la simulación y el test de bondad de ajuste sin necesitar ningún paquete extra:
p <- c(0.5, 0.3, 0.2)
n <- 50

# Probabilidad conjunta exacta de un vector de recuentos concreto
dmultinom(c(28, 14, 8), size = n, prob = p)

# Simular muchas extracciones
sims <- t(rmultinom(10000, size = n, prob = p))

# Contrastar los recuentos observados frente a las probabilidades hipotetizadas
chisq.test(c(28, 14, 8), p = p)
💡 Dónde aparece la multinomial en la práctica
Las respuestas de encuestas con más de dos opciones, las tiradas de dados a lo largo de sus seis caras, los recuentos de palabras o tokens en un documento (la base del clasificador naive Bayes para texto), y las frecuencias alélicas entre más de dos variantes genéticas son escenarios multinomiales clásicos. Cada vez que los resultados caen en una de varias categorías fijas a lo largo de ensayos independientes repetidos, la multinomial es la distribución conjunta natural para los recuentos por categoría.