Estimación máxima verosímil
La estimación máxima verosímil (MLE, del inglés maximum likelihood estimation) es el método más usado para estimar los parámetros de una distribución: elige los valores de los parámetros que hacen que los datos realmente observados sean lo más probables posible. Está por debajo de más cosas de esta web de lo que parece, la regresión logística se ajusta por MLE, no minimizando el error cuadrático.
La función de verosimilitud
Para observaciones independientes e idénticamente distribuidas \(x_1, x_2, \ldots, x_n\) de una distribución con parámetro \(\theta\) y función de densidad o masa \(f(x;\theta)\), la verosimilitud es la probabilidad conjunta de los datos observados, vista como función de \(\theta\) con los datos fijos:
\[L(\theta) = \prod_{i=1}^n f(x_i; \theta)\]
Esto supone un giro conceptual respecto a cómo funciona normalmente la probabilidad. Una función de probabilidad pregunta: dados estos parámetros, ¿cuán probables son estos datos? Una función de verosimilitud pregunta lo contrario: dados estos datos, ¿cómo cambia su probabilidad al variar los parámetros? La estimación máxima verosímil \(\hat\theta\) es el valor de \(\theta\) que maximiza \(L(\theta)\).
Por qué la log-verosimilitud
Los productos de muchas probabilidades pequeñas producen desbordamientos numéricos y son incómodos de derivar. Tomar logaritmos convierte el producto en una suma sin cambiar dónde está el máximo, ya que el logaritmo es una función estrictamente creciente:
\[\ell(\theta) = \log L(\theta) = \sum_{i=1}^n \log f(x_i; \theta)\]
En la práctica, siempre se maximiza \(\ell(\theta)\), nunca \(L(\theta)\) directamente.
Ejemplo resuelto 1: MLE para una proporción Bernoulli
El caso más sencillo posible, una moneda, ya muestra el mecanismo completo: escribir la verosimilitud, derivar e igualar a cero.
Se lanza una moneda 10 veces, registrando 1 para cara y 0 para cruz: \(1,0,1,1,0,1,1,1,0,1\) (7 caras de 10). Para datos Bernoulli(\(p\)) i.i.d., la verosimilitud y la log-verosimilitud son:
\[L(p) = p^{\sum x_i}(1-p)^{n-\sum x_i}, \qquad \ell(p) = \Big(\sum x_i\Big)\log p + \Big(n-\sum x_i\Big)\log(1-p)\]
Se deriva respecto a \(p\) y se iguala a cero:
\[\frac{d\ell}{dp} = \frac{\sum x_i}{p} - \frac{n - \sum x_i}{1-p} = 0\]
Al despejar se obtiene el estimador máximo verosímil:
\[\hat{p}_{MLE} = \frac{\sum x_i}{n}\]
Para estos datos: \(n=10\), \(\sum x_i = 7\), así que \(\hat p_{MLE} = 7/10 = 0{,}7\). Es exactamente la proporción muestral: el estimador “obvio” resulta ser el estimador máximo verosímil.

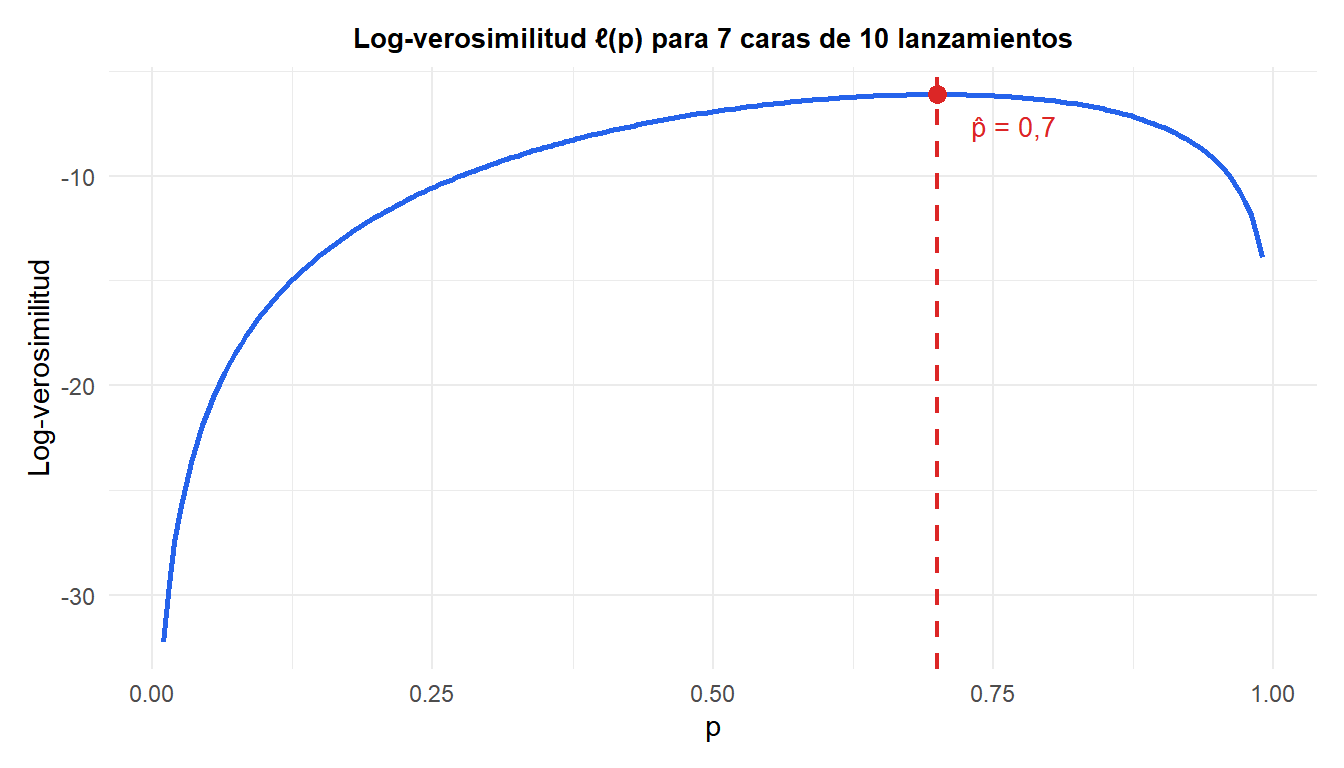
La curva alcanza su máximo exactamente en \(\hat p = 0{,}7\): ningún otro valor de \(p\) hace más probable esta secuencia concreta de 7 caras y 3 cruces.
Ejemplo resuelto 2: MLE para una distribución Normal
Con dos parámetros que estimar a la vez, la misma lógica de maximización produce una fórmula de la media muy conocida y una fórmula de la varianza menos conocida, y sesgada.
Diez mediciones: \(4{,}2, 5{,}1, 3{,}8, 4{,}9, 5{,}5, 4{,}4, 4{,}7, 5{,}0, 4{,}1, 4{,}6\). Para datos \(N(\mu, \sigma^2)\) i.i.d., maximizar la log-verosimilitud respecto a \(\mu\) y \(\sigma^2\) da:
\[\hat\mu_{MLE} = \bar{x} = \frac{1}{n}\sum x_i \qquad \hat\sigma^2_{MLE} = \frac{1}{n}\sum (x_i - \bar{x})^2\]
Calculado sobre los datos: \(n=10\), \(\hat\mu_{MLE} = 4{,}63\), \(\hat\sigma^2_{MLE} = 0{,}2401\), así que \(\hat\sigma_{MLE} = 0{,}49\). La log-verosimilitud en este máximo es \(\ell(\hat\mu,\hat\sigma^2) = -7{,}056\).
⚠️ La varianza MLE está sesgada: divide entre n, no entre n-1
\(\hat\sigma^2_{MLE} = 0{,}2401\) divide la suma de desviaciones al cuadrado entre \(n=10\). La conocida varianza muestral insesgada del post de desviación típica y varianza divide en cambio entre \(n-1=9\), dando \(s^2 = 0{,}2668\) con los mismos datos, notablemente mayor.
Los estimadores máximo verosímiles no son automáticamente insesgados. Maximizar la verosimilitud y minimizar el sesgo son objetivos distintos que coinciden para algunos parámetros, como la media, pero no para otros, como la varianza. Consulta el post de qué es un estimador para el marco completo de insesgadez/consistencia/eficiencia con el que conecta esto. En la práctica, para muestras genuinamente pequeñas suele preferirse la versión insesgada con \(n-1\) para la varianza; el sesgo de la versión MLE se reduce a medida que crece \(n\), y ambas versiones convergen.
MLE y mínimos cuadrados: cuándo coinciden
Para un modelo de regresión lineal con errores normalmente distribuidos, maximizar la verosimilitud respecto a los coeficientes da exactamente las mismas estimaciones que los mínimos cuadrados ordinarios. Por eso la regresión MCO puede justificarse de dos formas, como minimizar el error cuadrático o como maximizar la verosimilitud bajo errores normales: en ese caso concreto son el mismo problema de optimización.
Para modelos donde la respuesta no se distribuye normalmente, resultados binarios, conteos, etc., los mínimos cuadrados ya no se aplican con limpieza y se usa MLE directamente en su lugar. Por eso la regresión logística se ajusta mediante MLE y no minimizando el error cuadrático.
Propiedades del MLE para muestras grandes
Bajo condiciones de regularidad habituales, cuando \(n \to \infty\) el estimador máximo verosímil es:
- Consistente: converge al valor verdadero del parámetro.
- Asintóticamente insesgado: cualquier sesgo en muestra finita se reduce hacia cero.
- Asintóticamente normal: su distribución muestral se aproxima a una distribución normal.
- Asintóticamente eficiente: alcanza la menor varianza posible entre los estimadores consistentes, la cota inferior de Cramér-Rao.
Son garantías para muestras grandes, no para muestras finitas. Por eso el MLE de Bernoulli anterior es insesgado para cualquier \(n\), mientras que el MLE de la varianza Normal está sesgado para cualquier \(n\) finito: ambas propiedades son coherentes con la misma teoría asintótica, que solo promete buen comportamiento a medida que \(n\) crece.
Ejecutarlo en R
Los dos ejemplos resueltos arriba caben en pocas líneas: el caso Bernoulli se reduce a una media, y el caso Normal puede resolverse tanto en forma cerrada como con un optimizador numérico de propósito general.
# MLE de Bernoulli: simplemente la proporción muestral
lanzamientos <- c(1,0,1,1,0,1,1,1,0,1)
p_hat <- mean(lanzamientos)

# MLE Normal mediante optimización numérica (enfoque general)
x <- c(4.2, 5.1, 3.8, 4.9, 5.5, 4.4, 4.7, 5.0, 4.1, 4.6)
neg_loglik <- function(par) {
  mu <- par[1]; sigma <- par[2]
  -sum(dnorm(x, mean = mu, sd = sigma, log = TRUE))
}
fit <- optim(par = c(mean(x), sd(x)), fn = neg_loglik)
fit$par   # coincide exactamente con mean(x) y sqrt(mean((x-mean(x))^2))

# Ajuste MLE de propósito general
library(MASS)
fitdistr(x, "normal")
💡 El MLE en la práctica: casi siempre invisible, siempre por debajo
La mayoría de las veces nunca se llama a un optimizador MLE directamente. glm() para la regresión logística, fitdistr(), e incontables funciones más de R ejecutan MLE por debajo cuando informan de coeficientes y errores estándar. Saber esto explica por qué esas funciones piden una familia de distribución (family = binomial, etc.): esa elección determina la función de verosimilitud que se está maximizando. La regresión logística es el lugar donde más visitantes de esta web se van a encontrar con el MLE en la práctica sin necesariamente ponerle nombre.

