Intervalo de confianza frente a intervalo de predicción
Un intervalo de confianza estima dónde está en realidad un parámetro poblacional, como la media verdadera \(\mu\). Un intervalo de predicción estima dónde caerá una única observación futura. El segundo siempre es más ancho, a menudo mucho más ancho, porque tiene que tener en cuenta tanto la incertidumbre al estimar el parámetro como la variabilidad natural de las observaciones individuales alrededor de él.
Las dos fórmulas, una junto a la otra
Para una muestra de tamaño \(n\) de una población normal, con media muestral \(\bar{x}\) y desviación típica muestral \(S\):
\[\text{IC para } \mu: \quad \bar{x} \pm t_{\alpha/2,\,n-1} \cdot \frac{S}{\sqrt{n}}\]
\[\text{IP para una nueva observación}: \quad \bar{x} \pm t_{\alpha/2,\,n-1} \cdot S\sqrt{1 + \frac{1}{n}}\]
Las dos fórmulas comparten el mismo centro y el mismo valor crítico \(t_{\alpha/2,\,n-1}\), la única diferencia está en lo que hay dentro de la raíz cuadrada. El error estándar del intervalo de confianza, \(S/\sqrt{n}\), solo recoge con qué precisión \(\bar{x}\) estima \(\mu\). El intervalo de predicción añade un “+1” dentro de la raíz, que es exactamente la varianza extra de una nueva observación individual alrededor de la media real, una fuente de incertidumbre que no tiene nada que ver con el tamaño de la muestra.
Ese “+1” es toda la historia: cuando \(n \to \infty\), \(S/\sqrt{n} \to 0\) y el intervalo de confianza se colapsa hacia un único punto, pero \(S\sqrt{1 + 1/n} \to S\), así que el intervalo de predicción se estrecha solo un poco y se asienta en una anchura mínima fijada por la dispersión propia de la población. Ninguna cantidad de datos adicionales hará nunca que una única observación futura sea perfectamente predecible.
Ejemplo resuelto: una media muestral
Los dos intervalos parten exactamente de la misma muestra, lo único que cambia es qué pregunta se le está haciendo.
Una muestra de \(n=25\) mediciones de tiempo de reacción da \(\bar{x} = 255,63\) ms y \(S = 39,19\) ms. Con \(t_{0,025,\,24} = 2,064\):
| Fórmula | Intervalo | Anchura | |
|---|---|---|---|
| IC del 95% para \(\mu\) | \(255,63 \pm 2,064 \times 39,19/\sqrt{25}\) | [239,45, 271,80] | 32,35 |
| IP del 95% para un nuevo valor | \(255,63 \pm 2,064 \times 39,19\sqrt{1+1/25}\) | [173,14, 338,11] | 164,98 |
El intervalo de predicción es unas 5,1 veces más ancho que el intervalo de confianza, para exactamente la misma muestra. El intervalo de confianza dice “el tiempo de reacción medio real está casi con seguridad entre 239 y 272 ms”. El intervalo de predicción dice algo mucho más amplio: “una nueva medición individual de este proceso podría situarse de forma plausible en cualquier punto entre 173 y 338 ms”. Las dos afirmaciones son correctas, simplemente responden a preguntas distintas.

La misma distinción en regresión
La diferencia entre los dos intervalos se ve más fácilmente en una regresión lineal simple, donde ambos se pueden leer sobre la misma recta ajustada en cualquier valor de \(x\).
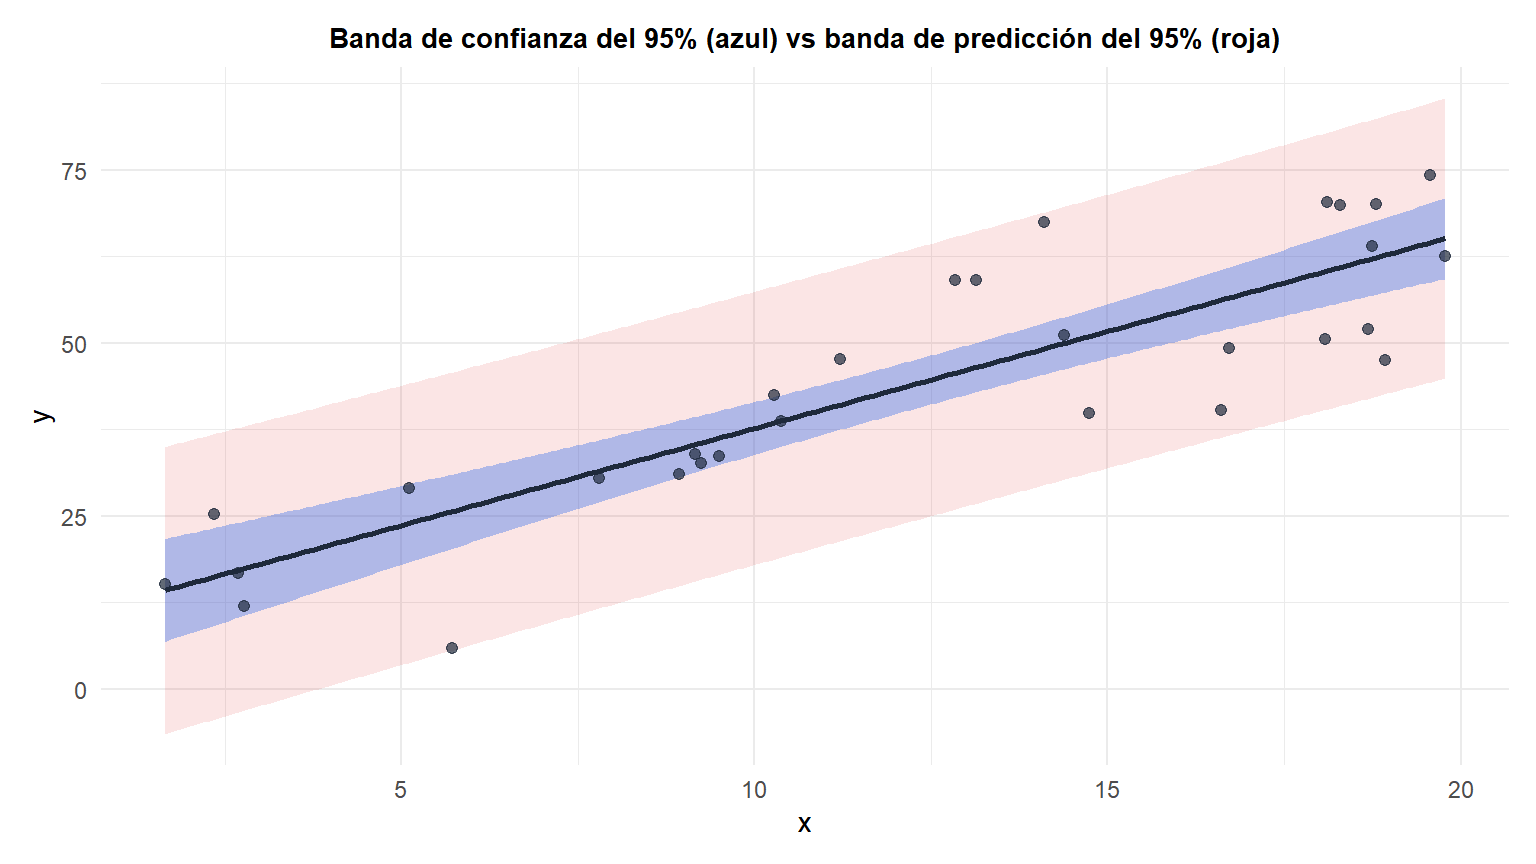
En \(x = 10\), el valor ajustado es \(\hat{y} = 41,30\): el intervalo de confianza del 95% para la respuesta media es \([38,33, 44,26]\), anchura 5,93, mientras que el intervalo de predicción del 95% para una nueva respuesta individual es \([25,22, 57,38]\), anchura 32,16, unas 5,4 veces más ancho. La banda azul, estrecha, se ciñe a la recta ajustada casi en todas partes; la banda roja es ancha incluso cerca del centro de los datos, porque tiene que cubrir dónde podría caer un nuevo punto, no solo dónde está la recta media.
Por qué confundirlos es un error con consecuencias
Elegir mal entre los dos no es un error cosmético, cambia cuánta incertidumbre se traslada realmente a quien toma una decisión a partir de ello.
⚠️ Un intervalo de confianza estrecho puede crear una falsa sensación de seguridad sobre un caso futuro
Informar de un intervalo de confianza cuando una decisión depende de una única observación futura infravalora de forma sistemática la incertidumbre real. Una previsión de demanda con un IC del 95% estrecho alrededor de las ventas medias del mes que viene parece tranquilizadora, pero si la decisión real es “cuánto inventario necesitamos para no quedarnos sin stock el mes que viene”, el rango relevante es el intervalo de predicción para ese mes concreto, que puede ser varias veces más ancho. Usar ahí el IC elimina en silencio la mayor parte del riesgo real del panorama.
Hacerlo en R
En una regresión, los dos intervalos salen de la misma llamada a predict(), solo cambiando el argumento interval:
fit <- lm(y ~ x, data = df)

predict(fit, newdata = data.frame(x = 10), interval = "confidence", level = 0.95)
predict(fit, newdata = data.frame(x = 10), interval = "prediction", level = 0.95)
Para una media muestral simple (sin regresión), R base tiene una función de una línea para el intervalo de confianza pero no para el de predicción, que hay que calcular directamente con la fórmula:
t.test(x)$conf.int                 # IC del 95% para la media

n <- length(x)
tcrit <- qt(0.975, df = n - 1)
xbar  <- mean(x); s <- sd(x)
pi_lo <- xbar - tcrit * s * sqrt(1 + 1/n)   # IP del 95% para una nueva observacion
pi_hi <- xbar + tcrit * s * sqrt(1 + 1/n)
💡 La idea clave a medida que crece n
A medida que aumenta el tamaño de la muestra, el intervalo de confianza sigue estrechándose hacia una anchura cero, en principio se puede acotar \(\mu\) con la precisión que se quiera con suficientes datos. El intervalo de predicción hace lo contrario: se estrecha solo un poco y converge hacia un mínimo fijado por \(S\), la dispersión propia de la población, que ninguna cantidad de datos adicionales puede eliminar. Si la pregunta es sobre el parámetro, más datos es la respuesta. Si la pregunta es sobre un caso futuro concreto, hay un límite a cuánta más certeza se puede conseguir.