Cointegración y VECM
Dos series individualmente no estacionarias pueden seguir moviéndose juntas de forma estable a largo plazo, compartiendo lo que se llama una tendencia estocástica común. Cuando eso ocurre, están cointegradas, y modelarlas por separado, o ajustar un VAR directamente sobre sus niveles brutos, desperdicia información real sobre esa relación a largo plazo, o algo peor, produce una regresión espuria. Esta entrada explica cómo contrastar la cointegración y cómo modelarla correctamente con un modelo vectorial de corrección del error (VECM).
Antes de aplicar nada de esto, ambas series deben mostrar primero que tienen raíz unitaria de forma individual, consulta el test de Dickey-Fuller y el post general de estacionariedad para ese primer paso.
Qué significa la cointegración
Si \(x_t\) e \(y_t\) son ambas \(I(1)\) (integradas de orden 1: no estacionarias, pero estacionarias tras una diferenciación), están cointegradas si alguna combinación lineal de ambas es en sí misma estacionaria, \(I(0)\). De forma intuitiva: ambas series pueden derivar sin límite por su cuenta, como dos paseos aleatorios independientes, pero una combinación lineal concreta de ambas se mantiene anclada y nunca se aleja demasiado de cero, porque comparten la misma tendencia estocástica subyacente.
\[x_t, y_t \sim I(1), \qquad y_t - \beta x_t \sim I(0)\]
\(\beta\) es el coeficiente de cointegración, y \(y_t - \beta x_t\) (o, de forma más general, incluyendo una constante, \(y_t - \beta x_t - \alpha\)) es la relación de cointegración, interpretable como el equilibrio a largo plazo al que están ancladas ambas series. Ejemplos clásicos del mundo real: precios de contado y de futuros de la misma materia prima, consumo y renta, tipos de cambio vinculados por la paridad del poder adquisitivo.
El método en dos pasos de Engle-Granger
La forma más sencilla de contrastar y estimar la cointegración entre exactamente dos series.
Paso 1: regresiona \(y_t\) sobre \(x_t\) por MCO y guarda los residuos:
\[\hat u_t = y_t - \hat\alpha - \hat\beta x_t\]
Paso 2: contrasta si los residuos \(\hat u_t\) son estacionarios usando un test de tipo ADF. Si lo son, \(x_t\) e \(y_t\) están cointegradas, la relación de MCO ES la relación de cointegración. Si los residuos siguen teniendo raíz unitaria, no hay evidencia de cointegración.
⚠️ El paso 2 de Engle-Granger necesita sus propios valores críticos, no la tabla ADF estándar
Los residuos \(\hat u_t\) proceden de una regresión ESTIMADA, los MCO ya eligieron \(\hat\alpha, \hat\beta\) para ajustar los datos lo mejor posible, así que contrastarlos con los valores críticos de Dickey-Fuller habituales es demasiado permisivo: encontrará “estacionariedad” (rechazará la raíz unitaria) con más frecuencia de la debida, solo por este efecto de estimación. Engle y Granger obtuvieron valores críticos propios, más estrictos (refinados después por MacKinnon), específicamente para contrastar los residuos de una regresión de cointegración. Las funciones diseñadas para esto, como tseries::po.test(), aplican los valores críticos correctos automáticamente. Un adf.test() genérico sobre los residuos usa técnicamente la distribución de referencia equivocada, aunque un estadístico muy negativo, como en el ejemplo resuelto siguiente, suele superar igualmente incluso el umbral más estricto.
Ejemplo resuelto: dos series que comparten una tendencia común
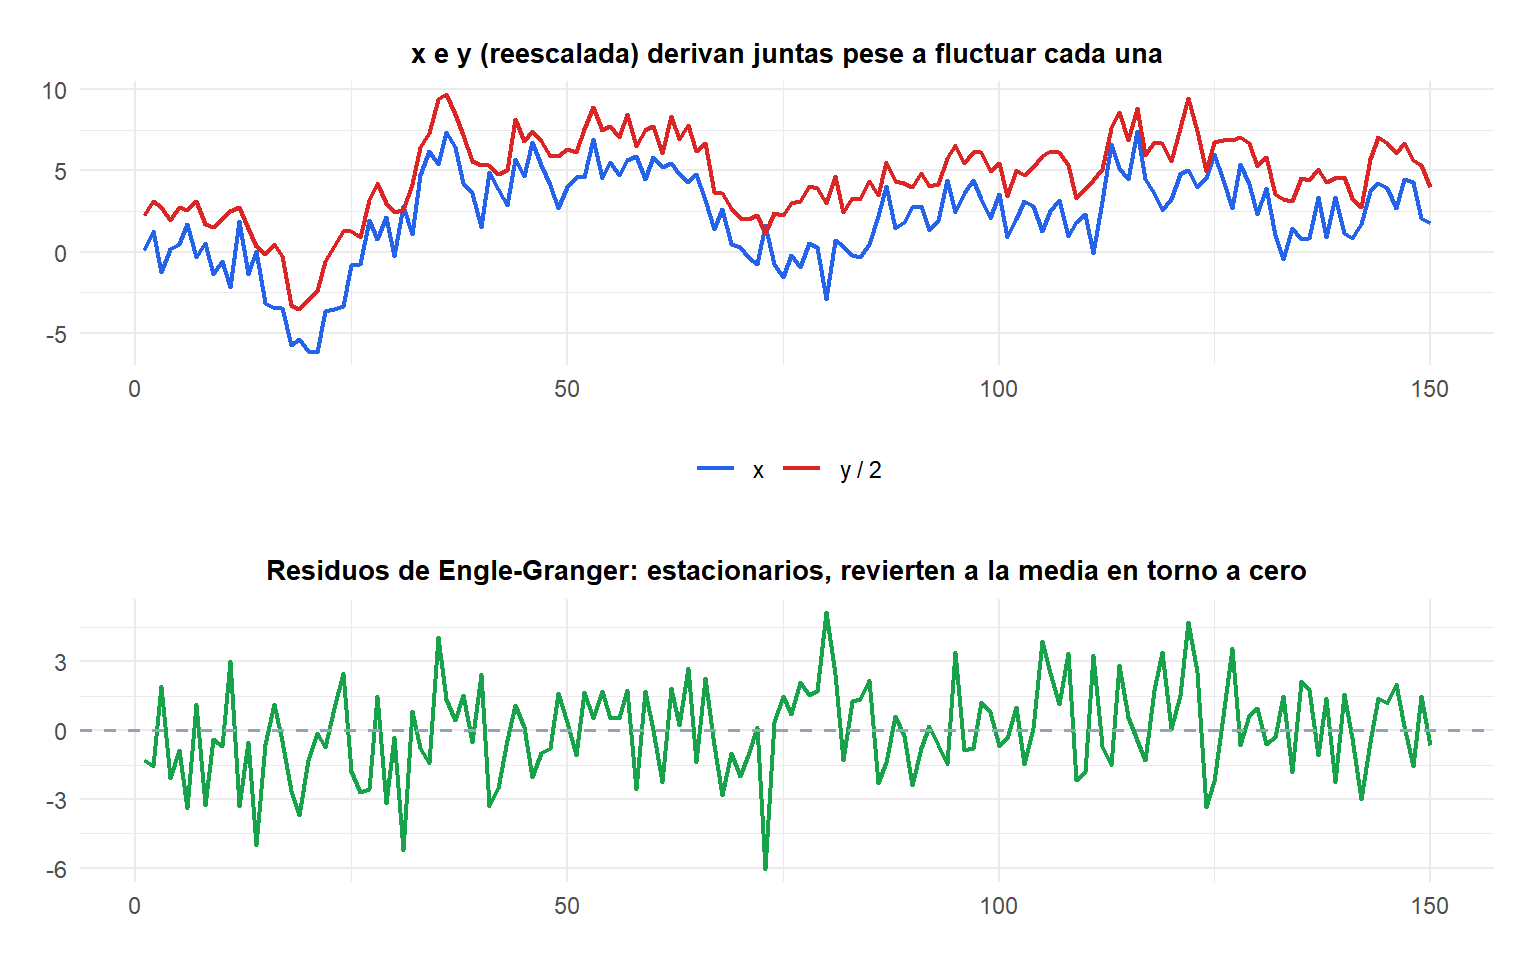
Se simulan dos series que comparten una única tendencia común de paseo aleatorio, así que están cointegradas por construcción:
set.seed(5)
T <- 150
common_trend <- cumsum(rnorm(T))
x <- common_trend + rnorm(T, 0, 1)
y <- 2*common_trend + 5 + rnorm(T, 0, 1)
Por separado, ambas series son no estacionarias. Test ADF sobre \(x\): estadístico \(-2{,}45\), \(p = 0{,}389\), no se rechaza la raíz unitaria. Test ADF sobre \(y\): estadístico \(-2{,}26\), \(p = 0{,}467\), no se rechaza la raíz unitaria. Ninguna de las dos series es estacionaria por sí sola.
Paso 1 de Engle-Granger: regresión MCO de \(y\) sobre \(x\):
\[\hat y_t = 5{,}659 + 1{,}679\, x_t\]
Ambos coeficientes son muy significativos (\(p < 0{,}001\)), \(R^2 = 0{,}845\).
Paso 2 de Engle-Granger: test ADF sobre los residuos de la regresión \(\hat u_t\), usando la especificación sin constante y con 1 retardo (urca::ur.df(resid, type = "none", lags = 1)): estadístico \(= -8{,}286\). Es mucho más negativo que incluso el valor crítico estricto al 1% para esta especificación (\(-2{,}58\)), así que se rechaza de forma contundente la raíz unitaria en los residuos.
Conclusión: \(x\) e \(y\) están cointegradas, exactamente como se construyó en la simulación, ya que ambas series comparten la única tendencia común.

El test de Johansen: una segunda comprobación independiente
El método de Engle-Granger solo maneja exactamente 2 series y trata a una de ellas como “dependiente” de forma arbitraria. El test de Johansen es más general: funciona con cualquier número de series a la vez y no exige elegir una variable dependiente, basándose en los autovalores de una matriz derivada de un VAR en niveles. Contrasta, en secuencia, cuántas relaciones de cointegración existen (el rango de cointegración \(r\)): \(H_0: r = 0\) (sin cointegración) frente a \(r \geq 1\), después \(H_0: r \leq 1\) frente a \(r \geq 2\), y así sucesivamente.
Test de la traza de Johansen (urca::ca.jo(cbind(x, y), type = "trace", ecdet = "const", K = 2)) sobre los mismos \(x, y\) simulados:
| Hipótesis | Estadístico | Valor crítico al 5% | Conclusión |
|---|---|---|---|
| \(r = 0\) | 72,92 | 19,96 | Rechaza: al menos 1 relación de cointegración |
| \(r \leq 1\) | 5,92 | 7,52 | No rechaza: como mucho 1 |
Leyendo la tabla de arriba abajo, se detiene en la primera fila donde NO se rechaza \(H_0\), aquí es \(r \leq 1\), así que el rango de cointegración es \(r = 1\): exactamente una relación de cointegración, coincidiendo con el resultado de Engle-Granger anterior y con el diseño real de la simulación, dos series que comparten una única tendencia común.
El modelo vectorial de corrección del error (VECM)
Una vez establecida la cointegración, el modelo correcto es un VECM en lugar de un VAR en niveles o un VAR en diferencias, ambos desperdician información: uno ignora las raíces unitarias, el otro ignora la relación a largo plazo. Un VECM combina la dinámica a corto plazo, en diferencias, con un término de corrección del error que empuja al sistema de vuelta hacia el equilibrio a largo plazo cada vez que se aleja de él.
\[\Delta \mathbf{y}_t = \boldsymbol{\alpha}(\boldsymbol{\beta}' \mathbf{y}_{t-1} - \mu) + \boldsymbol{\Gamma}_1 \Delta \mathbf{y}_{t-1} + \boldsymbol{\varepsilon}_t\]
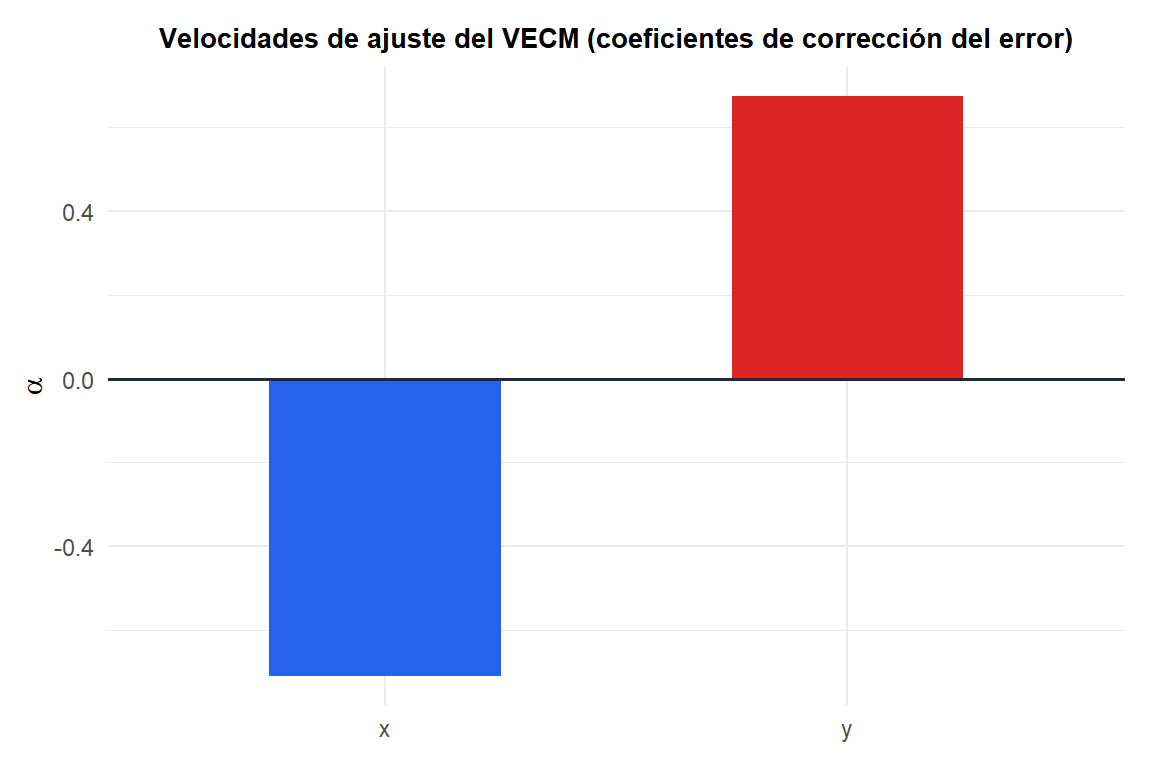
donde \(\boldsymbol{\beta}' \mathbf{y}_{t-1}\) es la relación de cointegración (cuánto se alejó el sistema del equilibrio el periodo anterior) y \(\boldsymbol{\alpha}\) es el vector de velocidades de ajuste, con qué fuerza corrige cada variable de vuelta hacia el equilibrio tras una desviación.
Ajustando el VECM mediante vars::cajorls() sobre los mismos datos, con rango \(r = 1\), se obtienen las velocidades de ajuste estimadas \(\alpha_x = -0{,}709\) y \(\alpha_y = +0{,}675\). Interpretación concreta: siempre que la relación de cointegración esté por encima de su valor de equilibrio a largo plazo, una desviación positiva, \(x\) se mueve hacia ABAJO (coeficiente negativo) e \(y\) se mueve hacia ARRIBA (coeficiente positivo) en el periodo siguiente, ambas acciones empujando al sistema de vuelta hacia el equilibrio, exactamente la corrección del error que da nombre al modelo.
⚠️ Ajustar un VAR en niveles sobre series cointegradas no es solo subóptimo, los resultados pueden ser espurios
Si dos series no estacionarias están cointegradas y ajustas un VAR directamente sobre sus niveles brutos, ignorando por completo las raíces unitarias, el modelo está mal especificado: los errores estándar, los contrastes de significación y las funciones impulso-respuesta de ese VAR no son fiables. Diferenciar ambas series para forzar la estacionariedad y ajustar un VAR sobre las diferencias también es un error, pero de otro tipo, descarta por completo la relación de cointegración a largo plazo, desperdiciando información real. Un VECM es la especificación que aprovecha correctamente ambas piezas: la dinámica a corto plazo de los datos diferenciados, más el equilibrio a largo plazo de la relación en niveles.
Ejecutarlo en R
library(urca)

# Método en dos pasos de Engle-Granger (manual)
fit_ols <- lm(y ~ x)
resid_eg <- residuals(fit_ols)
ur.df(resid_eg, type = "none", lags = 1)   # contraste de raíz unitaria sobre los residuos

# O el test de Engle-Granger integrado, con los valores críticos correctos
library(tseries)
po.test(cbind(y, x))

# Test de Johansen
jo_test <- ca.jo(cbind(x, y), type = "trace", ecdet = "const", K = 2)
summary(jo_test)

# Ajustar el VECM en el rango elegido
library(vars)
vecm_fit <- cajorls(jo_test, r = 1)
summary(vecm_fit$rlm)

# Convertir a un VAR en niveles para predecir, si hace falta
var_form <- vec2var(jo_test, r = 1)
predict(var_form, n.ahead = 12)
💡 El flujo de trabajo de la cointegración, paso a paso
- Contrasta cada serie por separado en busca de raíz unitaria (test de Dickey-Fuller), confirma que ambas son \(I(1)\).
- Contrasta la cointegración: Engle-Granger para 2 series, Johansen para 2 o más.
- Si están cointegradas, ajusta un VECM en el rango de cointegración encontrado.
- Si NO están cointegradas, diferencia ambas series y ajusta un VAR normal sobre las diferencias, o replantéate si esas dos series deben modelarse juntas.
Saltar directamente a un VAR en niveles sin comprobar nada de esto es el error más habitual en el trabajo aplicado de series temporales multivariantes.

