Test de Dickey-Fuller
El artículo general sobre estacionariedad introduce la raíz unitaria y menciona brevemente los tests ADF y KPSS. Este artículo profundiza en un único test: cómo se construye realmente la regresión de Dickey-Fuller (aumentado), por qué sus valores críticos no son los de una tabla t normal, y un ejemplo completo resuelto a mano a partir de resultados reales de R.
La regresión de Dickey-Fuller
Parte del proceso AR(1) más sencillo:
\[y_t = \phi y_{t-1} + \varepsilon_t\]
Restando \(y_{t-1}\) a ambos lados se obtiene una forma de regresión algebraicamente equivalente:
\[y_t - y_{t-1} = (\phi - 1) y_{t-1} + \varepsilon_t \quad \implies \quad \Delta y_t = \gamma y_{t-1} + \varepsilon_t, \qquad \gamma = \phi - 1\]
Esta reescritura convierte la pregunta difícil “¿es \(\phi = 1\)?” en una pregunta fácil: “¿es \(\gamma = 0\)?”, algo que un coeficiente de regresión ordinario puede responder directamente.
\[H_0: \gamma = 0 \ \ (\phi = 1,\ \text{raíz unitaria, no estacionaria})\] \[H_1: \gamma < 0 \ \ (\phi < 1,\ \text{estacionaria})\]
En la práctica se usan tres especificaciones, que coinciden con el argumento type= de urca::ur.df():
none: sin constante ni tendencia. \(\Delta y_t = \gamma y_{t-1} + \varepsilon_t\).drift: solo constante, sin tendencia. \(\Delta y_t = \alpha + \gamma y_{t-1} + \varepsilon_t\).trend: constante más tendencia lineal. \(\Delta y_t = \alpha + \beta t + \gamma y_{t-1} + \varepsilon_t\).
La especificación drift es la opción por defecto más habitual para series sin una tendencia determinista evidente, y es la que se usa en el ejemplo resuelto más abajo. Elegir la especificación equivocada cuesta potencia estadística en ambas direcciones: incluir un término de tendencia cuando la serie no la tiene desperdicia grados de libertad y hace menos probable rechazar una raíz unitaria falsa, mientras que omitir una tendencia realmente presente puede hacer que una serie no estacionaria con tendencia parezca engañosamente cercana a la estacionariedad.
\[\Delta y_t = \alpha + \gamma y_{t-1} + \varepsilon_t \qquad H_0: \gamma = 0 \quad \text{frente a} \quad H_1: \gamma < 0\]
Cada especificación tiene su propia tabla de valores críticos, ya que añadir una constante o una tendencia desplaza la distribución de referencia de \(\tau\). La convención de MacKinnon etiqueta estas tablas como \(\tau_1\) (none), \(\tau_2\) (drift) y \(\tau_3\) (trend); summary(ur.df(...)) imprime automáticamente la que corresponde según type=.
¿Por qué no una tabla t normal?
Este es el punto que más fácilmente se pasa por alto: bajo \(H_0\), \(y_{t-1}\) es en sí misma no estacionaria (es un proceso con raíz unitaria), por lo que el estadístico t de \(\gamma\), habitualmente denotado \(\tau\) (tau), no sigue una distribución t de Student estándar, ni siquiera asintóticamente cuando el tamaño muestral crece.
Intuitivamente, bajo una raíz unitaria el regresor \(y_{t-1}\) se aleja cada vez más de su punto de partida a medida que \(t\) crece, por lo que no se asienta en la distribución fija y bien comportada en la que se apoya la teoría de mínimos cuadrados ordinarios. La distribución muestral de \(\tau\) termina sesgada a la izquierda y desplazada respecto a la forma de campana habitual, razón por la cual usar valores críticos t estándar haría que el test rechazara con mucha menos frecuencia de la debida.
Dickey y Fuller derivaron la distribución de referencia correcta mediante simulación y tabularon sus valores críticos. MacKinnon las hizo posteriormente utilizables para cualquier tamaño muestral mediante regresiones de superficie de respuesta, que es justo lo que paquetes como urca usan internamente para imprimir valores críticos o p-valores. Por eso \(\tau\) siempre debe compararse con los valores críticos especiales de Dickey-Fuller (o MacKinnon), nunca con qt() ni con una tabla t impresa.
Aumentando para la autocorrelación (la “A” de ADF)
La regresión anterior asume que los errores \(\varepsilon_t\) son ruido blanco. Si \(y_t\) tiene autocorrelación de orden superior, los residuos no serán ruido blanco y el test deja de ser fiable. La solución es añadir términos de diferencias retardadas hasta blanquear los residuos:
\[\Delta y_t = \alpha + \gamma y_{t-1} + \sum_{j=1}^p \delta_j \Delta y_{t-j} + \varepsilon_t\]
El número de retardos \(p\) se elige habitualmente por AIC o BIC, o mediante un procedimiento secuencial: empezar con un número generoso de retardos y eliminar el menos significativo hasta que el último retardo incluido sea significativo. Añadir retardos solo controla la autocorrelación; el contraste de hipótesis en sí sigue siendo sobre \(\gamma\), sin cambios.
Muy pocos retardos dejan autocorrelación en los residuos y distorsionan el tamaño del test, haciendo que rechace con demasiada frecuencia. Demasiados retardos desperdician grados de libertad y reducen la potencia, dificultando el rechazo de una raíz unitaria falsa. En la práctica, este equilibrio es justo la razón por la que urca::ur.df() expone lags como argumento en lugar de fijar una única opción.
Una regla práctica habitual para el número inicial de retardos, debida a Schwert, es \(p_{max} = \lfloor 12 (T/100)^{1/4} \rfloor\), tras lo cual el AIC, el BIC o el procedimiento secuencial de test t lo van recortando. Para la serie corta usada en el ejemplo resuelto más abajo, \(T=60\), esa cota superior ya es lo bastante pequeña como para que contrastar con lags = 0 sea una simplificación razonable con fines ilustrativos.
Un ejemplo resuelto, a mano
Simula dos series de longitud \(T=60\): un proceso AR(1) estacionario con \(\phi=0{,}6\), y un paseo aleatorio puro.
set.seed(1)
T <- 60
eps  <- rnorm(T)
y_ar <- numeric(T)
for (t in 2:T) y_ar[t] <- 0.6 * y_ar[t-1] + eps[t]
eps2 <- rnorm(T)
y_rw <- cumsum(eps2)
Ambas se contrastan con la especificación drift y sin retardos de aumento (urca::ur.df(y, type = "drift", lags = 0)).
Para y_ar (la serie AR(1) estacionaria):
\[\widehat{\Delta y_t} = 0{,}165 - 0{,}550\, y_{t-1}\]
\(SE(\hat\gamma) = 0{,}118\), por lo que \(\tau = -0{,}550/0{,}118 = -4{,}655\), con gl residuales \(= 57\).
Para y_rw (el paseo aleatorio):
\[\widehat{\Delta y_t} = 0{,}417 - 0{,}083\, y_{t-1}\]
\(SE(\hat\gamma) = 0{,}0547\), por lo que \(\tau = -0{,}083/0{,}0547 = -1{,}509\), con gl residuales \(= 57\).
Valores críticos de MacKinnon para la especificación drift (\(\tau_2\)): 1% = \(-3{,}51\), 5% = \(-2{,}89\), 10% = \(-2{,}58\).
Decisión para y_ar: \(\tau = -4{,}655 < -3{,}51\), por lo que se rechaza \(H_0\) al nivel del 1%. Evidencia sólida de estacionariedad, lo que coincide correctamente con la forma en que se simuló la serie: un AR(1) con \(|\phi| < 1\).
Decisión para y_rw: \(\tau = -1{,}509\), un valor mayor incluso que el valor crítico del 10% (\(-2{,}58\)), es decir, menos negativo, dentro de la región de no rechazo. No se rechaza \(H_0\). No hay evidencia en contra de la raíz unitaria, lo que coincide correctamente con la forma en que se simuló la serie: un paseo aleatorio puro.

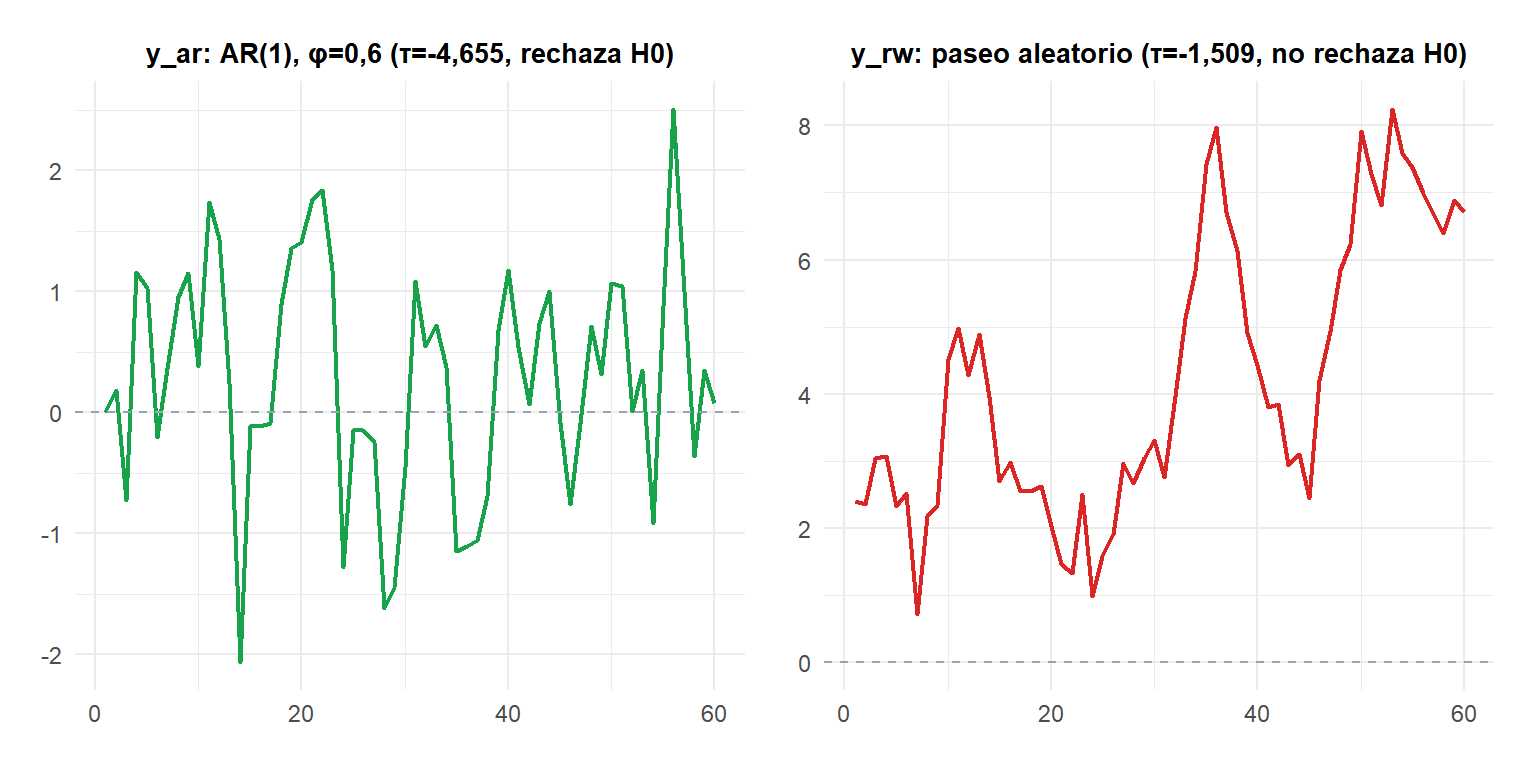
La serie estacionaria (verde) oscila en torno a una media constante y cruza repetidamente la línea de cero. El paseo aleatorio (rojo) se aleja de cero y no regresa de forma fiable, exactamente la firma visual que el test ADF detecta numéricamente.
Fíjate en la relación entre ambos errores estándar y \(\hat\gamma\): para y_ar, \(SE(\hat\gamma) = 0{,}118\) es pequeño en relación con el coeficiente, por lo que este se estima con precisión suficiente como para distinguirse de cero. Para y_rw, \(SE(\hat\gamma) = 0{,}0547\) también es pequeño en términos absolutos, pero el propio coeficiente, \(-0{,}083\), está lo bastante cerca de cero como para que \(\tau\) caiga bien dentro de la región de no rechazo.
⚠️ tseries::adf.test() no es la misma regresión: comprueba qué ajusta realmente
Por defecto, tseries::adf.test() en R ajusta una especificación distinta de la de solo constante usada arriba: incluye tanto una constante como un término de tendencia lineal, y elige automáticamente el orden de retardos de aumento mediante una regla práctica, \(p = \lfloor (n-1)^{1/3} \rfloor\). El ejemplo resuelto anterior usó en cambio urca::ur.df(type = "drift", lags = 0): solo constante, sin aumento.
Como la especificación es distinta, el estadístico y el p-valor que imprime adf.test() generalmente no coincidirán con los números de “drift, sin aumento” calculados arriba. Ambos son tests ADF válidos, simplemente responden a una pregunta sutilmente diferente: si hay una tendencia determinista que controlar, y cuántos retardos de autocorrelación hacen falta para blanquear los residuos. Comprueba siempre qué especificación usa una función (type= en urca::ur.df(), o la documentación del paquete que uses) antes de comparar resultados entre herramientas o artículos.
Elegir entre ADF, KPSS y Phillips-Perron
El ADF contrasta \(H_0\) = raíz unitaria, mientras que el KPSS contrasta lo opuesto, \(H_0\) = estacionariedad, por lo que una conclusión robusta necesita que ambos tests coincidan en lugar de fiarse de uno solo. El artículo general sobre estacionariedad cubre el KPSS y el Phillips-Perron con más detalle; aquí va solo un recordatorio compacto.
| Test | \(H_0\) | Rechazar \(H_0\) significa |
|---|---|---|
| ADF | Raíz unitaria (no estacionaria) | Evidencia de estacionariedad |
| KPSS | Estacionaria | Evidencia de raíz unitaria |
| Phillips-Perron | Raíz unitaria (no estacionaria) | Evidencia de estacionariedad (robusto ante heterocedasticidad) |
Ejecutar el test en R
summary() sobre un objeto ur.df() imprime los coeficientes de la regresión ajustada, el estadístico de contraste (etiquetado tau2 para la especificación drift), y una pequeña tabla de valores críticos a los niveles del 1%, 5% y 10%, los mismos números usados en el ejemplo resuelto arriba. Leer esa tabla directamente, en lugar de fiarse solo del p-valor, es una buena práctica: muestra exactamente cuán cerca estuvo la decisión del siguiente nivel de significación.
library(urca)

set.seed(1)
T <- 60
eps  <- rnorm(T)
y_ar <- numeric(T)
for (t in 2:T) y_ar[t] <- 0.6 * y_ar[t-1] + eps[t]
eps2 <- rnorm(T)
y_rw <- cumsum(eps2)

# Forma de regresión transparente, coincide exactamente con el ejemplo a mano
summary(ur.df(y_ar, type = "drift", lags = 0))
summary(ur.df(y_rw, type = "drift", lags = 0))

# Alternativa rápida y muy usada (especificación por defecto distinta, ver aviso arriba)
library(tseries)
adf.test(y_ar)
adf.test(y_rw)

# Ayudante automático para el orden de diferenciación
library(forecast)
ndiffs(y_rw)
ndiffs() ejecuta internamente este mismo tipo de búsqueda basada en el ADF (el KPSS también es una opción a través de su argumento test=) y devuelve el número mínimo de diferencias regulares que estima necesarias, un atajo cómodo una vez que ya entiendes qué hace la regresión subyacente.
💡 Diferencia y vuelve a contrastar siempre
Si el test ADF no rechaza la raíz unitaria, el remedio estándar es diferenciar la serie una vez y volver a ejecutar el test ADF sobre \(\Delta y_t\). Repite hasta que el test rechace. La mayoría de las series económicas y financieras están integradas de orden 1, \(I(1)\): una diferenciación es suficiente. forecast::ndiffs() automatiza esta búsqueda. La sobrediferenciación, ir más allá de lo necesario, introduce ruido innecesario y debe evitarse: confirma siempre el \(d\) mínimo que logra la estacionariedad en lugar de diferenciar repetidamente “por si acaso”.

