Ley de los grandes números
La ley de los grandes números (LGN) es la garantía formal detrás de una intuición que todo el mundo ya tiene: lanza una moneda pocas veces y puedes obtener una racha inusual; lánzala un millón de veces y la proporción de caras estará extremadamente cerca del 50%. Es el pariente más cercano del teorema central del límite en esta web, pero responde a una pregunta distinta; esta entrada precisa esa diferencia.
La ley débil de los grandes números
Para variables aleatorias independientes e idénticamente distribuidas \(X_1, X_2, \ldots\) con media finita \(\mu\), la media muestral \(\bar{X}_n\) converge en probabilidad a \(\mu\):
\[\bar{X}_n \xrightarrow{P} \mu \quad \text{cuando } n \to \infty\]
Formalmente, para cualquier \(\varepsilon > 0\): \(P(|\bar{X}_n - \mu| > \varepsilon) \to 0\) cuando \(n \to \infty\). En lenguaje llano: por pequeño que sea el margen \(\varepsilon\) que elijas, la probabilidad de que la media muestral se desvíe de la media real en más de ese margen se reduce hacia cero a medida que crece la muestra.
Ley débil frente a ley fuerte
La ley débil anterior dice que la probabilidad de una desviación grande se desvanece a medida que crece \(n\), pero en principio sigue permitiendo que la secuencia \(\bar{X}_n\) se aleje ocasionalmente de \(\mu\) infinitas veces, solo que con probabilidad cada vez menor en cada \(n\) fijo.
La ley fuerte es una garantía más estricta:
\[\bar{X}_n \to \mu \quad \text{casi seguramente}\]
Es decir, con probabilidad 1, la secuencia real de medias muestrales converge a \(\mu\) y a partir de cierto punto se mantiene arbitrariamente cerca para siempre, no solo “probablemente cerca en cada \(n\)”. Para casi cualquier propósito práctico en esta web, la distinción no cambia cómo se usa el resultado, pero es una diferencia matemática real y célebre que merece la pena conocer.
Ejemplo resuelto: la media móvil de tiradas de un dado
Lanza repetidamente un dado justo de seis caras. La media real es \(\mu = 3{,}5\). Sigue la media móvil a medida que crece el número de tiradas:
set.seed(7)
for (n in c(10, 100, 1000, 10000, 100000)) {
  tiradas <- sample(1:6, n, replace = TRUE)
  # mean(tiradas), abs(mean(tiradas) - 3.5)
}| Número de tiradas \(n\) | Media muestral \(\bar{X}_n\) | \(\lvert \bar{X}_n - 3{,}5 \rvert\) |
|---|---|---|
| 10 | 3,30 | 0,20 |
| 100 | 3,43 | 0,07 |
| 1.000 | 3,538 | 0,038 |
| 10.000 | 3,5049 | 0,0049 |
| 100.000 | 3,4979 | 0,0021 |
La brecha se reduce en conjunto, pero no de forma suave en cada paso: la desviación en \(n=1.000\) (0,038) sigue siendo menor que en \(n=100\) (0,07), aunque en general este tipo de comparación puede ir en cualquier dirección en pasos intermedios. La LGN nunca promete que cada tirada adicional acerque estrictamente la media a \(\mu\), solo que la probabilidad de estar lejos de \(\mu\) se reduce de forma fiable a medida que \(n\) crece sin límite. Eso es exactamente lo que significa “converge en probabilidad”: una garantía sobre el largo plazo, no una promesa de mejora suave paso a paso.

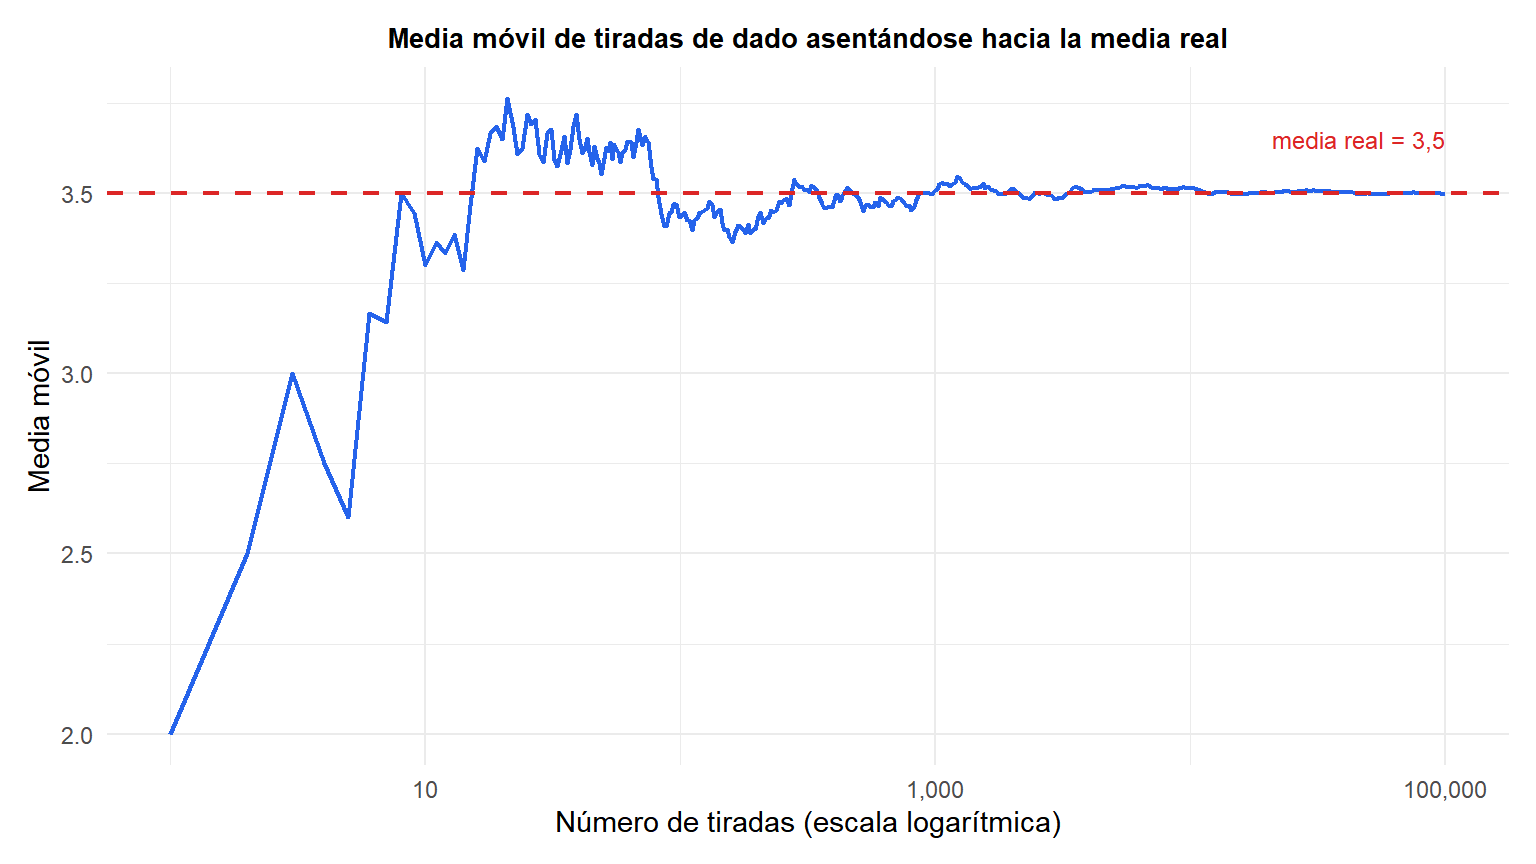
Al principio, con solo unas pocas tiradas, la media móvil oscila mucho. A medida que el número de tiradas crece hacia los miles y más allá, las oscilaciones se reducen y la línea se asienta con fuerza en torno a la media real de 3,5.
Ley de los grandes números frente a teorema central del límite: la diferencia clave
Ambos describen el comportamiento de \(\bar{X}_n\) a medida que crece \(n\), pero responden a preguntas distintas.
- La LGN dice DÓNDE termina \(\bar{X}_n\): converge al único punto \(\mu\), colapsando a una masa puntual en el límite.
- El TCL dice CÓMO fluctúa \(\bar{X}_n\) ALREDEDOR de \(\mu\) para un \(n\) grande pero finito: aproximadamente distribuida de forma normal, con una dispersión que se reduce como \(\sigma/\sqrt{n}\).
Dicho de forma directa: la LGN es una afirmación sobre la convergencia a un punto; el TCL es un refinamiento que describe la forma y el ritmo de esa convergencia. Si se reescala \(\bar{X}_n - \mu\) por \(\sqrt{n}\), el “colapso a un punto” de la LGN se convierte exactamente en la distribución normal del TCL: son dos vistas del mismo proceso de convergencia a distinta escala.
⚠️ La ley de los grandes números no explica, ni justifica, la falacia del jugador
Un uso indebido muy habitual: creer que, tras una racha larga de un resultado (por ejemplo, caras), la LGN hace que el otro resultado (cruz) esté de algún modo “pendiente” para equilibrar las cosas y acelerar el regreso de la media hacia 0,5. Esto es falso. Cada lanzamiento sigue siendo completamente independiente del pasado, la moneda no tiene memoria.
Lo que ocurre en realidad no es que las desviaciones pasadas se corrijan, sino que se diluyen numéricamente: una racha de 10 caras de más en los primeros 20 lanzamientos apenas mueve la media una vez hechos un millón de lanzamientos, no porque el universo compense nada, sino simplemente porque \(10/1.000.000\) es un número diminuto. La LGN actúa por dilución gracias a un tamaño muestral creciente, nunca por compensación.
Requisitos para que se cumpla la ley de los grandes números
Las observaciones deben tener media finita. Para distribuciones con media indefinida o infinita, la media muestral no converge a nada a medida que crece \(n\), sigue saltando de forma impredecible sin importar lo grande que sea la muestra. Es una excepción real, aunque inusual, que merece la pena conocer; la inmensa mayoría de las magnitudes del mundo real, con media finita, quedan cubiertas de forma segura por la LGN.
Ejecutar la simulación en R
set.seed(7)
n_max <- 100000
tiradas <- sample(1:6, n_max, replace = TRUE)
media_movil <- cumsum(tiradas) / seq_along(tiradas)

# Valor en algunos puntos de control
media_movil[c(10, 100, 1000, 10000, 100000)]
💡 La LGN en la práctica: por qué los seguros, los casinos y los test A/B dependen de ella
La LGN es la razón matemática por la que las aseguradoras pueden predecir de forma rentable los pagos agregados pese a la incertidumbre total sobre cualquier asegurado concreto, por la que el margen de beneficio a largo plazo de un casino es fiable aunque cada apuesta individual sea una moneda al aire, y por la que los test A/B y las encuestas necesitan una muestra suficientemente grande antes de que sus medias observadas puedan considerarse cercanas a la tasa real subyacente. En todos los casos, la garantía es sobre la media a lo largo de muchas repeticiones, nunca sobre ningún resultado individual.

