Teorema central del límite
El teorema central del límite (TCL) es uno de los resultados más importantes de toda la estadística. Explica por qué tantos procedimientos estadísticos, contrastes t, intervalos de confianza, ANOVA, pueden apoyarse en una aproximación normal aunque los datos originales no sean normales en absoluto, siempre que se esté observando una suma o una media de muchas observaciones, y no las observaciones individuales.
Qué dice realmente el teorema
Sean \(X_1, X_2, \ldots, X_n\) variables aleatorias independientes e idénticamente distribuidas procedentes de cualquier población con media finita \(\mu\) y varianza finita \(\sigma^2\). La población en sí puede tener cualquier forma: asimétrica, bimodal, uniforme, lo que sea, siempre que tenga media y varianza finitas. Se define la media muestral como:
\[\bar{X}_n = \frac{1}{n}\sum_{i=1}^n X_i\]
Cuando \(n \to \infty\):
\[\bar{X}_n \ \xrightarrow{d}\ N\!\left(\mu, \ \frac{\sigma^2}{n}\right)\]
de forma equivalente:
\[\frac{\bar{X}_n - \mu}{\sigma/\sqrt{n}} \ \xrightarrow{d}\ N(0,1)\]
En este único teorema se agrupan tres afirmaciones distintas, y las tres importan:
- Forma: la distribución muestral de \(\bar{X}_n\) se vuelve aproximadamente normal, sin importar la forma original de la población.
- Centro: está centrada exactamente en la media poblacional \(\mu\) (sin sesgo).
- Dispersión: su dispersión se reduce a un ritmo preciso y conocido, el error estándar \(\sigma/\sqrt{n}\), de modo que la precisión mejora proporcionalmente a \(\sqrt{n}\), no a \(n\) (cuadruplicar el tamaño muestral solo reduce el error estándar a la mitad).
Una demostración concreta: muestreo desde una población asimétrica
Para que la conclusión del teorema resulte llamativa, se parte de una población deliberadamente en el “peor caso”: la distribución exponencial con tasa \(1\). Tiene media \(\mu = 1\), desviación típica \(\sigma = 1\), y es fuertemente asimétrica a la derecha, nada parecida a una campana de Gauss.
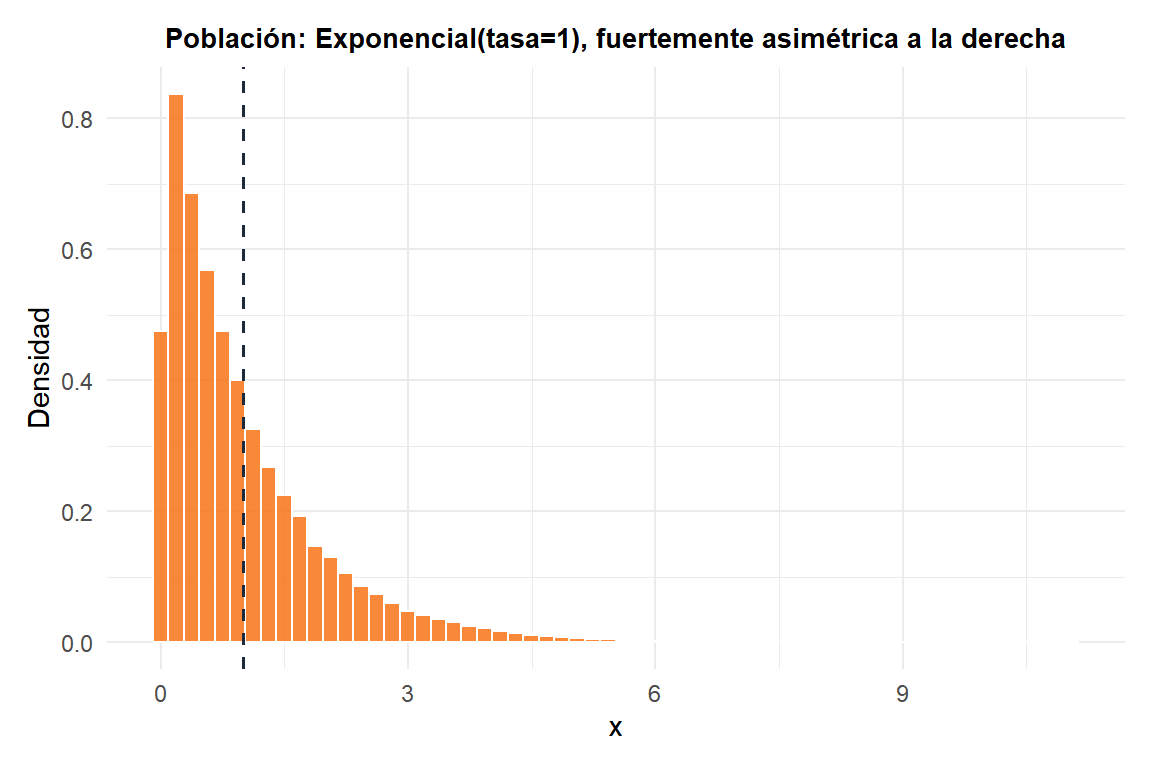
Ahora se extraen repetidamente muestras de tamaño \(n\) de esta población, se calcula la media de cada muestra, y se observa la distribución de esas medias: la distribución muestral de \(\bar{X}_n\).
Se simularon 20.000 medias muestrales replicadas para cada tamaño muestral \(n\) a partir de una Exponencial(tasa=1), con set.seed(123):
set.seed(123)
results <- sapply(c(2, 5, 30, 100), function(n) {
  means <- replicate(20000, mean(rexp(n, rate = 1)))
  c(mean = mean(means), sd = sd(means))
})| Tamaño muestral \(n\) | Media de \(\bar{X}_n\) en 20.000 muestras simuladas | DE de \(\bar{X}_n\) (simulada) | EE teórico \(=\sigma/\sqrt{n}\) |
|---|---|---|---|
| 2 | 1,002 | 0,702 | 0,707 |
| 5 | 0,993 | 0,445 | 0,447 |
| 30 | 1,001 | 0,182 | 0,183 |
| 100 | 1,000 | 0,0989 | 0,100 |
Hay que fijarse en dos cosas. La media simulada de \(\bar{X}_n\) se mantiene esencialmente en \(\mu=1\) para cada \(n\) (afirmación 2, sin sesgo, incluso con \(n=2\)), mientras que la DE simulada de \(\bar{X}_n\) se reduce y coincide casi exactamente con la fórmula teórica \(\sigma/\sqrt{n}\) en cada uno de los tamaños (afirmación 3). Lo que cambia con \(n\) es únicamente la forma de la distribución (afirmación 1): con \(n=2\), la distribución muestral de \(\bar{X}_2\) sigue siendo visiblemente asimétrica a la derecha, heredando la asimetría de la población; con \(n=30\) ya se parece bastante a una campana simétrica; con \(n=100\) es prácticamente indistinguible de una normal.

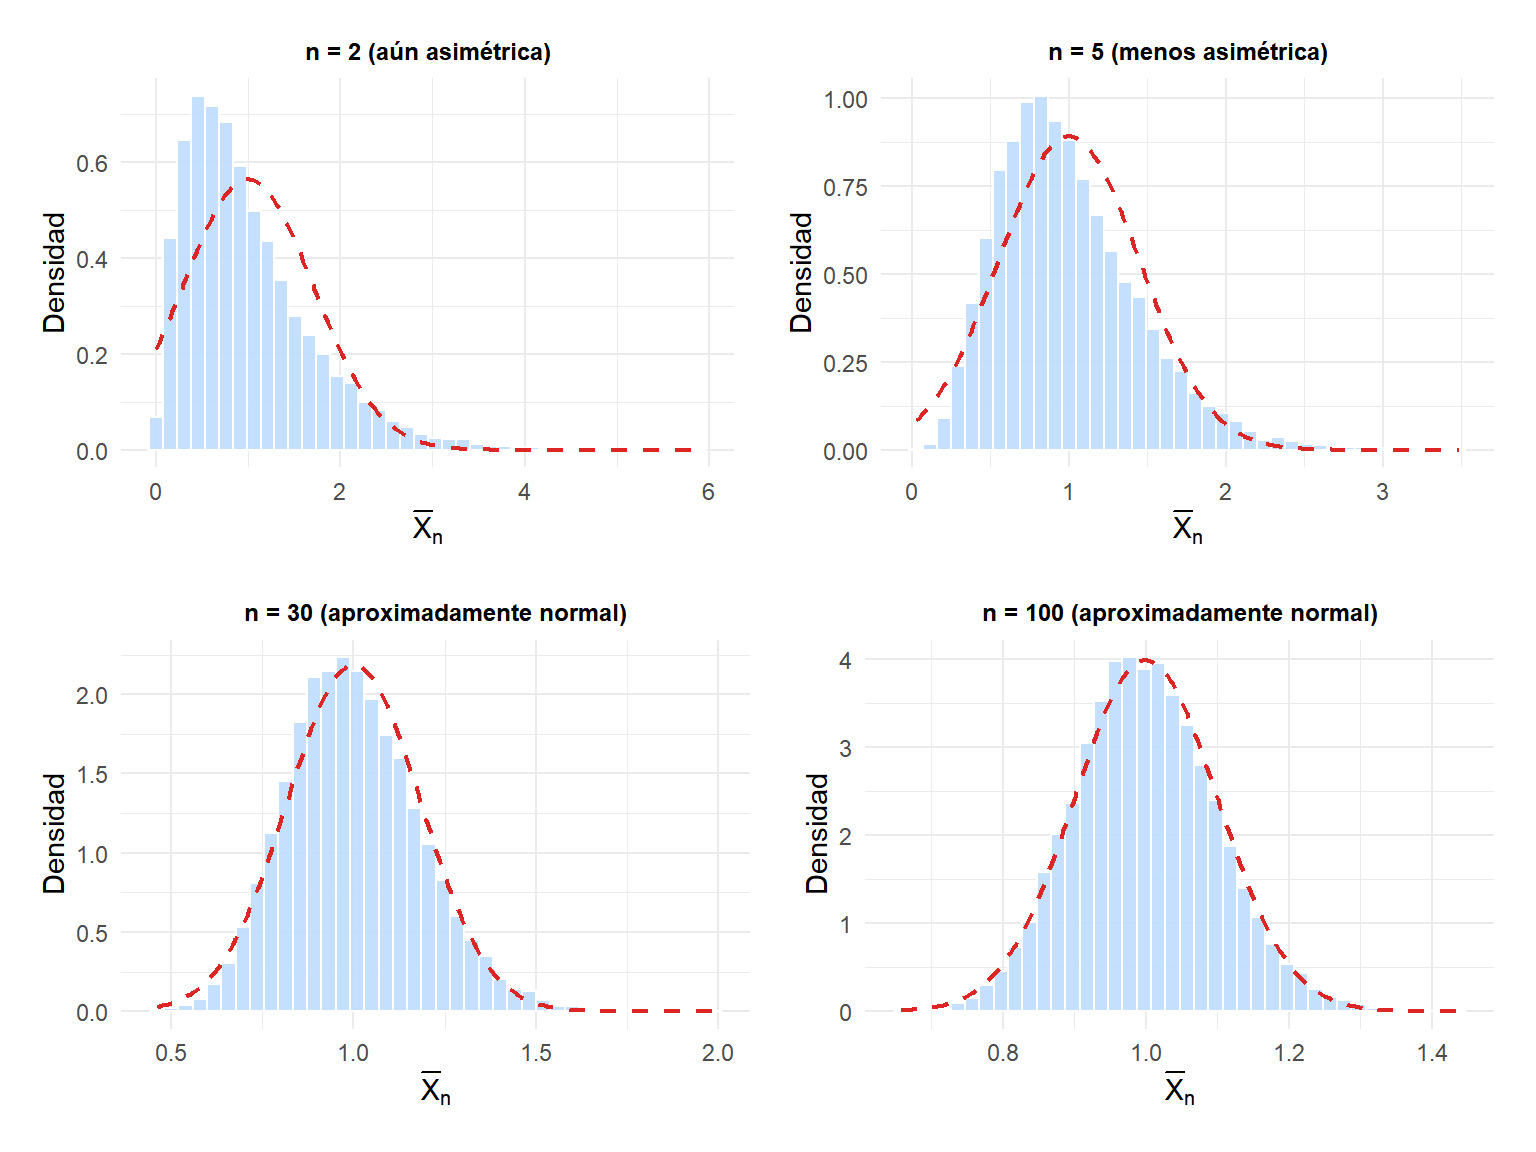
Los histogramas azules son las distribuciones muestrales simuladas de \(\bar{X}_n\); la línea roja discontinua es la curva normal teórica \(N(\mu, \sigma^2/n)\) que predice el TCL. Con \(n=2\) el histograma todavía se inclina visiblemente hacia la derecha, alejado de la curva normal. Con \(n=30\) y \(n=100\), el histograma y la curva normal teórica quedan casi superpuestos, aunque la población de la que proceden nunca se pareció remotamente a una normal.
Por qué esto importa en la práctica
El TCL es la justificación teórica detrás de una enorme parte de la estadística aplicada en esta web:
- El contraste z y el contraste t para una media de una sola muestra dependen de que la distribución muestral de \(\bar{X}_n\) sea aproximadamente normal.
- Los intervalos de confianza para una media se construyen directamente a partir de la aproximación normal (o t) a la distribución muestral de \(\bar{X}_n\).
- La robustez del ANOVA frente a desviaciones leves de la normalidad procede de la misma fuente: el estadístico del contraste se construye a partir de medias de grupo, y el TCL empuja esas medias hacia la normalidad aunque los datos brutos no lo sean.
Ninguno de estos métodos exige que los datos originales sean normales, solo que el estadístico relevante (típicamente una media o una suma) sea en sí mismo aproximadamente normal, algo que el TCL garantiza para un \(n\) suficientemente grande.
⚠️ El tamaño de muestra necesario depende de la asimetría de la población
No existe un umbral universal como \(n \geq 30\) que funcione para cualquier población (ese número es una regla empírica popular, no una garantía matemática). Una población solo levemente asimétrica puede necesitar apenas \(n=10\) o \(15\) para que la distribución muestral de la media resulte convincentemente normal. Una población con asimetría extrema o colas muy pesadas (como el ejemplo exponencial anterior, o peor, una distribución de Pareto o de ley de potencia) puede necesitar \(n\) del orden de cientos. Peor aún, si la población ni siquiera tiene varianza finita (algunas distribuciones de colas muy pesadas), el TCL no se aplica en absoluto: ningún tamaño muestral lo va a arreglar.
Conviene comprobar siempre: ¿la magnitud que se está promediando procede de una población razonablemente bien comportada, con varianza finita? Si hay dudas serias, es mejor usar un método no paramétrico o un enfoque bootstrap en lugar de apoyarse en el TCL.
Ejecutar la simulación en R
set.seed(123)

# Población: Exponencial(tasa = 1), media = 1, de = 1, fuertemente asimétrica
hist(rexp(100000, rate = 1), breaks = 60, main = "Forma de la población")

# Distribuciones muestrales de la media para n crecientes
for (n in c(2, 5, 30, 100)) {
  means <- replicate(20000, mean(rexp(n, rate = 1)))
  cat("n =", n,
      " media =", round(mean(means), 3),
      " de =",    round(sd(means), 3),
      " EE teórico =", round(1/sqrt(n), 3), "\n")
}
💡 El TCL trata sobre la distribución muestral, no sobre tu único conjunto de datos
Una confusión muy habitual: el TCL no dice que tus datos brutos se vayan a volver normales si simplemente recoges suficientes. Tus datos brutos conservan la forma que tenga la población, por muy grande que sea tu única muestra. Lo que se vuelve normal es la distribución de un estadístico resumen (típicamente la media) calculado a través de muchas muestras repetidas, o equivalentemente, la distribución muestral teórica de la que se extrae una sola media muestral. Si al representar un histograma de tus observaciones brutas sigue viéndose asimétrico incluso con una muestra enorme, eso es completamente esperable y no contradice el TCL en absoluto.
Para la pregunta relacionada, pero distinta, de dónde termina \(\bar{X}_n\) (en lugar de cómo fluctúa alrededor de ese punto), consulta la ley de los grandes números.

