GAMLSS (modelos aditivos generalizados para localización, escala y forma)
Un GAM deja que la media de la respuesta dependa de forma suave de los predictores, pero sigue asumiendo una única relación fija para la dispersión y la forma de la distribución alrededor de esa media. GAMLSS (modelos aditivos generalizados para localización, escala y forma) elimina esa suposición: la media, la varianza, e incluso la asimetría y la curtosis de la respuesta pueden depender cada una de los predictores, mediante su propio predictor lineal o suave, para casi cualquier familia de distribución.
Modelar cada parámetro, no solo la media
Un GLM o un GAM enlaza un único parámetro (normalmente la media \(\mu\)) con los predictores. GAMLSS enlaza hasta cuatro parámetros de la distribución a la vez, cada uno con su propio predictor lineal y función de enlace:
\[g_1(\mu) = X_\mu \boldsymbol{\beta}_\mu, \quad g_2(\sigma) = X_\sigma \boldsymbol{\beta}_\sigma, \quad g_3(\nu) = X_\nu \boldsymbol{\beta}_\nu, \quad g_4(\tau) = X_\tau \boldsymbol{\beta}_\tau\]
donde \(\mu\) es la localización (normalmente la media o la mediana), \(\sigma\) es la escala (dispersión), y \(\nu\) y \(\tau\) controlan la asimetría y la curtosis en las familias de distribución lo bastante flexibles como para tenerlas. Cada matriz de predictores \(X\) puede ser distinta, así que las variables que impulsan la dispersión no tienen por qué ser las mismas que impulsan la media. Cualquiera de los cuatro puede ser también simplemente una constante, que es justo lo que hace un GLM normal con \(\sigma\), \(\nu\) y \(\tau\).
Esto importa siempre que la dispersión o la forma de la respuesta cambien de manera sistemática con un predictor, un patrón que una regresión ordinaria obliga a encajar en una única varianza residual fija, equivocándose en silencio.
Ejemplo resuelto: datos de coste con variabilidad creciente
Un conjunto de datos simulado de \(n=150\) importes de siniestro con distribución Gamma, donde tanto la media como la dispersión relativa aumentan con un predictor \(x\) (piensa en el tamaño del siniestro creciendo, y volviéndose proporcionalmente menos predecible, con el valor de la póliza). Se ajustan dos modelos: uno Gamma con un único \(\sigma\) constante, y uno GAMLSS donde \(\sigma\) también puede depender de \(x\).
Coeficientes ajustados (enlace logarítmico en \(\mu\) y en \(\sigma\)):
| Parámetro | Intercepto | Pendiente en \(x\) |
|---|---|---|
| \(\mu\) (media) | 3,505 | 0,178 |
| \(\sigma\) (escala) | -1,594 | 0,122 (\(p < 0{,}001\)) |
La pendiente en \(\sigma\) es claramente distinta de cero: un test de razón de verosimilitud que compara el modelo de \(\sigma\) constante frente a este da \(LRT = 24{,}07\) con 1 grado de libertad, \(p < 0{,}001\). El modelo de \(\sigma\) constante estima una única dispersión de \(\sigma \approx 0{,}450\) para cualquier valor de \(x\); el modelo GAMLSS muestra que \(\sigma\) va en realidad de unos \(0{,}26\) en \(x=2\) a \(0{,}61\) en \(x=9\), más del doble.
El ajuste confirma que merece la pena la complejidad extra: \(\text{AIC} = 1529{,}6\) para el modelo de \(\sigma\) constante frente a \(\text{AIC} = 1507{,}5\) para GAMLSS, una mejora clara al dejar que \(\sigma\) varíe.
Traducir el \(\mu\) y el \(\sigma\) ajustados a cuantiles en dos valores de \(x\) muestra lo que esto significa en la práctica:
| \(x\) | Mediana | Percentil 10 | Percentil 90 | Percentil 90 \(-\) 10 |
|---|---|---|---|---|
| 2 | 46,5 | 32,6 | 63,8 | 31,3 |
| 9 | 145,4 | 56,1 | 301,0 | 244,8 |
La mediana sube unas 3,1 veces de \(x=2\) a \(x=9\), pero la dispersión entre el percentil 10 y el 90 sube unas 7,8 veces en el mismo rango. Un modelo que solo deje moverse a la media predeciría bien el centro en \(x=9\), pero subestimaría drásticamente lo ancho que es en realidad el rango de resultados plausibles.

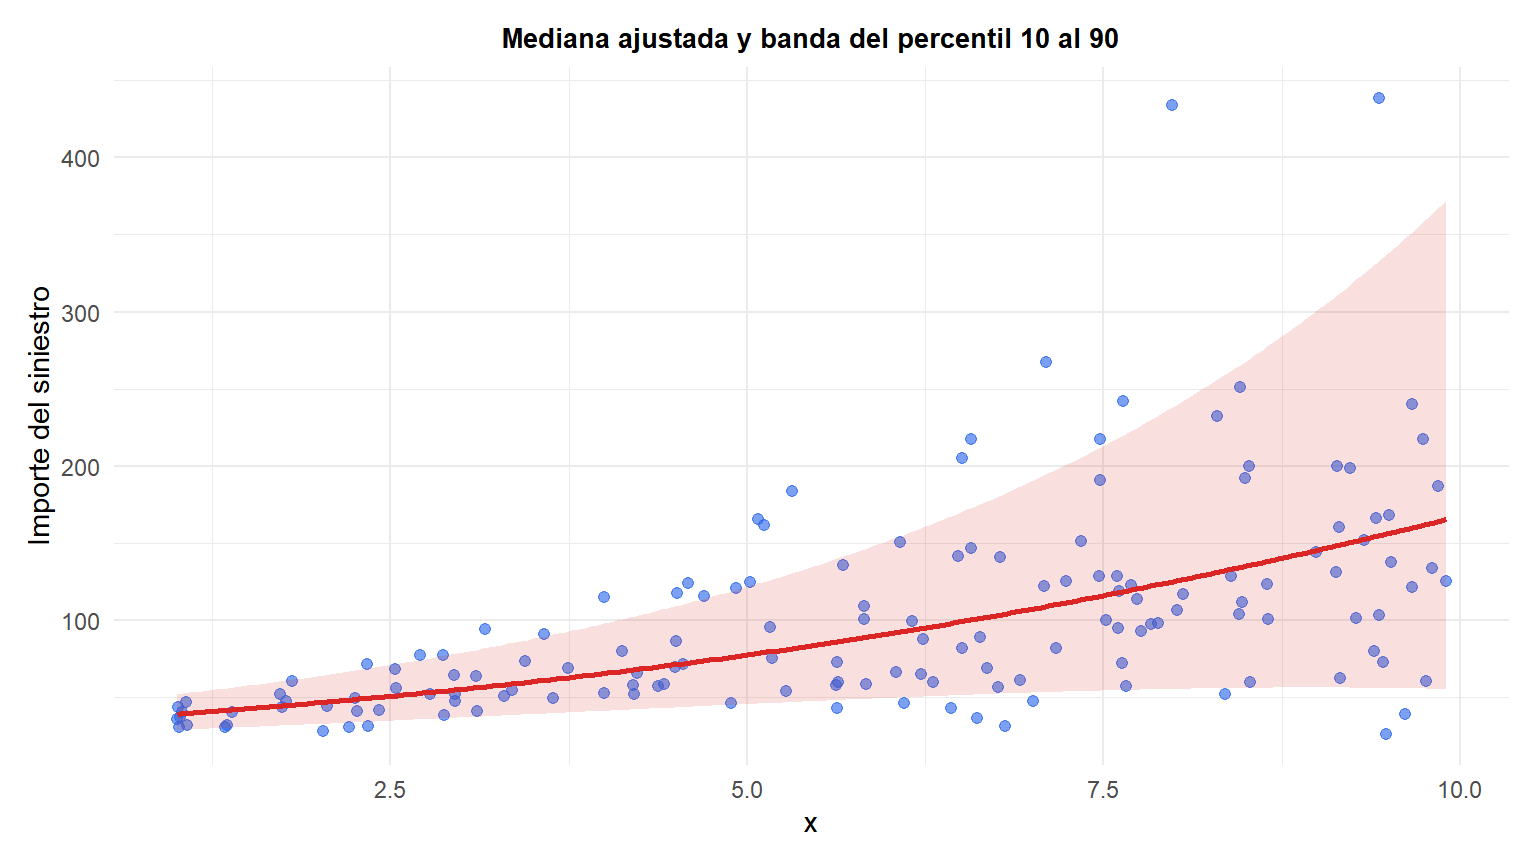
La banda sombreada no es un intervalo de confianza alrededor de la media, es el rango ajustado del percentil 10 al 90 de la propia respuesta, y se ensancha visiblemente al crecer \(x\), justo el patrón que un modelo de \(\sigma\) constante no puede representar.
GAMLSS frente a regresión cuantílica
Ambos enfoques manejan una respuesta cuya dispersión cambia con los predictores, consulta la regresión cuantílica, pero funcionan de forma distinta. La regresión cuantílica ajusta cada cuantil solicitado por separado sin asumir ninguna distribución, lo que la hace robusta frente a equivocarse de familia de distribución, pero solo te da los cuantiles concretos que elegiste ajustar, sin garantía de que sean mutuamente coherentes (una recta ajustada del percentil 10 puede, en teoría, cruzarse con la del percentil 50). GAMLSS ajusta una única distribución coherente por observación, así que cualquier cuantil se puede obtener después, como en el gráfico de arriba, y los cuantiles son coherentes entre sí por construcción, pero el resultado es solo tan bueno como la familia de distribución elegida.
⚠️ La familia de distribución es una decisión de modelado real
A diferencia de la regresión cuantílica, GAMLSS se compromete con una familia paramétrica concreta (Gamma, lognormal, una skew-t, y docenas más están disponibles). Si la familia elegida encaja mal con los datos, los cuantiles ajustados pueden ser sistemáticamente erróneos aunque el modelo converja sin errores. Comprueba siempre los diagnósticos de residuos, el worm plot propio de GAMLSS (wp()) es la herramienta estándar, antes de confiar en predicciones de las colas de la distribución ajustada.
Hacerlo en R
El paquete gamlss ajusta el modelo y permite compararlo con una versión de escala constante mediante un test de razón de verosimilitud:
library(gamlss)

# Sigma constante: equivalente a un GLM Gamma ordinario
fit_const <- gamlss(y ~ x, sigma.formula = ~1, family = GA, data = df)

# GAMLSS: sigma tambien depende de x
fit_gamlss <- gamlss(y ~ x, sigma.formula = ~x, family = GA, data = df)

GAIC(fit_const, fit_gamlss)     # gana el AIC mas bajo
LR.test(fit_const, fit_gamlss)  # test formal del termino extra en sigma

# Diagnosticos
wp(fit_gamlss)                 # worm plot, comprueba si la distribucion encaja
plot(fit_gamlss)               # resumen de residuos

# Coeficientes de cada parametro, y cuantiles predichos
coef(fit_gamlss, what = "mu")
coef(fit_gamlss, what = "sigma")
centiles(fit_gamlss, xvar = df$x)
💡 De dónde viene GAMLSS
GAMLSS lo introdujeron Rigby y Stasinopoulos en 2005, ampliando trabajo anterior sobre el método LMS usado para construir las curvas de referencia del crecimiento infantil, donde el peso o la altura de un niño no se juzgan frente a una única curva media, sino frente a curvas de la mediana, la dispersión y la asimetría que cambian todas con la edad. Esa misma idea, modelar la forma completa de la distribución a medida que cambia con un predictor en vez de solo su centro, es lo que hace útil a GAMLSS mucho más allá de las curvas de crecimiento: siniestros de seguros, datos de ingresos, y cualquier respuesta donde “cuánto se dispersa” o “cuánto se asimetriza” forma parte de la historia por sí mismo.