Regresión cuantílica
Los mínimos cuadrados ordinarios modelan la MEDIA condicional de \(y\) dado \(x\): una única recta, un único número, una única pendiente. La regresión cuantílica modela en cambio un CUANTIL condicional, la mediana, el percentil 10, el percentil 90 o el que se elija. Esa diferencia importa siempre que un predictor cambie no solo el resultado medio, sino la dispersión o la forma de toda la distribución, justo el tipo de patrón que una única recta de la media oculta por completo.
Modelar la media no cuenta toda la historia
Un único ajuste por mínimos cuadrados responde a una sola pregunta: ¿cómo se desplaza la media de \(y\) al cambiar \(x\)? No dice nada sobre si la variabilidad de \(y\) también cambia con \(x\). Cuando los datos son heterocedásticos, la dispersión de \(y\) alrededor de su centro realmente se ensancha o se estrecha a lo largo del rango de \(x\), y cuando el resultado está sesgado, la propia media puede ser un resumen engañoso (consulta por qué la media miente). La regresión cuantílica ajusta una recta distinta para cada cuantil de interés, de modo que puede mostrar que la relación entre \(x\) e \(y\) no es solo un desplazamiento de nivel, puede ser un cambio de forma.
La función de verificación (pérdida pinball)
La regresión cuantílica para el cuantil \(\tau \in (0,1)\) encuentra los coeficientes que minimizan la función de verificación, también llamada pérdida pinball, aplicada a los residuos \(u = y - \hat y\):
\[\rho_\tau(u) = u\left(\tau - \mathbb{1}(u < 0)\right) = \begin{cases} \tau \cdot u & u \geq 0 \\ (\tau - 1) \cdot u & u < 0 \end{cases}\]
Esta pérdida pondera de forma asimétrica los residuos positivos y negativos siempre que \(\tau \neq 0,5\): para \(\tau = 0,9\), predecir por debajo (un residuo positivo) cuesta \(0,9\) por unidad mientras que predecir por encima cuesta solo \(0,1\) por unidad, de modo que la recta ajustada se desplaza hacia arriba hasta que exactamente el 90% de los puntos queda por debajo. En \(\tau = 0,5\) la pérdida se vuelve simétrica y proporcional a \(|u|\), lo que equivale a la regresión por mínimas desviaciones absolutas (LAD), el caso de la regresión de la mediana. Los mínimos cuadrados ordinarios usan una pérdida completamente distinta, el error al cuadrado, \(u^2\), que apunta a la media condicional en lugar de a un cuantil concreto. Los MCO no son un caso particular de la función de verificación; son una función de pérdida distinta que responde a una pregunta relacionada, pero diferente.
Ejemplo resuelto: los datos de gasto en alimentación de Engel
Un conjunto de datos real de presupuestos familiares del siglo XIX, todavía habitual para enseñar este método, hace tangible ese ensanchamiento de la dispersión.
El conjunto de datos clásico para este método es el que usaron Koenker y Bassett en su artículo original de 1978 sobre regresión cuantílica: los presupuestos de 235 hogares obreros belgas recopilados por el estadístico Ernst Engel en 1857, relacionando los ingresos del hogar con el gasto en alimentación (ambos en francos belgas). Viene incluido en el paquete quantreg de R como engel. Conviene aclarar que se trata de Ernst Engel, el estadístico del siglo XIX, y no de Friedrich Engels, coautor del Manifiesto Comunista, una confusión fácil de cometer.
Los ingresos de la muestra van de 377 a 4.958 francos. El ajuste por MCO da:
\[\widehat{\text{gastoalim}} = 147,48 + 0,485 \cdot \text{ingreso}, \quad R^2 = 0{,}830\]
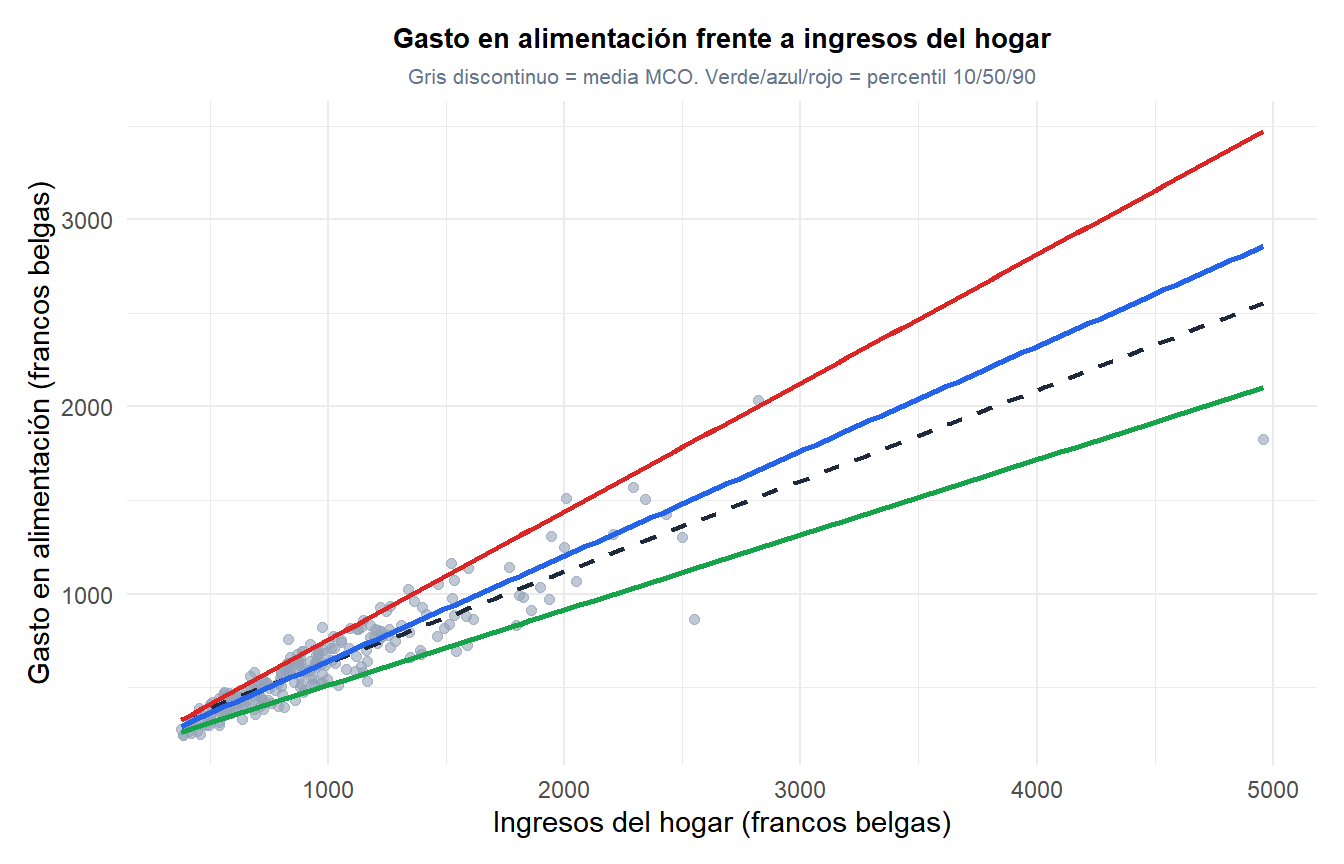
Ajustar tres regresiones cuantílicas en \(\tau = 0,1\), \(0,5\) y \(0,9\) da tres rectas distintas, no tres desplazamientos paralelos de la misma recta:
| Cuantil | Intercepto | Pendiente |
|---|---|---|
| \(\tau = 0,1\) | 110,14 | 0,402 |
| \(\tau = 0,5\) (mediana) | 81,48 | 0,560 |
| \(\tau = 0,9\) | 67,35 | 0,686 |
La propia pendiente sube de 0,402 en el percentil 10 a 0,686 en el percentil 90, un patrón invisible para la única pendiente de MCO, 0,485.

Qué cambia entre los cuantiles
Introduciendo el hogar más pobre y el más rico de la muestra en cada recta ajustada:
| Ingreso | Media MCO | \(\tau=0,1\) | \(\tau=0,5\) | \(\tau=0,9\) | Diferencia (\(\tau=0,9\) menos \(\tau=0,1\)) |
|---|---|---|---|---|---|
| 377 (mínimo) | 330 | 262 | 293 | 326 | 64,5 |
| 4.958 (máximo) | 2.553 | 2.102 | 2.859 | 3.470 | 1.367,9 |
En el ingreso más bajo de la muestra, la diferencia entre el hogar del percentil 10 y el del percentil 90 es de solo unos 65 francos: los hogares pobres gastan en alimentación dentro de una banda bastante estrecha y disciplinada. En el ingreso más alto, esa diferencia se dispara hasta casi 1.368 francos, más de 20 veces más ancha: los hogares ricos muestran mucho más margen de decisión sobre cuánto de su ingreso destinan a alimentación. La única recta de MCO, con su única pendiente de 0,485, solo informa de la tendencia media y oculta por completo este ensanchamiento.
Este mismo conjunto de datos es, además, el que estableció la ley de Engel: la proporción del presupuesto destinada a alimentación cae a medida que aumenta el ingreso. El ajuste de MCO predice un gasto en alimentación equivalente a aproximadamente el 87,6% del ingreso en el extremo más pobre de la muestra, y solo alrededor del 51,5% en el extremo más rico, aunque la cantidad absoluta gastada en alimentación siga aumentando en todo el rango.
No es lo mismo que mirar la dispersión de los residuos
La pendiente creciente de la tabla anterior es fácil de confundir con una simple dispersión mayor de los residuos alrededor de una única recta media, pero no es eso lo que ocurre en realidad.
⚠️ Cada recta de cuantil es un ajuste independiente, no una copia desplazada de la recta de MCO
Es tentador pensar que la regresión cuantílica es solo “ajustar MCO y luego mirar cuánto se dispersan los residuos”. No lo es. Cada recta \(\tau\) anterior se ajusta de forma independiente y puede tener su propia pendiente, como muestra la tabla: la pendiente aumenta de verdad de 0,402 a 0,686 entre los tres cuantiles. Un modelo que solo desplazara arriba o abajo una única recta de MCO (pendiente constante, interceptos distintos) pasaría esto totalmente por alto: la relación entre el ingreso y el gasto en alimentación no solo se desplaza, cambia de forma a lo largo de la distribución, y solo ajustar una recta por cada cuantil lo revela.
Cuándo recurrir a la regresión cuantílica
- Datos heterocedásticos, donde la dispersión de \(y\) cambia visiblemente con \(x\), justo el patrón que los diagnósticos de regresión suelen señalar como una violación que corregir o al menos tolerar en un modelo de MCO. En la regresión cuantílica, ese mismo ensanchamiento no es un problema que corregir, es el objeto de interés.
- Resultados asimétricos, donde la media se aleja de lo que parece un caso “típico”, y donde la mediana u otro cuantil es un resumen más informativo (consulta por qué la media miente).
- Preguntas sobre las colas, no solo sobre el centro: una pregunta de política como “qué umbral de ingresos movería al 10% más pobre de un grupo objetivo” necesita el propio modelo del percentil 10, no un ajuste sobre la media.
- Robustez frente a valores atípicos en \(y\): al construirse sobre desviaciones absolutas y no al cuadrado respecto al cuantil ajustado, un valor extremo de \(y\) tiene una influencia acotada, a diferencia de su influencia sin límite sobre una media de MCO.
Hacerlo en R
quantreg::rq() sigue de cerca la sintaxis de lm(), fijando el cuantil de interés a través del argumento tau:
library(quantreg)
data(engel)

# Regresión de la mediana (tau = 0,5)
rq(foodexp ~ income, data = engel, tau = 0.5)

# Varios cuantiles a la vez
rq(foodexp ~ income, data = engel, tau = c(0.1, 0.5, 0.9))

# Comparar con la media condicional
lm(foodexp ~ income, data = engel)
💡 Los coeficientes de la regresión cuantílica se interpretan cuantil a cuantil
Un coeficiente de rq(y ~ x, tau = 0.9) significa: manteniendo fijos los demás predictores, un aumento de una unidad en \(x\) se asocia con un cambio de esa magnitud en el percentil 90 de \(y\), no en su media. Los errores estándar de la regresión cuantílica suelen obtenerse por bootstrap (la opción por defecto de rq) en lugar de con las fórmulas cerradas que se usan en MCO, ya que la función de verificación no es derivable en cero.

