Métricas de evaluación de regresión (MAE, MSE, RMSE, MAPE, WAPE)
Los modelos de clasificación se evalúan con una matriz de confusión y la curva ROC/AUC. Los modelos de regresión y previsión, donde la predicción es un número en vez de una clase, se evalúan por lo lejos que suele quedar ese número del valor real. MAE, MSE, RMSE, MAPE y WAPE son las cinco métricas que responden a eso, y no siempre coinciden en qué modelo es mejor.
MAE, MSE y RMSE
Estas tres trabajan directamente con los errores de predicción \(e_i = y_i - \hat{y}_i\), en las unidades originales de \(y\), o en unidades al cuadrado para el MSE:
\[\text{MAE} = \frac{1}{n}\sum_{i=1}^n |e_i|, \qquad \text{MSE} = \frac{1}{n}\sum_{i=1}^n e_i^2, \qquad \text{RMSE} = \sqrt{\text{MSE}}\]
El MAE trata cada unidad de error por igual. El MSE eleva el error al cuadrado primero, así que un único fallo grande pesa mucho más que varios fallos pequeños, lo que hace que el MSE (y el RMSE, su raíz cuadrada, de vuelta a las unidades originales de \(y\)) sea mucho más sensible a valores atípicos que el MAE. El RMSE es el que más se reporta de los tres porque está en las mismas unidades que \(y\) pero sigue penalizando fuerte los errores grandes, un término medio útil.
MAPE y WAPE: métricas basadas en porcentajes
El MAE, el MSE y el RMSE dependen de la escala: un RMSE de 50 es excelente prediciendo precios de viviendas y catastrófico prediciendo ventas diarias de café. El MAPE y el WAPE resuelven esto expresando el error como un porcentaje del valor real, lo que los hace comparables entre series o conjuntos de datos de escalas completamente distintas:
\[\text{MAPE} = \frac{100\%}{n}\sum_{i=1}^n \left|\frac{e_i}{y_i}\right|, \qquad \text{WAPE} = 100\% \cdot \frac{\sum_{i=1}^n |e_i|}{\sum_{i=1}^n |y_i|}\]
La diferencia parece pequeña, el MAPE promedia los errores porcentuales individuales, el WAPE suma los errores absolutos y los valores reales absolutos por separado antes de dividir, pero tiene una consecuencia práctica grande que se explica más abajo.
Ejemplo resuelto: una previsión sesgada y ruidosa
Calcular las cinco métricas sobre las mismas predicciones muestra cómo ordenan de forma distinta los mismos errores.
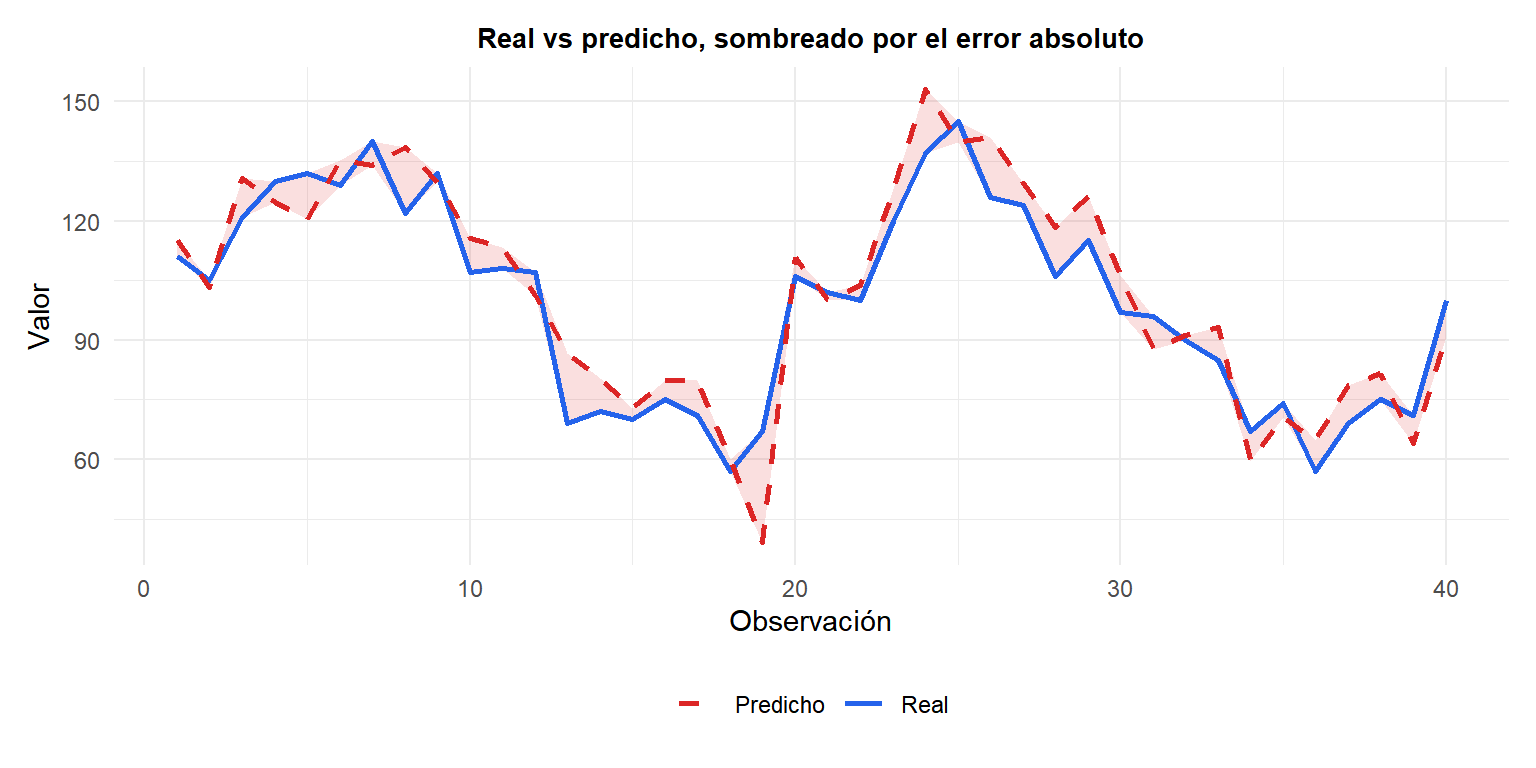
Una serie simulada de \(n=40\) valores reales (entre 57 y 145) y una previsión con un pequeño sesgo al alza (la previsión media es unas 2 unidades demasiado alta) más ruido aleatorio. Las cinco métricas calculadas sobre los mismos datos:
| Métrica | Valor |
|---|---|
| MAE | 7,95 |
| MSE | 89,64 |
| RMSE | 9,47 |
| MAPE | 8,64% |
| WAPE | 7,97% |
Aquí MAPE y WAPE coinciden a grandes rasgos, ambos dicen que el error típico ronda el 8% del valor real, porque todos los valores reales de esta serie están cómodamente lejos de cero (mínimo 57).

Dónde falla el MAPE y el WAPE no
El MAPE divide por cada valor real individual, así que un objetivo de previsión que a veces está cerca de cero hace que el MAPE se dispare, aunque el error absoluto en ese punto sea diminuto.
⚠️ Un único valor real cercano a cero puede dejar sin sentido al MAPE
Toma un conjunto de 20 valores reales, la mayoría entre 30 y 90, pero dos de ellos iguales a 1 y 0,5. La previsión falla en esos dos puntos por solo unas pocas unidades en términos absolutos, igual que en el resto, dando un \(\text{MAE} = 3{,}95\). Pero los errores porcentuales en esos dos puntos por sí solos son del \(522{,}5\%\) y el \(862{,}5\%\), que arrastran el \(\text{MAPE}\) global hasta el \(76{,}0\%\), un número que sugiere un modelo gravemente roto aunque las predicciones sean, en términos absolutos, perfectamente normales. El \(\text{WAPE}\) sobre los mismos datos exactos se queda en el \(7{,}6\%\), porque suma primero todos los errores absolutos y todos los valores reales absolutos, así que un par de denominadores diminutos ya no pueden dominar el resultado.
Por eso el WAPE (también llamado MAPE ponderado) es la opción estándar en previsión de demanda y retail, donde productos o días concretos con ventas reales cercanas a cero son algo habitual, no un caso extremo. El MAPE sigue siendo útil cuando todos los valores reales están claramente lejos de cero y un porcentaje resulta más interpretable que las unidades brutas.
Hacerlo en R
Ninguna de estas tiene una única función universal en R base, cada una es una fórmula de una línea:
mae  <- mean(abs(actual - pred))
mse  <- mean((actual - pred)^2)
rmse <- sqrt(mse)
mape <- mean(abs((actual - pred) / actual)) * 100
wape <- sum(abs(actual - pred)) / sum(abs(actual)) * 100

# Paquetes que las agrupan todas, con nombres consistentes
library(Metrics)
mae(actual, pred); rmse(actual, pred)

library(yardstick)
# yardstick trabaja sobre un data frame con columnas de verdad/estimacion
💡 El R cuadrado es un tipo de métrica completamente distinto
El R cuadrado mide la proporción de varianza explicada, un número relativo y sin unidades, mientras que el MAE, el RMSE, el MAPE y el WAPE miden directamente el tamaño típico del error. Un modelo puede tener un R cuadrado alto y un RMSE grande al mismo tiempo si la propia respuesta tiene mucha varianza, los dos tipos de métrica responden preguntas distintas y normalmente se reportan juntos, no como sustitutos el uno del otro.