R cuadrado y R cuadrado ajustado explicados
El R cuadrado es la proporción de varianza de la respuesta que explica un modelo de regresión. Es uno de los primeros números que se mira tras ajustar un modelo, y uno de los que peor se interpreta: siempre sube al añadir un predictor, incluso uno inútil, que es justo lo que el R cuadrado ajustado corrige. Esta entrada amplía la regresión lineal simple.
Qué mide el R cuadrado
El \(R^2\) compara el error que queda tras el modelo con la varianza total que había que explicar de partida:
\[R^2 = 1 - \frac{SS_{res}}{SS_{tot}} = 1 - \frac{\sum_{i=1}^n (y_i-\hat y_i)^2}{\sum_{i=1}^n (y_i-\bar y)^2}\]
\(SS_{res}\) es la suma de los residuos al cuadrado que queda tras el modelo, \(SS_{tot}\) es la suma total de las desviaciones al cuadrado respecto a la media, la varianza que el modelo tenía disponible para explicar de partida. El \(R^2\) compara ambas: es la fracción de esa varianza total que el modelo consigue explicar.
En un ajuste dentro de la muestra, el \(R^2\) queda entre 0 (el modelo no explica nada más allá de la media) y 1 (el modelo reproduce exactamente cada valor observado). Puede volverse negativo en datos nuevos a los que el modelo no se ajustó, si el modelo llega a predecir peor que simplemente usar la media de entrenamiento cada vez.
Por qué el R cuadrado siempre sube al añadir un predictor
Los mínimos cuadrados ordinarios eligen los coeficientes para minimizar \(SS_{res}\). Añadir cualquier predictor, incluso uno que sea puro ruido aleatorio sin relación alguna con la respuesta, le da a los mínimos cuadrados un coeficiente más que puede fijar en el valor que mejor ajuste los datos de entrenamiento. Lo peor que pueden hacer los mínimos cuadrados con un predictor nuevo es fijar su coeficiente exactamente en cero, reproduciendo el ajuste anterior. En la práctica, con una muestra finita, casi siempre habrá algún coeficiente distinto de cero que ajuste marginalmente mejor por puro azar. \(SS_{res}\) solo puede mantenerse igual o reducirse, así que el \(R^2\) solo puede mantenerse igual o subir, nunca puede bajar al añadir un predictor a los mismos datos.
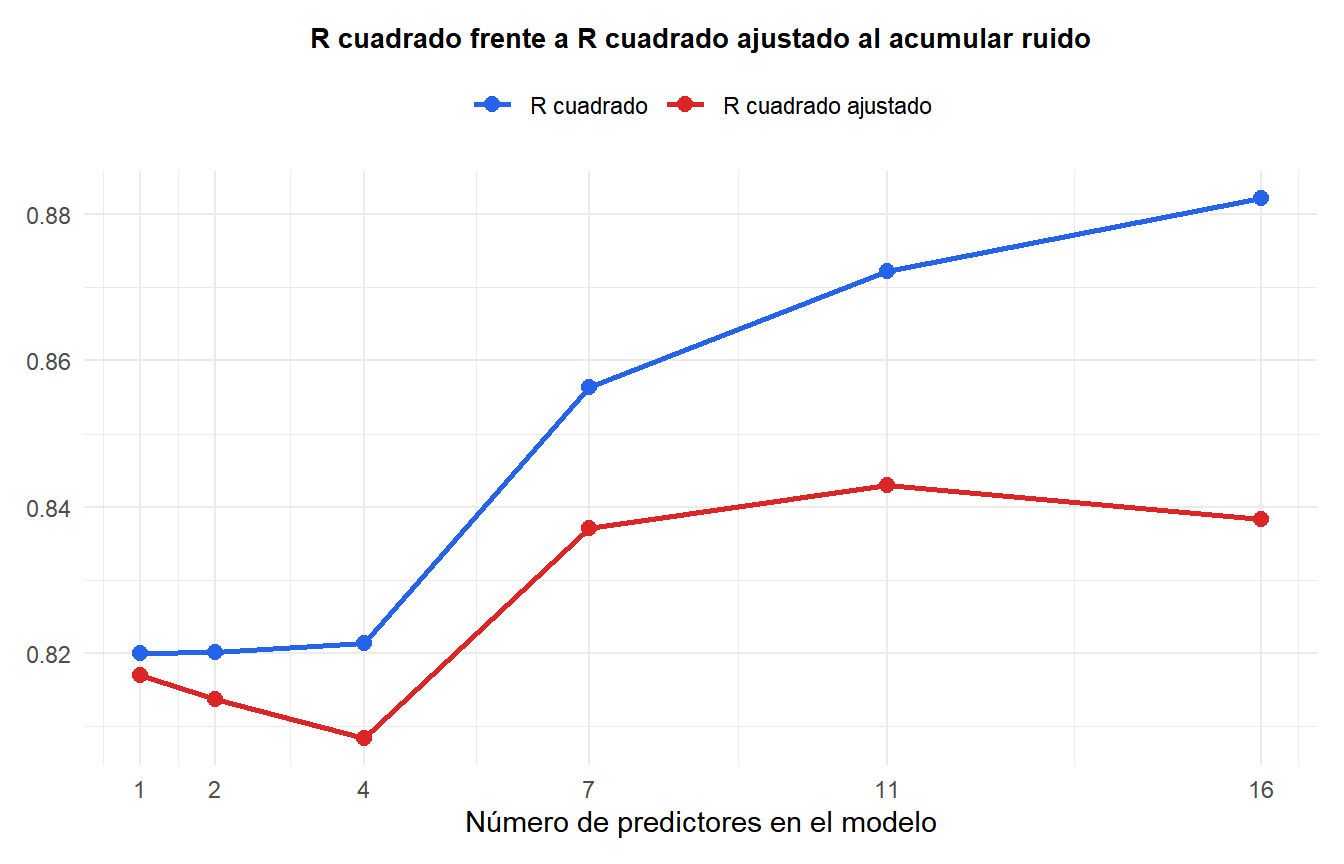
Un conjunto de datos de \(n=60\) estudiantes tiene una relación real entre las horas estudiadas y la nota del examen, más ruido natural: score = 40 + 5*hours_studied + noise. Partiendo de ese único predictor genuino, se añaden encima, uno tras otro, predictores de ruido aleatorio, columnas de números sin ninguna relación con la nota:
| Predictores en el modelo | \(R^2\) | \(R^2\) ajustado |
|---|---|---|
| 1 (solo horas estudiadas) | 0,820 | 0,817 |
| 2 (+1 columna de ruido) | 0,820 | 0,814 |
| 4 (+3 columnas de ruido) | 0,821 | 0,808 |
| 7 (+6 columnas de ruido) | 0,856 | 0,837 |
| 11 (+10 columnas de ruido) | 0,872 | 0,843 |
| 16 (+15 columnas de ruido) | 0,882 | 0,838 |
El \(R^2\) nunca baja en la tabla, tal como predice la mecánica anterior, aunque 15 de los 16 predictores finales sean ruido sin ninguna conexión real con la nota. El \(R^2\) ajustado cuenta una historia distinta en las tres primeras filas: cae de 0,817 a 0,808 al añadir las primeras columnas de ruido, señalando correctamente que esos predictores no aportan nada. Pero no es un trinquete de un solo sentido como el \(R^2\) normal: con 15 columnas de ruido candidatas y solo 60 observaciones, unas cuantas encajan con los datos lo bastante bien por pura casualidad como para que el \(R^2\) ajustado se recupere e incluso supere su valor inicial más adelante en la tabla. Eso mismo es una advertencia útil: cuantos más predictores candidatos se prueben sobre una muestra modesta, más probable es que alguno encaje solo por coincidencia.

La fórmula del R cuadrado ajustado
El R cuadrado ajustado toma la misma fórmula y multiplica el término de error por un factor que crece con el número de predictores:
\[R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}\]
donde \(n\) es el tamaño de la muestra y \(p\) es el número de predictores. El factor \(\frac{n-1}{n-p-1}\) vale siempre al menos 1 cuando \(p \geq 1\), lo que significa que el R cuadrado ajustado es siempre menor o igual que el R cuadrado normal: solo puede tirar del número hacia abajo, nunca hacia arriba, respecto a la versión sin ajustar. Cuantos más predictores haya en relación con el tamaño de la muestra, mayor es esa penalización. A medida que \(p\) se acerca a \(n-1\), la penalización crece sin límite, justo lo que explica que el R cuadrado ajustado oscile mucho más que el R cuadrado normal en la tabla anterior una vez que el modelo tiene muchos predictores en relación con sus 60 observaciones.
⚠️ Un R cuadrado alto no significa que un modelo sea bueno
El \(R^2\) solo mide cuánta varianza dentro de la muestra queda explicada, no dice nada sobre si el modelo tiene la forma funcional correcta, si sus coeficientes son fiables, o si predecirá bien con datos nuevos. Un modelo puede alcanzar un \(R^2\) alto estando mal especificado, y un modelo puede tener un \(R^2\) modesto y aun así ser el mejor ajuste posible a datos que simplemente son ruidosos por naturaleza. Un \(R^2\) de 0,3 en un campo como las ciencias sociales, donde los resultados dependen de incontables factores no medidos, puede ser un resultado genuinamente bueno. Consulta los diagnósticos de regresión para evaluar de verdad si un modelo es adecuado, en lugar de leer el \(R^2\) como un veredicto por sí solo.
Hacerlo en R
Los dos números salen directamente de summary(), y las fórmulas manuales confirman exactamente de dónde vienen:
fit <- lm(score ~ hours_studied, data = df)
summary(fit)$r.squared
summary(fit)$adj.r.squared

# Comprobación manual con la fórmula
ss_res <- sum(residuals(fit)^2)
ss_tot <- sum((df$score - mean(df$score))^2)
r2 <- 1 - ss_res / ss_tot

n <- nrow(df)
p <- 1
adj_r2 <- 1 - (1 - r2) * (n - 1) / (n - p - 1)
💡 R cuadrado y R cuadrado ajustado, reglas prácticas
Usa el \(R^2\) normal para describir cuánta varianza explica un modelo ya fijado. Usa el R cuadrado ajustado en vez del R cuadrado normal siempre que compares modelos con distinto número de predictores, ya que el R cuadrado normal favorece mecánicamente al modelo más grande aunque los predictores extra no aporten nada real. Ninguno de los dos indica que el modelo tenga la forma funcional correcta, consulta regresión frente a correlación para una distinción relacionada y que se confunde a menudo: la correlación mide la asociación entre dos variables, el \(R^2\) mide qué tan bien ajusta un modelo de regresión completo.

