Regresión vs correlación, cuál es la diferencia
La correlación y la regresión describen cómo se mueven juntas dos variables, y a menudo se usan como si fueran lo mismo, pero responden a preguntas distintas. La correlación pregunta con qué fuerza y en qué dirección están asociadas dos variables. La regresión pregunta qué ecuación predice una variable a partir de la otra. Esta entrada es el punto de partida natural antes de la regresión lineal simple.
Dos preguntas distintas
El coeficiente de correlación de Pearson \(r\) resume la fuerza y la dirección de una asociación lineal entre dos variables en una escala de \(-1\) a \(1\), sin ninguna noción de cuál variable, si alguna, predice o causa la otra. La regresión, en cambio, ajusta una recta (o una curva más compleja) que permite introducir una variable y obtener un valor predicho para la otra. La correlación es un único número simétrico. La regresión es una ecuación, y depende de qué variable elijas predecir.
Ejemplo resuelto: horas de estudio y nota del examen
El mismo conjunto de datos pequeño, calculado como correlación y como regresión, muestra exactamente cómo se relacionan ambos números.
Una clase simulada de \(n=30\) estudiantes registra las horas de estudio y la nota resultante del examen.
Correlación entre horas de estudio y nota: \(r = 0,791\).
Regresión de la nota sobre las horas, lm(score ~ hours):
| Coeficiente | Estimación |
|---|---|
| Intercepto | 44,66 |
| Pendiente (horas) | 4,10 |
La recta ajustada es \(\widehat{\text{nota}} = 44,66 + 4,10 \times \text{horas}\): cada hora adicional de estudio se asocia, en promedio, con unos 4,1 puntos más.

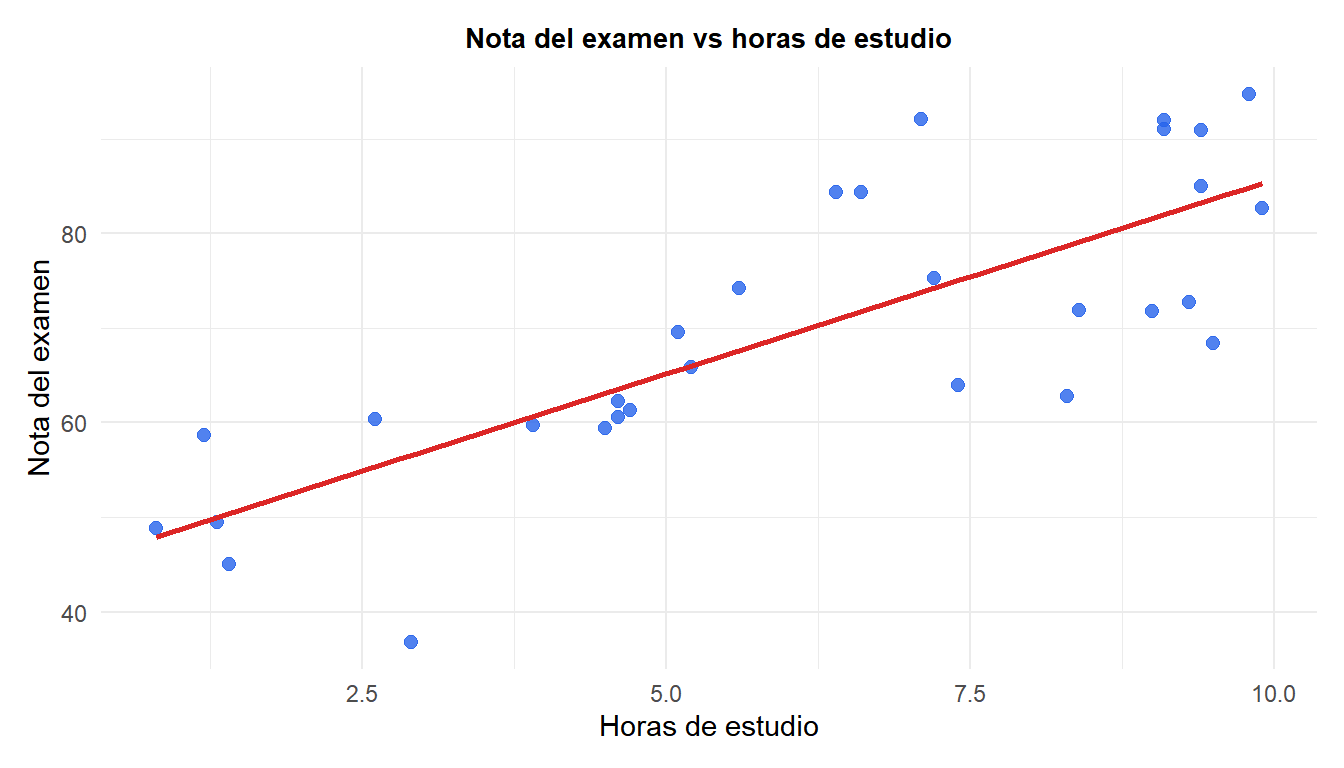
El puente entre ambos números es directo. En regresión lineal simple, la pendiente es la correlación reescalada por el cociente de las desviaciones típicas:
\[b_1 = r \cdot \frac{s_y}{s_x}\]
Aquí \(s_{\text{horas}} = 2,92\) y \(s_{\text{nota}} = 15,18\), así que \(b_1 = 0,791 \times \frac{15,18}{2,92} = 4,10\), exactamente la pendiente ajustada de arriba. Y, específicamente en regresión lineal simple, elevar al cuadrado la correlación da el \(R^2\) del modelo: \(r^2 = 0,791^2 = 0,625\), exactamente el \(R^2\) que reporta lm() para este modelo.
Diferencias estructurales clave
- Simetría. La correlación es simétrica: \(\text{cor}(x,y) = \text{cor}(y,x)\). La regresión no lo es: regresionar la nota sobre las horas da una pendiente de 4,10, pero regresionar las horas sobre la nota da una pendiente completamente distinta, 0,152, que no es simplemente su recíproco (\(1/4,10 = 0,244\)). Qué variable llamas predictor y cuál llamas resultado cambia la ecuación.
- Unidades. La correlación no tiene unidades y siempre está entre \(-1\) y \(1\), sea cual sea la escala de \(x\) e \(y\). Los coeficientes de la regresión llevan las unidades de las variables: la pendiente aquí es literalmente “puntos por hora”, y cambia si reescalas cualquiera de las dos variables (medir las horas en minutos dividiría la pendiente entre 60).
- Qué obtienes. La correlación da un único número que describe cuán estrechamente se mueven juntas dos variables. La regresión da una ecuación real que puedes usar para generar una predicción de una nueva observación.
- Alcance. La correlación de Pearson simple solo describe un par de variables. La regresión se generaliza de forma natural a muchos predictores a la vez, consulta la regresión lineal simple y su extensión a varios predictores.
⚠️ Una correlación alta no hace fiable una regresión
Una correlación fuerte, y la recta de regresión construida sobre ella, solo describe una asociación. Ninguna de las dos indica que las horas de estudio causen que la nota suba, un tercer factor (motivación, conocimientos previos) podría explicar ambas cosas. Es la misma trampa que hay detrás de correlaciones estadísticamente fuertes pero completamente absurdas, explorada en profundidad en El Expediente de las Correlaciones. Antes de confiar en una recta de regresión para predecir, comprueba también que la relación sea razonablemente lineal y que ningún pequeño grupo de puntos esté distorsionando el ajuste, consulta los diagnósticos de regresión.
Hacerlo en R
Calcular ambas cosas una junto a la otra, y comprobar que la correlación al cuadrado coincide con el R-cuadrado, cabe en pocas líneas:
💡 Correlación y regresión en R
cor(hours, score)

fit <- lm(score ~ hours)
summary(fit)

# En regresión lineal simple, la correlación al cuadrado es el R-cuadrado
cor(hours, score)^2
summary(fit)$r.squared
