Regresión polinómica
La regresión polinómica ajusta una relación curva entre un predictor y una respuesta añadiendo potencias de \(x\), \(x^2\), \(x^3\), y así sucesivamente, como predictores extra del modelo. La curva ajustada se dobla, pero el modelo subyacente se sigue estimando por mínimos cuadrados ordinarios. Esta entrada explica por qué, cómo detectar problemas de sobreajuste y extrapolación, y cómo las potencias de \(x\) crean su propia versión de multicolinealidad.
Sigue siendo un modelo lineal
El modelo de regresión polinómica de grado \(d\):
\[y_i = \beta_0 + \beta_1 x_i + \beta_2 x_i^2 + \dots + \beta_d x_i^d + \varepsilon_i\]
El punto crítico, explicado con más detalle en regresión no lineal, es que un modelo es lineal o no lineal según si es lineal en los parámetros \(\beta_j\), no según si la curva ajustada es una línea recta. Aquí, \(x^2\) y \(x^3\) son simplemente columnas adicionales de predictores: el modelo sigue siendo \(y = \mathbf{X}\boldsymbol{\beta} + \varepsilon\) con una \(\mathbf{X}\) más grande, así que los mínimos cuadrados ordinarios se aplican directamente y existe una solución cerrada, a diferencia de los modelos genuinamente no lineales como \(y = \beta_0 e^{\beta_1 x}\), que necesitan un algoritmo iterativo.
Ejemplo resuelto: fertilizante y rendimiento del cultivo
Ajustar una línea recta, una cuadrática y un grado innecesariamente alto a los mismos datos curvos muestra exactamente dónde falla cada uno.
Un conjunto de datos simulado de \(n=45\) parcelas registra el fertilizante aplicado (kg/ha, de 0 a unos 20) y el rendimiento de cultivo resultante. La relación real sube con el fertilizante hasta un punto, y luego cae conforme el exceso de fertilizante empieza a perjudicar al cultivo, un patrón agronómico real y bien conocido que una línea recta no puede capturar.
Ajustando tres modelos a los mismos datos:
| Grado | R cuadrado | R cuadrado ajustado |
|---|---|---|
| 1 (línea recta) | 0,166 | 0,147 |
| 2 (cuadrático) | 0,833 | 0,825 |
| 9 | 0,859 | 0,823 |
El salto de grado 1 a grado 2 es real y grande: un test F que compara ambos modelos anidados da \(F(1,42) = 168,24\), \(p < 0,001\), el grado 2 ajusta muchísimo mejor. Pero pasar de grado 2 a grado 9 apenas mueve el R cuadrado (0,833 a 0,859) mientras que el R cuadrado ajustado, que penaliza los predictores extra, incluso baja ligeramente (0,825 a 0,823): los siete términos adicionales no aportan poder explicativo real, solo ajustan el ruido.
El propio ajuste cuadrático: \(\widehat{\text{rendimiento}} = 16{,}53 + 9{,}84 \cdot \text{fertilizante} - 0{,}42 \cdot \text{fertilizante}^2\), una curva que sube y luego baja, exactamente la forma que tiene el proceso real.

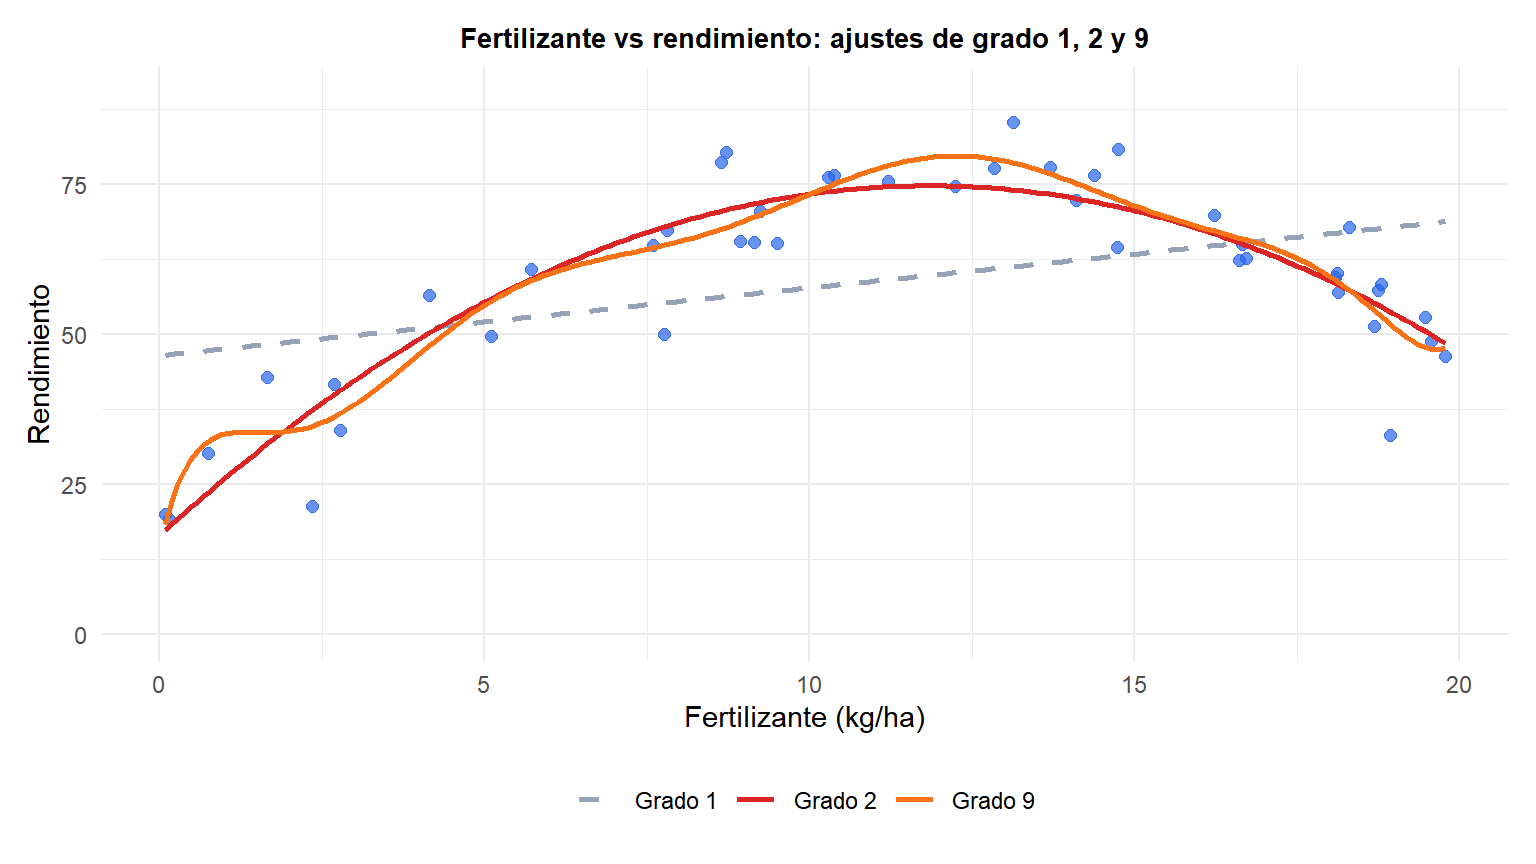
La línea de grado 1 (gris, discontinua) no puede curvarse, así que subajusta: se pierde por completo tanto la subida inicial como la caída final. La curva de grado 2 (roja) sigue de cerca la forma real de subida y bajada. La curva de grado 9 (naranja) oscila entre los puntos de datos, persiguiendo el ruido en vez del patrón subyacente, algo especialmente visible cerca de los extremos de los datos.
Dos peligros reales: sobreajuste y extrapolación
El ajuste de grado 9 de arriba ya insinuaba ambos problemas, persiguiendo el ruido dentro del rango de datos y disparándose justo fuera de él.
⚠️ Un grado alto sobreajusta, y extrapola peor que una línea recta
Sobreajuste. Un grado demasiado alto ajusta el ruido de la muestra, no la relación real, y su R cuadrado ajustado puede incluso bajar mientras el R cuadrado bruto sigue subiendo, exactamente lo que ha ocurrido arriba al pasar de grado 2 a grado 9. Comprobar el error de un modelo con datos con los que no se ha ajustado, consulta validación cruzada, detecta esto de forma mucho más fiable que mirar solo el R cuadrado dentro de la muestra.
Extrapolación. Los valores de fertilizante observados van de unos 0,1 a 19,8. Al predecir tan solo tres unidades por encima de ese máximo (fertilizante = 22,8), donde la curva real sigue siendo un modesto 27,8:
| Modelo | Predicción en fertilizante = 22,8 |
|---|---|
| Grado 1 | 72,1 |
| Grado 2 | 24,9 |
| Grado 9 | 820,4 |
El modelo de grado 2, que coincide con la forma real, se queda cerca del valor verdadero. La línea de grado 1, que nunca ha visto la caída, se dispara muchísimo por encima. El modelo de grado 9 explota hasta un valor absurdo de 820,4: los polinomios de grado alto se curvan bruscamente justo en los extremos de los datos de entrenamiento, y esa curvatura se dispara a valores extremos casi inmediatamente fuera de ellos, un modo de fallo mucho más peligroso que el de una línea recta.
Los términos polinómicos crean su propia multicolinealidad
\(x\) y \(x^2\) se construyen a partir de la misma variable, así que están muy correlacionados por construcción: aquí, \(\text{cor}(\text{fertilizante}, \text{fertilizante}^2) = 0{,}968\). Ajustar fert + I(fert^2) directamente da a ambos términos un VIF de 15,8, muy por encima del umbral de alarma habitual de 5 a 10.
Esto no perjudica la curva ajustada ni sus predicciones, exactamente igual que con cualquier otra multicolinealidad, pero sí hace que los coeficientes lineal y cuadrático individuales sean más difíciles de interpretar y menos estables. Centrar \(x\) primero (restar su media antes de elevarla al cuadrado) reduce bastante la correlación; usar polinomios ortogonales, que es lo que hace poly() de R por defecto, la elimina casi por completo por construcción, sin cambiar en nada la curva ajustada.
Hacerlo en R
Ajustar las versiones ortogonal y bruta, comparar grados y comprobar el VIF cabe todo en pocas líneas:
💡 Ajustar y comparar grados polinómicos en R
# Polinomio ortogonal (recomendado, evita la colinealidad de arriba)
fit2 <- lm(yield ~ poly(fert, 2), data = df)

# Polinomio bruto equivalente (misma curva ajustada, coeficientes correlacionados)
fit2_raw <- lm(yield ~ fert + I(fert^2), data = df)

# Comparar grados anidados con un test F
fit1 <- lm(yield ~ fert, data = df)
anova(fit1, fit2_raw)

# O comparar directamente el R cuadrado ajustado, consulta:
# /aprendizaje-automatico/r-cuadrado-r-cuadrado-ajustado/
summary(fit1)$adj.r.squared
summary(fit2_raw)$adj.r.squared

# Multicolinealidad entre los términos polinómicos
library(car)
vif(fit2_raw)
