Método de los momentos
El método de los momentos estima los parámetros de una distribución igualando sus momentos teóricos, la media, la varianza, y así sucesivamente, a los momentos observados en la muestra, y despejando los parámetros. Es más antiguo y más sencillo que la estimación máximo verosímil: normalmente solo necesita álgebra, sin cálculo diferencial ni optimización numérica.
La receta general
Para una distribución con \(k\) parámetros desconocidos, se igualan los primeros \(k\) momentos teóricos a los momentos muestrales correspondientes, y se resuelve el sistema resultante de \(k\) ecuaciones para los \(k\) parámetros:
\[E[X^j] = \frac{1}{n}\sum_{i=1}^n x_i^j, \qquad j = 1, \ldots, k\]
El lado izquierdo es una fórmula conocida en función de los parámetros, ya que viene de la propia definición de la distribución. El lado derecho es simplemente un número, calculado directamente a partir de la muestra. Cada ecuación fija un parámetro más, así que una distribución con 2 parámetros desconocidos necesita los dos primeros momentos; una con 1 parámetro desconocido solo necesita la media.
Ejemplo resuelto: ajustar una distribución Gamma
La distribución Gamma tiene dos parámetros, así que necesita los dos primeros momentos: la media y la varianza.
Una muestra simulada de \(n=200\) observaciones de una distribución Gamma con forma real \(k=4\) y tasa real \(=0,5\) (media \(8\), varianza \(16\)). Usando las propias fórmulas de los momentos de la Gamma, \(E[X] = k\theta\) y \(\text{Var}(X) = k\theta^2\) (con escala \(\theta = 1/\text{tasa}\)), despejando los dos parámetros a partir de la media muestral \(\bar{x}\) y la varianza muestral \(s^2\) se obtiene:
\[\hat{k}_{MM} = \frac{\bar{x}^2}{s^2}, \qquad \hat{\theta}_{MM} = \frac{s^2}{\bar{x}}\]
En esta muestra, \(\bar{x} = 7{,}691\) y \(s^2 = 14{,}162\), así que:
| Parámetro | Método de los momentos | Máxima verosimilitud | Valor real |
|---|---|---|---|
| Forma (\(k\)) | 4,176 | 4,010 | 4 |
| Tasa | 0,543 | 0,521 | 0,5 |
Ambos métodos quedan cerca del valor real y cerca entre sí; la estimación del método de los momentos no es idéntica a la de máxima verosimilitud, optimizan criterios distintos, pero con una muestra de tamaño razonable de una distribución bien comportada suelen coincidir con unos pocos puntos porcentuales de diferencia.

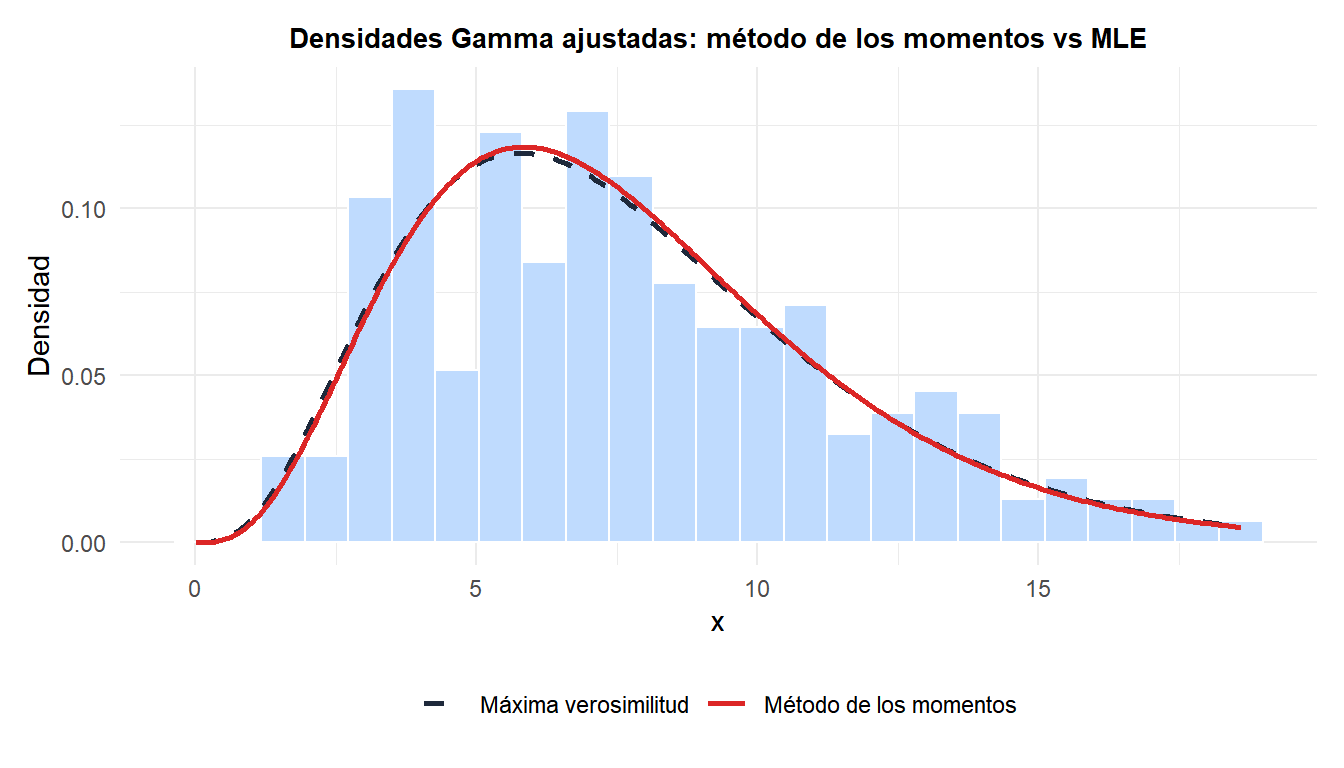
Las dos curvas ajustadas casi se solapan. Para una muestra razonablemente grande y bien especificada, elegir entre los dos métodos rara vez cambia la conclusión práctica, la diferencia se nota en la eficiencia (cuánto oscilan las estimaciones de una muestra a otra), no en un ajuste visiblemente distinto sobre este conjunto de datos concreto.
Dónde falla el método de los momentos
Igualar momentos muestrales y teóricos es sencillo, pero esa sencillez tiene costes reales.
⚠️ Los estimadores por el método de los momentos no siempre son válidos, y rara vez son tan eficientes como MLE
Como el método de los momentos resuelve el álgebra que produzcan las ecuaciones de momentos, puede devolver ocasionalmente una estimación sin sentido, por ejemplo un parámetro de varianza implícito negativo a partir de una muestra pequeña o atípica, algo que un ajuste de MLE bien restringido normalmente evita. Tampoco suele ser tan eficiente como MLE: para la misma muestra, el estimador por el método de los momentos suele tener una varianza muestral mayor, lo que significa que oscila más de una muestra a otra. En la práctica, las estimaciones por el método de los momentos se usan a menudo sobre todo como buenos valores iniciales para una optimización iterativa de MLE, más que como la estimación final que se reporta.
Hacerlo en R
El método de los momentos no necesita más que mean() y var(); máxima verosimilitud necesita un optimizador, normalmente escondido dentro de una función de ajuste:
x <- rgamma(200, shape = 4, rate = 0.5)

# Metodo de los momentos, algebra en forma cerrada
xbar <- mean(x)
s2   <- var(x)
k_hat_mom     <- xbar^2 / s2
theta_hat_mom <- s2 / xbar

# Maxima verosimilitud, mediante optimizacion numerica por debajo
library(MASS)
fit_mle <- fitdistr(x, "gamma")
fit_mle$estimate
💡 Por qué MLE se convirtió en la opción por defecto de todas formas
Si el método de los momentos es más sencillo, ¿por qué es MLE el que viene integrado en glm(), fitdistr(), y casi cualquier otra función de ajuste moderna? Porque la ventaja en eficiencia de MLE, lograr la menor varianza muestral posible entre los estimadores consistentes a medida que crece la muestra, generalmente pesa más que la comodidad del álgebra en forma cerrada, ahora que los ordenadores hacen que la optimización numérica sea prácticamente gratis. El método de los momentos sigue ganándose su sitio para estimaciones rápidas a ojo, para distribuciones donde MLE no tiene forma cerrada y necesita un valor inicial razonable, y para enseñar la idea central, igualar los propios momentos de los datos, antes de introducir la verosimilitud.