Esperanza y varianza de una variable aleatoria
La esperanza \(E[X]\) resume el centro de la distribución de una variable aleatoria: su media a largo plazo si la repitiéramos infinitas veces. La varianza \(\text{Var}(X)\) resume su dispersión alrededor de ese centro. Ambas se construyen directamente sobre la función de masa de probabilidad y la función de densidad de probabilidad ya vistas en esta sección.
La esperanza
La esperanza es una media ponderada por probabilidad de cada resultado posible, definida de forma distinta según si \(X\) es discreta o continua:
\[E[X] = \sum_x x \cdot p(x) \quad \text{(discreta)} \qquad\qquad E[X] = \int_{-\infty}^{\infty} x \, f(x) \, dx \quad \text{(continua)}\]
En ambos casos la idea es la misma: multiplicar cada valor posible por lo probable que es, y sumar (o integrar) todo. \(E[X]\) también se llama la media de la variable aleatoria, y a menudo se escribe \(\mu\).
La varianza
La varianza mide cuánto se alejan típicamente los valores de \(X\) respecto a \(E[X]\), usando distancias al cuadrado para que las desviaciones por encima y por debajo de la media no se cancelen entre sí:
\[\text{Var}(X) = E\big[(X - E[X])^2\big]\]
Desarrollando el cuadrado se obtiene el atajo de cálculo habitual, usado en la práctica mucho más que la propia definición:
\[\text{Var}(X) = E[(X-E[X])^2] = E[X^2] - 2E[X]E[X] + (E[X])^2 = E[X^2] - (E[X])^2\]
La desviación típica \(SD(X) = \sqrt{\text{Var}(X)}\) devuelve la dispersión a las unidades originales de \(X\), ya que la varianza está en unidades al cuadrado.
Propiedades clave
Un puñado de reglas algebraicas facilitan trabajar con la esperanza y la varianza sin tener que recalcular una suma o integral cada vez:
- Linealidad de la esperanza: \(E[aX + b] = a E[X] + b\). Esto se cumple siempre, para cualquier \(X\), incluso cuando \(X\) se construye a partir de otras variables aleatorias dependientes, lo que la hace tan útil.
- Varianza bajo una transformación lineal: \(\text{Var}(aX + b) = a^2 \text{Var}(X)\). La constante \(b\) desplaza los datos pero no cambia su dispersión, así que desaparece por completo; el factor de escala \(a\) queda elevado al cuadrado porque la varianza en sí está en unidades al cuadrado.
- Suma de variables independientes: si \(X\) e \(Y\) son independientes, \(E[X+Y] = E[X] + E[Y]\) y \(\text{Var}(X+Y) = \text{Var}(X) + \text{Var}(Y)\). La aditividad de la esperanza no necesita ningún supuesto de independencia; la de la varianza sí, la dependencia entre \(X\) e \(Y\) introduce un término de covarianza que esta suma sencilla ignora.
Ejemplo resuelto: premios en un juego sencillo
Aplicar ambas fórmulas a una variable aleatoria discreta concreta muestra exactamente cómo coinciden el atajo y la definición original.
Un juego tiene cuatro premios posibles \(x\), cada uno con una probabilidad \(p(x)\) dada:
| \(x\) | \(p(x)\) | \(x \cdot p(x)\) | \((x - 4)^2 \cdot p(x)\) |
|---|---|---|---|
| -5 | 0,50 | -2,5 | 40,5 |
| 0 | 0,30 | 0 | 4,8 |
| 10 | 0,15 | 1,5 | 5,4 |
| 100 | 0,05 | 5 | 460,8 |
| Suma | 1,00 | 4,0 | 511,5 |
\[E[X] = \sum x \cdot p(x) = 4,0\]
\[E[X^2] = \sum x^2 \cdot p(x) = 527,5 \qquad \text{así que} \qquad \text{Var}(X) = 527,5 - 4,0^2 = 511,5\]
\[SD(X) = \sqrt{511,5} \approx 22,62\]
Un jugador pierde dinero en el 50% de las partidas (el premio de -5), y aun así la esperanza del juego es un 4,0 positivo, tirada hacia arriba por el resultado de probabilidad pequeña pero premio grande de 100. La desviación típica de unos 22,6 es más de cinco veces la propia media: es un juego de varianza alta donde una sola partida dice muy poco sobre lo que cabe esperar en promedio.

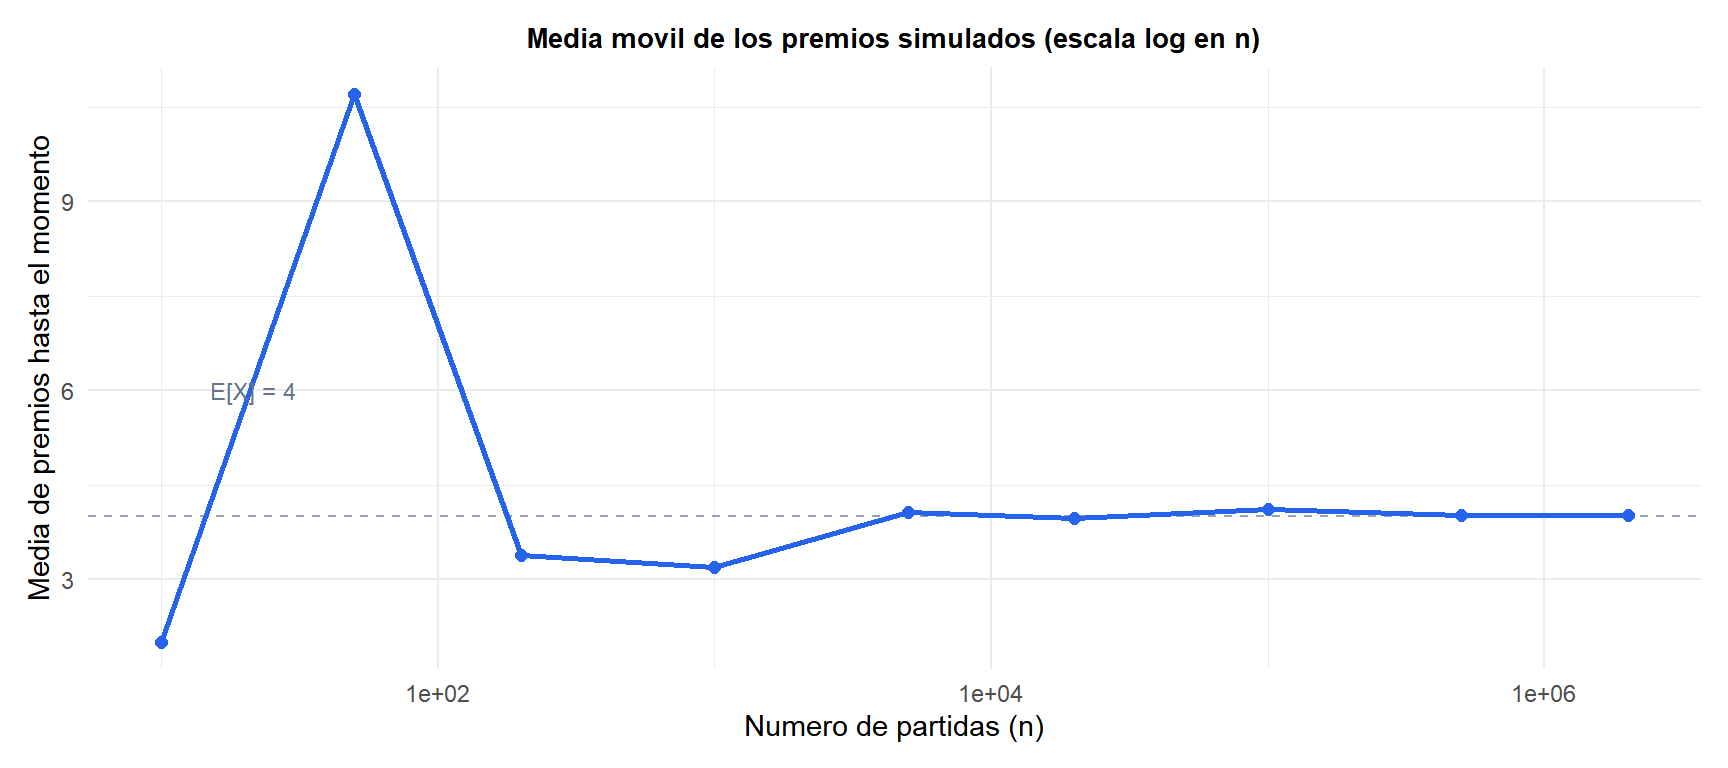
En 2.000.000 de partidas simuladas, la media empírica se estabiliza en 4,01 y la varianza empírica en 512,45, ambas muy cerca de los valores teóricos \(E[X]=4,0\) y \(\text{Var}(X)=511,5\). Esta es exactamente la interpretación que la ley de los grandes números da a \(E[X]\): es el valor al que converge la media muestral a medida que crece el número de repeticiones, no un valor que produzca una sola partida.
La esperanza no siempre es un resultado posible
La palabra “esperanza” invita a una lectura equivocada habitual. \(E[X]\) es una cantidad teórica, a nivel poblacional, y no hay ningún requisito de que \(X\) pueda llegar a valer eso realmente.
⚠️ Un dado justo nunca saca un 3,5
La esperanza de tirar un dado de seis caras justo es \(E[X] = (1+2+3+4+5+6)/6 = 3,5\), un valor que el dado no puede sacar físicamente. “Esperanza” aquí significa la media a largo plazo sobre muchas tiradas, no una predicción de lo que mostrará una tirada concreta. La misma lógica se aplica al ejemplo de los premios de arriba: ninguna partida individual de ese juego paga exactamente 4, solo la media de muchas partidas se acerca a ese valor.
Hacerlo en R
Ambas cantidades salen directamente del vector de probabilidades, sin necesitar ninguna función especial:
x <- c(-5, 0, 10, 100)
p <- c(0.5, 0.3, 0.15, 0.05)

EX  <- sum(x * p)                  # esperanza
EX2 <- sum(x^2 * p)                # E[X^2]
VarX <- EX2 - EX^2                 # varianza, formula del atajo
SDX  <- sqrt(VarX)                 # desviacion tipica

EX; VarX; SDX

# Definicion directa, deberia coincidir con VarX de arriba
sum((x - EX)^2 * p)

# Comprobacion por simulacion: la media y varianza empiricas convergen a EX y VarX
samples <- sample(x, size = 2e6, replace = TRUE, prob = p)
mean(samples)
var(samples)
💡 Esperanza y varianza de distribuciones habituales
Rara vez hace falta calcular esto desde cero para una distribución con nombre, cada una tiene una forma cerrada conocida: Binomial\((n,p)\) tiene \(E[X]=np\) y \(\text{Var}(X)=np(1-p)\); Poisson\((\lambda)\) tiene \(E[X]=\text{Var}(X)=\lambda\) (la media es igual a la varianza, una firma distintiva de la Poisson); para una Uniforme continua\((a,b)\), \(E[X]=(a+b)/2\) y \(\text{Var}(X)=(b-a)^2/12\). Las fórmulas generales de esta página son de donde salen esos atajos.