Amostragem por conglomerados
A amostragem por conglomerados seleciona grupos (conglomerados) em vez de unidades individuais. É a escolha prática quando não existe um marco amostral completo ou quando a dispersão geográfica torna a amostragem individual excessivamente cara. O custo é uma eficiência estatística menor: amostras por conglomerados contêm menos informação por unidade do que a AAS, porque as unidades dentro do mesmo conglomerado tendem a ser semelhantes entre si.
Quando a amostragem por conglomerados é necessária
A amostragem por conglomerados é usada quando:
- Não existe uma lista completa das unidades da população, mas há uma lista de grupos naturais (escolas, hospitais, municípios, empresas).
- A população está geograficamente dispersa e visitar unidades individuais é excessivamente caro.
- A conveniência administrativa exige trabalhar com grupos em vez de indivíduos.
Exemplos: pesquisas nacionais de saúde (amostram-se distritos e depois domicílios), pesquisa educacional (amostram-se escolas e depois alunos), pesquisa de mercado (amostram-se CEPs e depois domicílios).
Amostragem por conglomerados em um vs dois estágios
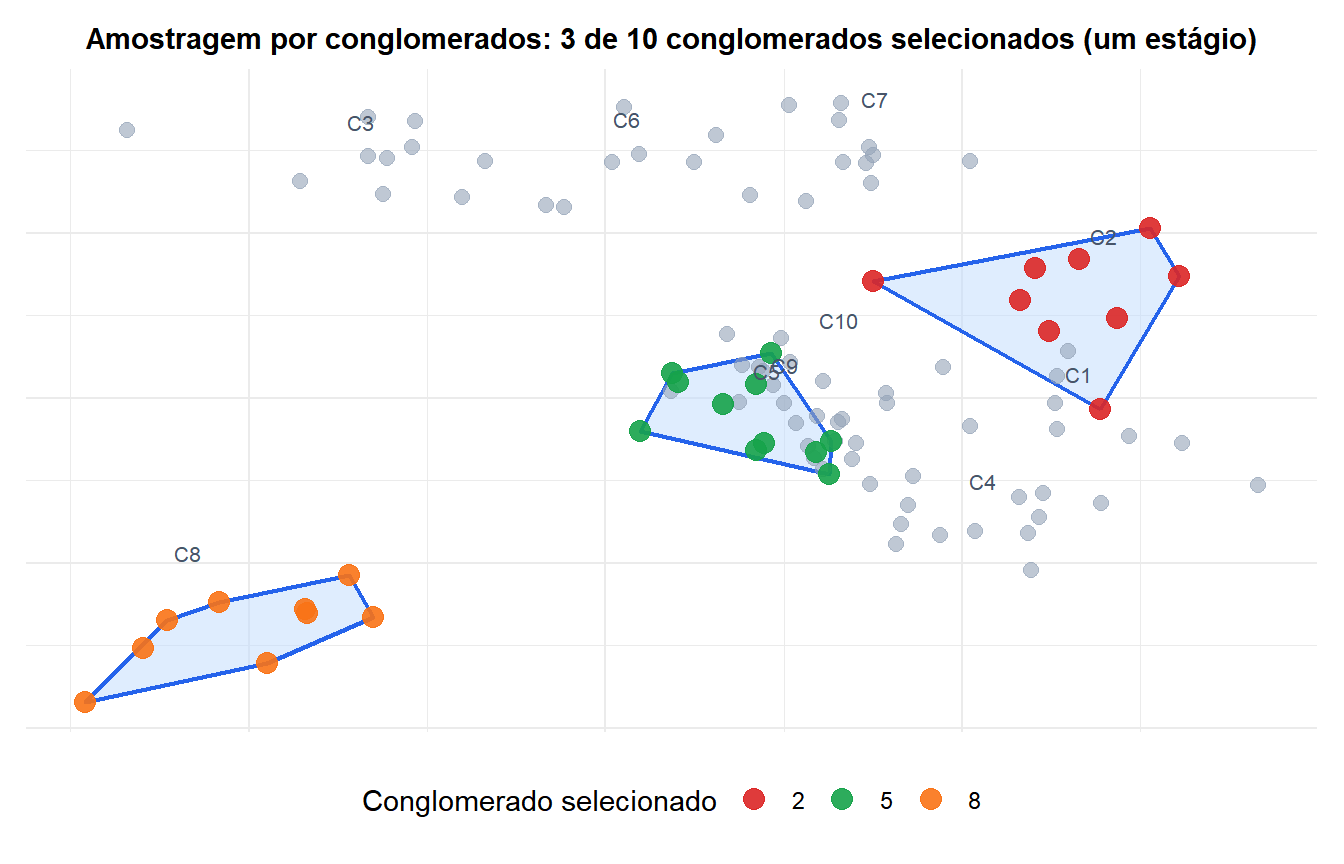
Amostragem por conglomerados em um estágio
Selecionam-se \(m\) conglomerados dos \(M\) disponíveis. Medem-se todas as unidades dentro dos conglomerados selecionados. Simples, mas pode resultar em amostras muito grandes se os conglomerados forem grandes.
Amostragem por conglomerados em dois estágios
Selecionam-se \(m\) conglomerados (primeiro estágio) e, depois, extrai-se uma amostra aleatória de unidades dentro de cada conglomerado selecionado (segundo estágio). Mais flexível: o tamanho da amostra dentro do conglomerado pode ser controlado independentemente do tamanho do conglomerado.
Correlação intraclasse e efeito de desenho
A quantidade-chave na amostragem por conglomerados é o coeficiente de correlação intraclasse (CIC), \(\rho\):
\[\rho = \frac{\text{variância entre médias de conglomerados}}{\text{variância total}}\]
O CIC mede o quão semelhantes são as unidades dentro do mesmo conglomerado. Varia de 0 (os conglomerados não são mais homogêneos do que a população) a 1 (todas as unidades de um conglomerado são idênticas).
O efeito de desenho (DEFF) mede a perda de eficiência da amostragem por conglomerados em relação à AAS do mesmo tamanho total \(n\):
\[\text{DEFF} = 1 + (m_0 - 1)\rho\]
em que \(m_0\) é o número médio de unidades amostradas por conglomerado. O tamanho amostral efetivo é \(n_\text{ef} = n / \text{DEFF}\).
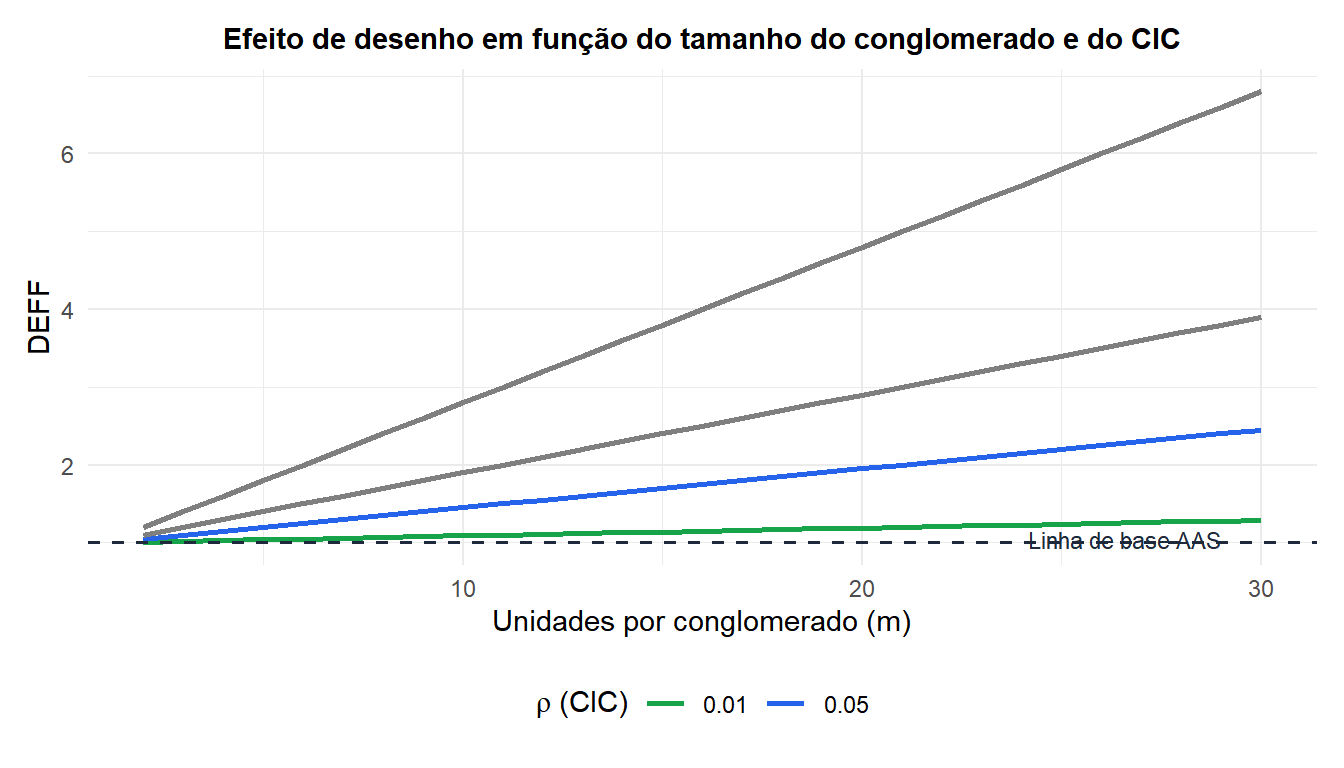
Mesmo um CIC pequeno de 0,05 com 20 unidades por conglomerado dá DEFF = \(1 + 19 \times 0{,}05 = 1{,}95\): são necessárias quase o dobro de observações para atingir a mesma precisão que a AAS.
⚠️ Nunca trate observações de conglomerados como independentes
O erro mais comum e mais grave na análise de amostragem por conglomerados: tratar as \(n\) unidades individuais como se fossem \(n\) observações AAS independentes. Isso subestima os erros padrão, estreita os intervalos de confiança e infla as estatísticas de teste, produzindo resultados falsamente significativos.
Qualquer análise de dados amostrados por conglomerados precisa levar em conta o agrupamento, seja:
- Usando erros padrão ponderados pelo desenho (por exemplo, pacote
surveyem R comsvycluster()). - Incluindo efeitos aleatórios no nível do conglomerado em um modelo misto.
- Usando o efeito de desenho para inflar os erros padrão: \(\text{EP}_\text{ajustado} = \text{EP}_\text{naive} \times \sqrt{\text{DEFF}}\).
Esse problema afeta pesquisas publicadas em medicina, educação e ciências sociais sempre que ensaios randomizados por conglomerados ou estudos multicêntricos são analisados incorretamente.
Exemplo: pesquisa nacional de saúde
Um ministério da saúde quer estimar a proporção de adultos com hipertensão em um país de 5 milhões de adultos. Não existe um registro individual, mas há uma lista de 2.000 centros de atenção primária.
Desenho (dois estágios):
- Selecionam-se aleatoriamente 50 centros (conglomerados) dos 2.000 disponíveis.
- Dentro de cada centro selecionado, amostram-se aleatoriamente 30 pacientes.
Amostra total: \(n = 50 \times 30 = 1.500\) pacientes.
Suponha que o CIC para hipertensão dentro dos centros seja \(\rho = 0{,}08\).
\[\text{DEFF} = 1 + (30 - 1) \times 0{,}08 = 1 + 2{,}32 = 3{,}32\]
\[n_\text{ef} = \frac{1500}{3{,}32} \approx 452\]
As 1.500 observações agrupadas fornecem a mesma precisão que apenas 452 observações AAS. Para igualar uma AAS de 1.500, o desenho por conglomerados precisaria de \(1500 \times 3{,}32 \approx 4.980\) observações.
Para um custo total fixo, reduzir o tamanho do conglomerado \(m_0\) e aumentar o número de conglomerados \(m\) quase sempre melhora a precisão. Isso ocorre porque:
- Mais conglomerados significa mais pedaços independentes de informação.
- Menos unidades por conglomerado reduz a redundância da agregação.
Se amostrar um conglomerado custa \(c_1\) (deslocamento, preparação) e amostrar uma unidade custa \(c_2\) (entrevista), o tamanho ótimo do conglomerado é:
\[m_\text{opt} = \sqrt{\frac{c_1}{c_2} \cdot \frac{1-\rho}{\rho}}\]
Se \(c_1 = 200\), \(c_2 = 10\), \(\rho = 0{,}05\): \(m_\text{opt} = \sqrt{20 \times 19} \approx 19\) unidades por conglomerado. Amostrar mais de 19 por conglomerado desperdiça orçamento com informação redundante.

💡 Conglomerados vs estratificada: a distinção-chave
Ambos os métodos envolvem grupos, mas funcionam de forma oposta:
- Estratificada: todos os estratos são representados; o ganho vem da homogeneidade dentro do estrato.
- Por conglomerados: apenas alguns conglomerados são selecionados; a perda vem da homogeneidade dentro do conglomerado (CIC > 0).
A amostragem estratificada é escolhida para aumentar a eficiência. A amostragem por conglomerados é escolhida por necessidade prática (custo, ausência de marco) e quase sempre reduz a eficiência. Quando as duas são usadas juntas (selecionam-se conglomerados e depois se estratifica dentro deles), o desenho é chamado amostragem por conglomerados estratificada ou amostragem polietápica.

