Amostragem polietápica
A amostragem polietápica, também chamada de amostragem multietápica, aplica a amostragem por conglomerados sequencialmente em dois ou mais níveis da hierarquia de uma população. É o desenho padrão para pesquisas nacionais: os países são grandes demais para listar diretamente os indivíduos, mas listas de regiões, municípios e domicílios podem ser combinadas em um procedimento de amostragem viável.
Amostragem polietápica vs amostragem por conglomerados de um único estágio
A amostragem por conglomerados de um único estágio seleciona conglomerados e mede todas (ou uma amostra aleatória de) as unidades dentro deles em um único passo. A amostragem polietápica adiciona mais estágios de seleção dentro dos conglomerados selecionados:
- Estágio 1: selecionam-se as unidades primárias de amostragem (UPA), por exemplo, províncias ou distritos.
- Estágio 2: dentro de cada UPA selecionada, selecionam-se as unidades secundárias de amostragem (USA), por exemplo, municípios ou setores censitários.
- Estágio 3: dentro de cada USA selecionada, selecionam-se as unidades terciárias, por exemplo, domicílios.
- Estágio final: dentro dos domicílios selecionados, seleciona-se ou entrevista-se um indivíduo.
Cada estágio introduz sua própria fração de amostragem e, potencialmente, seu próprio método de amostragem (AAS, sistemática, PPT).
Probabilidades de seleção entre estágios
Uma propriedade-chave dos desenhos polietápicos: a probabilidade de seleção global de qualquer unidade é o produto das probabilidades de seleção em cada estágio.
Para um desenho de três estágios:
\[\pi_i = \pi_{i}^{(1)} \times \pi_{i}^{(2)} \times \pi_{i}^{(3)}\]
em que \(\pi_i^{(s)}\) é a probabilidade de a unidade \(i\) ser selecionada no estágio \(s\). Se \(\pi_i\) é a mesma para todas as unidades da população, o desenho é autoponderado e a média amostral sem ponderação é um estimador não viesado da média populacional.
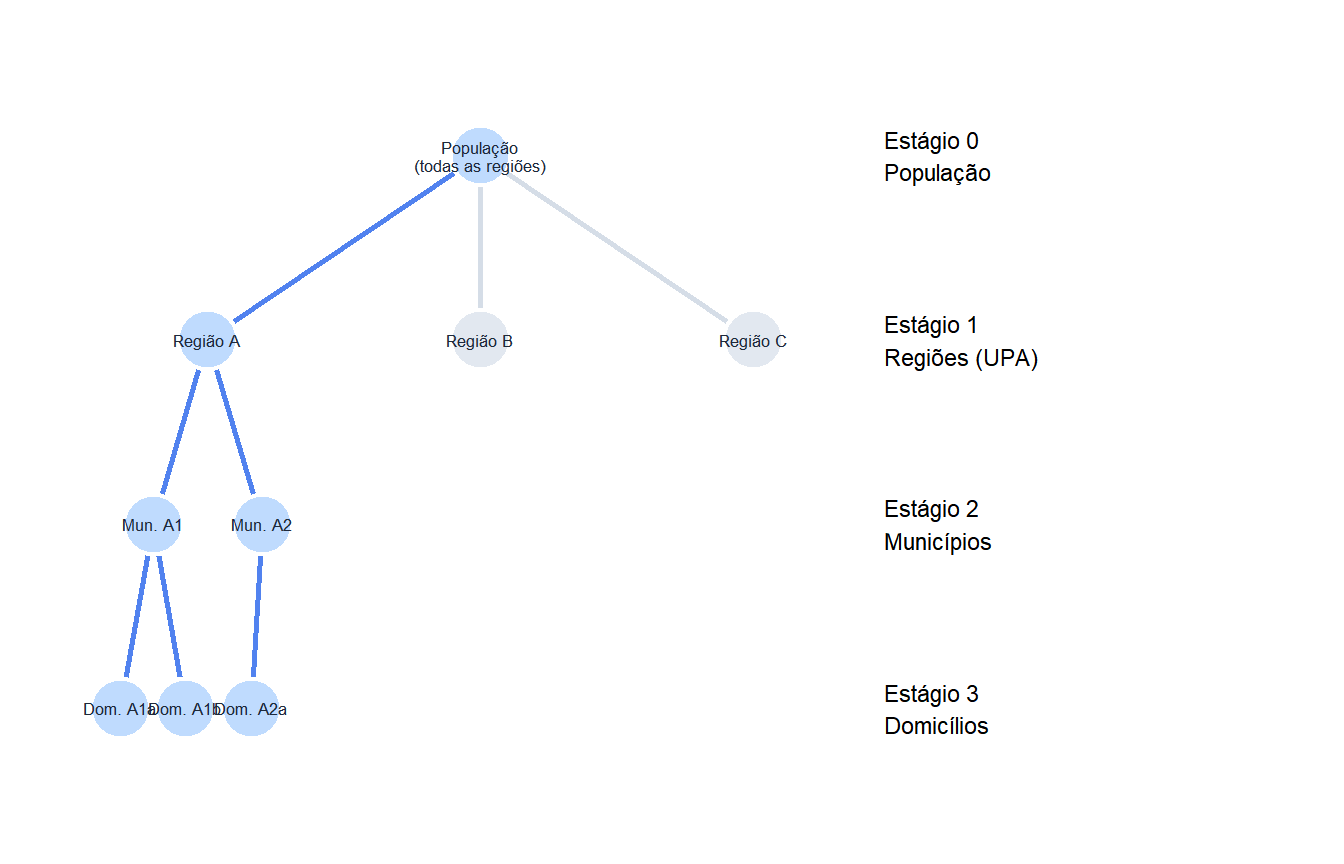
Nós e arestas em azul mostram o caminho selecionado. Apenas a Região A é selecionada no estágio 1; dentro dela, os municípios A1 e A2; dentro de cada um, domicílios específicos.
Amostragem com probabilidade proporcional ao tamanho (PPT)
Em pesquisas nacionais, as UPAs (regiões, municípios) variam enormemente de tamanho. Selecioná-las com igual probabilidade daria a um município pequeno a mesma chance de uma grande cidade, resultando em um desenho muito ineficiente. A solução padrão é a probabilidade proporcional ao tamanho (PPT) no primeiro estágio:
\[\pi_i^{(1)} = m \cdot \frac{M_i}{\sum_j M_j}\]
em que \(m\) é o número de UPAs a selecionar e \(M_i\) é o tamanho (número de domicílios, população) da UPA \(i\). UPAs maiores têm mais probabilidade de serem selecionadas.
A vantagem-chave: se o segundo estágio seleciona então um número fixo de unidades \(n_0\) de cada UPA selecionada, a probabilidade de seleção global se torna:
\[\pi_i = m \cdot \frac{M_i}{\sum M_j} \times \frac{n_0}{M_i} = \frac{m \cdot n_0}{\sum M_j}\]
Os termos \(M_i\) se cancelam, dando igual probabilidade de seleção para todos os indivíduos: um desenho autoponderado. Isso simplifica enormemente a estimação.
Um país tem \(\sum M_j = 10.000\) setores censitários. A pesquisa seleciona:
- Estágio 1: \(m = 100\) setores usando PPT.
- Estágio 2: \(n_0 = 10\) domicílios por setor selecionado usando AAS.
- Estágio 3: 1 adulto por domicílio.
Amostra total: \(100 \times 10 \times 1 = 1.000\) adultos.
Probabilidade de seleção de qualquer adulto no país:
\[\pi = \frac{100 \times 10}{10000} = \frac{1000}{10000} = 0{,}10 = 10\%\]
Todo adulto tem a mesma probabilidade de 10% de ser selecionado, independentemente do setor em que viva. O desenho é autoponderado.
Para um setor com \(M_i = 80\) domicílios:
- Probabilidade no estágio 1: \(100 \times 80/10000 = 0{,}80\)
- Probabilidade no estágio 2: \(10/80 = 0{,}125\)
- Global: \(0{,}80 \times 0{,}125 = 0{,}10\) ✓

Efeito de desenho na amostragem polietápica
Cada estágio introduz agrupamento, então o efeito de desenho se acumula. Para um desenho de dois estágios com \(m\) UPAs e \(n_0\) unidades por UPA:
\[\text{DEFF} \approx 1 + (n_0 - 1)\rho\]
em que \(\rho\) é o CIC dentro das UPAs. A mesma fórmula da amostragem por conglomerados de um estágio, mas agora aplicada ao nível da UPA. Estágios adicionais somam mais efeitos de desenho.
Para atingir um tamanho amostral efetivo de \(n_\text{ef}\), a amostra real precisa ser:
\[n = n_\text{ef} \times \text{DEFF}\]
⚠️ Sempre leve em conta o desenho complexo ao analisar dados polietápicos
As fórmulas padrão para erros padrão, intervalos de confiança e valores-p pressupõem AAS. Amostras polietápicas violam essa suposição em cada estágio. Ignorar o desenho:
- Subestima os erros padrão (às vezes por um fator de 2 ou mais).
- Produz intervalos de confiança excessivamente estreitos.
- Infla as estatísticas de teste e os valores-p.
Em R, use o pacote survey, que trata corretamente a estratificação, o agrupamento e as probabilidades de seleção desiguais:
library(survey)
design <- svydesign(ids = ~upa + domicilio,
                    weights = ~peso,
                    data = dados_pesquisa)
svymean(~resultado, design)
As principais pesquisas internacionais (DHS, PISA, Eurobarômetro, NHANES) fornecem as variáveis de desenho precisamente para que os analistas possam levar em conta a amostragem complexa.
Quando a amostragem polietápica é o desenho adequado
A amostragem polietápica é o desenho padrão para:
- Pesquisas nacionais por domicílio: não existe um registro individual; as hierarquias administrativas (regiões → municípios → setores censitários → domicílios) fornecem os estágios naturais.
- Avaliações educacionais: países → escolas → turmas → alunos.
- Pesquisas epidemiológicas: distritos → unidades de saúde → prontuários de pacientes.
Quase sempre é combinada com estratificação no primeiro estágio (divide-se o país em estratos e depois se selecionam UPAs dentro de cada estrato usando PPT) para melhorar a eficiência e garantir a cobertura geográfica.
Comparando os cinco métodos de amostragem
| Método | Marco necessário | Eficiência vs AAS | Melhor para |
|---|---|---|---|
| AAS | Lista individual completa | Linha de base | Populações pequenas e homogêneas |
| Sistemática | Lista ordenada | \(\geq\) AAS | Listas ordenadas sem periodicidade |
| Estratificada | Lista + pertencimento a estrato | \(>\) AAS | Populações heterogêneas com subgrupos conhecidos |
| Conglomerados | Apenas lista de conglomerados | \(<\) AAS | Populações dispersas, restrições de custo |
| Polietápica | Listas em cada nível | \(<\) AAS | Pesquisas nacionais, sem marco individual completo |

