Análise de correspondência
A Análise de Correspondência (AC) é o equivalente do PCA para tabelas de contingência. Ela encontra uma representação de baixa dimensão das linhas e colunas de uma tabela de frequências bidirecional que preserva as distâncias qui-quadrado entre os perfis. O resultado é um biplot em que linhas e colunas próximas entre si estão associadas, e linhas ou colunas próximas da origem têm perfis pouco notáveis.
A tabela de contingência e os perfis
A AC começa com uma tabela de contingência \(\mathbf{N}\) de tamanho \(I \times J\), em que \(n_{ij}\) é a frequência da categoria de linha \(i\) e da categoria de coluna \(j\). Defina:
- \(n = \sum_{i,j} n_{ij}\): total geral.
- \(\mathbf{P} = \mathbf{N}/n\): matriz de correspondência (frequências relativas).
- \(r_i = \sum_j p_{ij}\): marginais de linha.
- \(c_j = \sum_i p_{ij}\): marginais de coluna.
O perfil de linha da linha \(i\) é \(\mathbf{f}_i = (p_{i1}/r_i, \ldots, p_{iJ}/r_i)\): a distribuição condicional das colunas dada a linha \(i\). O perfil de coluna da coluna \(j\) é \(\mathbf{g}_j = (p_{1j}/c_j, \ldots, p_{Ij}/c_j)\).
A AC encontra coordenadas para linhas e colunas tais que:
- Linhas (colunas) com perfis semelhantes ficam próximas.
- A distância usada é a distância qui-quadrado, que pondera cada coluna (linha) pelo inverso de sua frequência marginal, dando mais peso a categorias raras.
A distância qui-quadrado entre as linhas \(i\) e \(i'\):
\[d^2_\chi(i,i') = \sum_j \frac{1}{c_j}\left(\frac{p_{ij}}{r_i} - \frac{p_{i'j}}{r_{i'}}\right)^2\]
Decomposição SVD
A AC aplica a SVD à matriz de resíduos padronizados:
\[s_{ij} = \frac{p_{ij} - r_i c_j}{\sqrt{r_i c_j}}\]
O numerador \(p_{ij} - r_i c_j\) é o desvio em relação à independência: se linhas e colunas fossem independentes, a proporção esperada seria \(r_i c_j\). O denominador padroniza pela contagem esperada.
\[\mathbf{S} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T\]
As coordenadas das linhas (escores) são \(\mathbf{F} = \mathbf{D}_r^{-1/2}\mathbf{U}\boldsymbol{\Sigma}\) e as das colunas são \(\mathbf{G} = \mathbf{D}_c^{-1/2}\mathbf{V}\boldsymbol{\Sigma}\), em que \(\mathbf{D}_r\) e \(\mathbf{D}_c\) são matrizes diagonais dos marginais de linha e coluna.
Os valores singulares ao quadrado \(\sigma_k^2\) são as inércias principais: elas medem quanto da estatística qui-quadrado total é capturado por cada dimensão. A inércia total é igual a \(\chi^2/n\), em que \(\chi^2\) é a estatística qui-quadrado da tabela de contingência.
Exemplo: hábitos de fumo por cargo
Uma pesquisa registra os hábitos de fumo (Nenhum, Leve, Médio, Intenso) por categoria de cargo (Gerente Sênior, Gerente Júnior, Funcionário Sênior, Funcionário Júnior, Secretário).
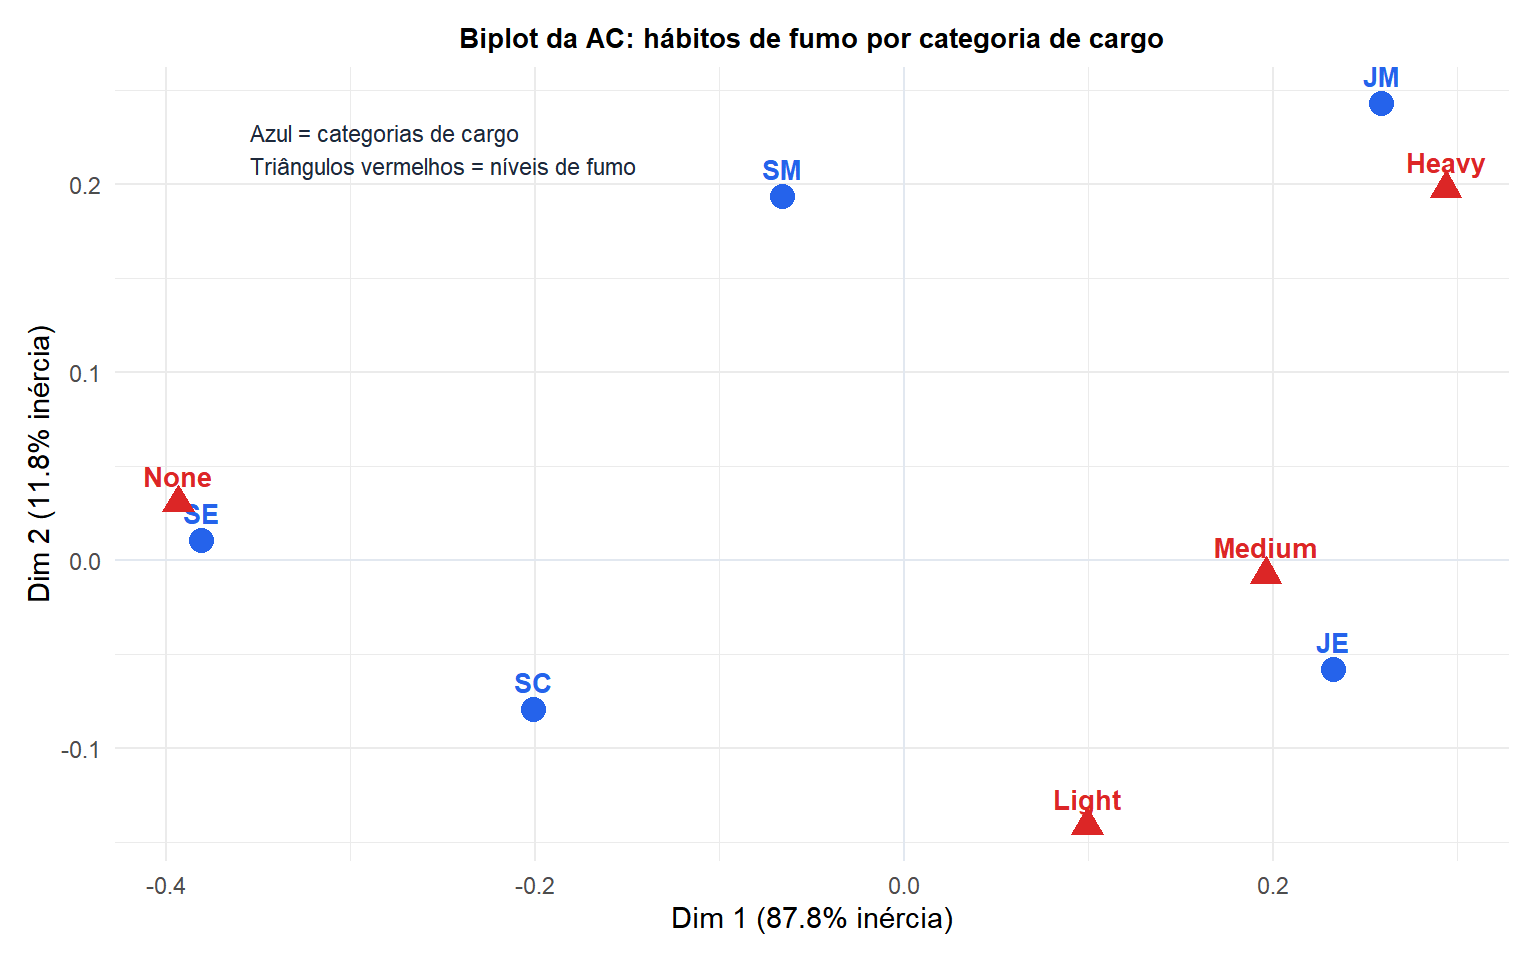
SM = Gerente Sênior, JM = Gerente Júnior, SE = Funcionário Sênior, JE = Funcionário Júnior, SC = Secretário. Funcionários Júniores aparecem próximos de “Heavy” (fumo intenso); Gerentes Sêniores estão mais próximos de “None” (nenhum). A primeira dimensão separa fumantes leves de intensos; a segunda separa funções gerenciais de não gerenciais.
Inércia e quantas dimensões
Inércia total = \(\chi^2/n\): mede a associação total entre linhas e colunas. Inércia zero significa que linhas e colunas são independentes. Inércia alta significa associação forte.
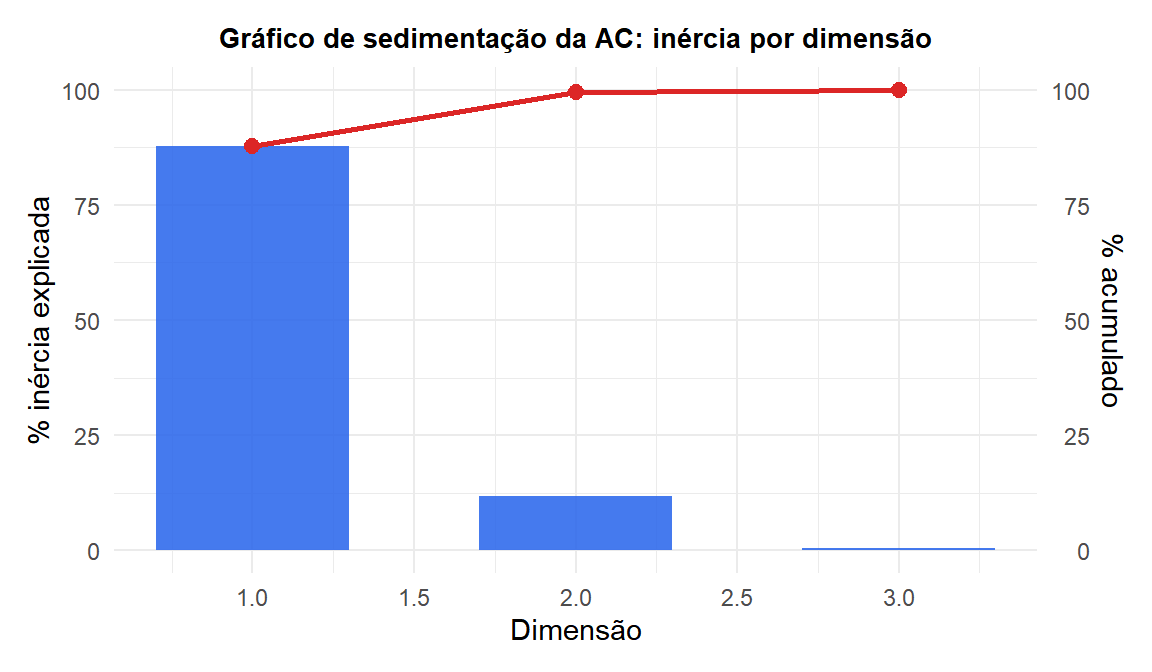
Cada dimensão captura uma fração da inércia total (análogo à variância explicada no PCA). Um gráfico de sedimentação das inércias principais ajuda a decidir quantas dimensões reter.
Lendo o biplot
Três regras para interpretar um biplot da AC:
Regra 1: linhas próximas entre si têm perfis de coluna semelhantes. Duas categorias de cargo próximas têm distribuições de fumo semelhantes.
Regra 2: colunas próximas entre si aparecem em perfis de linha semelhantes. Dois níveis de fumo próximos tendem a caracterizar as mesmas categorias de cargo.
Regra 3: um ponto de linha próximo de um ponto de coluna indica associação. Uma categoria de cargo próxima de “Heavy” significa que essa categoria sobrerrepresenta fumantes intensos em relação à média.
Regra 4: distância da origem. Pontos próximos da origem têm perfis próximos da média (pouco interessantes); pontos distantes da origem têm perfis inusuais e impulsionam as dimensões.
⚠️ A proximidade linha-coluna exige cautela
Em um biplot de AC padrão (mapa simétrico), a distância exata entre um ponto de linha e um ponto de coluna não é diretamente interpretável como uma distância qui-quadrado. O biplot projeta linhas e colunas no mesmo espaço por conveniência visual, mas as distâncias qui-quadrado formais são definidas separadamente para linhas e para colunas.
Para uma distância totalmente interpretável entre linhas e colunas, use um biplot assimétrico: plote um conjunto de perfis como pontos e o outro como coordenadas naquele espaço de perfis. A função fviz_ca_biplot(asymmetric=TRUE) do FactoMineR faz isso.
Análise de Correspondência Múltipla (ACM)
A AC trata de duas variáveis categóricas. A Análise de Correspondência Múltipla (ACM) estende isso para três ou mais variáveis. Cada indivíduo é descrito por várias variáveis categóricas; a ACM encontra um espaço de baixa dimensão em que:
- Indivíduos que deram respostas semelhantes ficam próximos.
- Categorias que foram frequentemente escolhidas juntas ficam próximas.
- Categorias próximas de um indivíduo significam que esse indivíduo tende a escolher aquela categoria.
A ACM é equivalente à AC aplicada à matriz indicadora (uma matriz binária com uma coluna por categoria e uma linha por indivíduo). É amplamente usada em análise de pesquisas e pesquisa de mercado.
💡 Análise de correspondência em R
library(FactoMineR)
library(factoextra)

# CA on a contingency table
ca_res <- CA(contingency_table, ncp=5, graph=FALSE)
summary(ca_res)          # inertia per dimension
ca_res$eig               # eigenvalues and % inertia
ca_res$row$coord         # row coordinates
ca_res$col$coord         # column coordinates

# Biplot
fviz_ca_biplot(ca_res, repel=TRUE)

# Scree plot
fviz_screeplot(ca_res)

# Contribution of rows/columns to each dimension
fviz_contrib(ca_res, choice="row", axes=1)
fviz_contrib(ca_res, choice="col", axes=1)

# MCA for multiple categorical variables
mca_res <- MCA(df_survey, graph=FALSE)
fviz_mca_biplot(mca_res, repel=TRUE)
