Análise de covariância (ANCOVA)
A ANCOVA (Análise de Covariância) compara médias de grupos em uma variável resposta enquanto controla estatisticamente uma covariável contínua. Não é um método separado: é um modelo linear com preditores categóricos e contínuos ao mesmo tempo. O benefício prático é duplo: a redução da variância residual aumenta o poder, e as médias ajustadas removem o efeito confundidor da covariável.
A ANCOVA como um modelo linear
Para \(k\) grupos e uma covariável \(z\), a ANCOVA é a regressão:
\[y_{ij} = \mu + \alpha_i + \gamma z_{ij} + \varepsilon_{ij}\]
em que \(\alpha_i\) é o efeito do grupo \(i\) (com \(\sum \alpha_i = 0\) ou um grupo como referência) e \(\gamma\) é a inclinação comum de \(y\) sobre \(z\). Em forma matricial no R: lm(y ~ group + z).
Esse modelo assume retas de regressão paralelas: a inclinação \(\gamma\) é a mesma em todos os grupos. Os grupos diferem apenas em seus interceptos (médias ajustadas). A covariável \(z\) é tratada como um estorvo: estimamos e removemos seu efeito para obter uma comparação mais limpa das médias dos grupos.
Por que a ANCOVA aumenta o poder? Ao explicar parte da variância residual com a covariável, o erro quadrático médio (EQM) diminui. Um EQM menor significa uma estatística F maior e maior poder para detectar diferenças entre grupos.
Exemplo: métodos de ensino e conhecimento prévio
Três métodos de ensino (A, B, C) são comparados quanto às notas do pós-teste, controlando a nota do pré-teste (conhecimento prévio). Sem controlar a covariável, as diferenças na habilidade do pré-teste confundem a comparação.
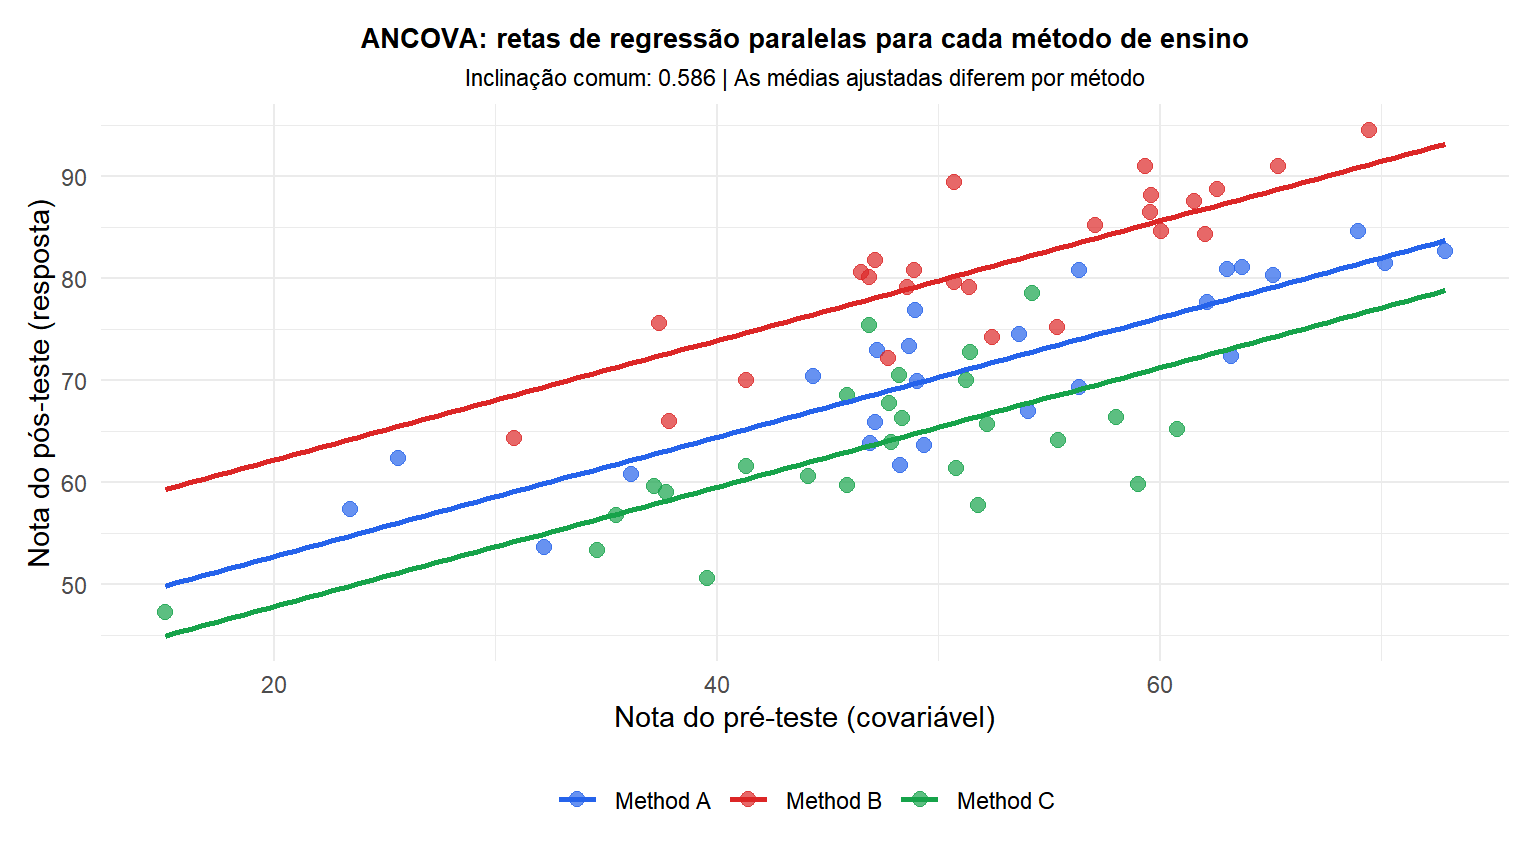
As três retas paralelas têm a mesma inclinação (o efeito da covariável), mas interceptos diferentes (os efeitos de grupo). A separação vertical entre as retas mede a diferença de grupo ajustada.
Médias ajustadas (marginais estimadas)
A média ajustada para o grupo \(i\) é o valor previsto quando a covariável \(z\) é fixada em sua média geral \(\bar{z}\):
\[\hat{\mu}_i^{\text{adj}} = \hat{\mu} + \hat{\alpha}_i + \hat{\gamma}\bar{z}\]
As médias ajustadas respondem: “quais seriam as médias dos grupos se todos os grupos tivessem a mesma nota média no pré-teste?” Essa é a quantidade de interesse principal na ANCOVA.
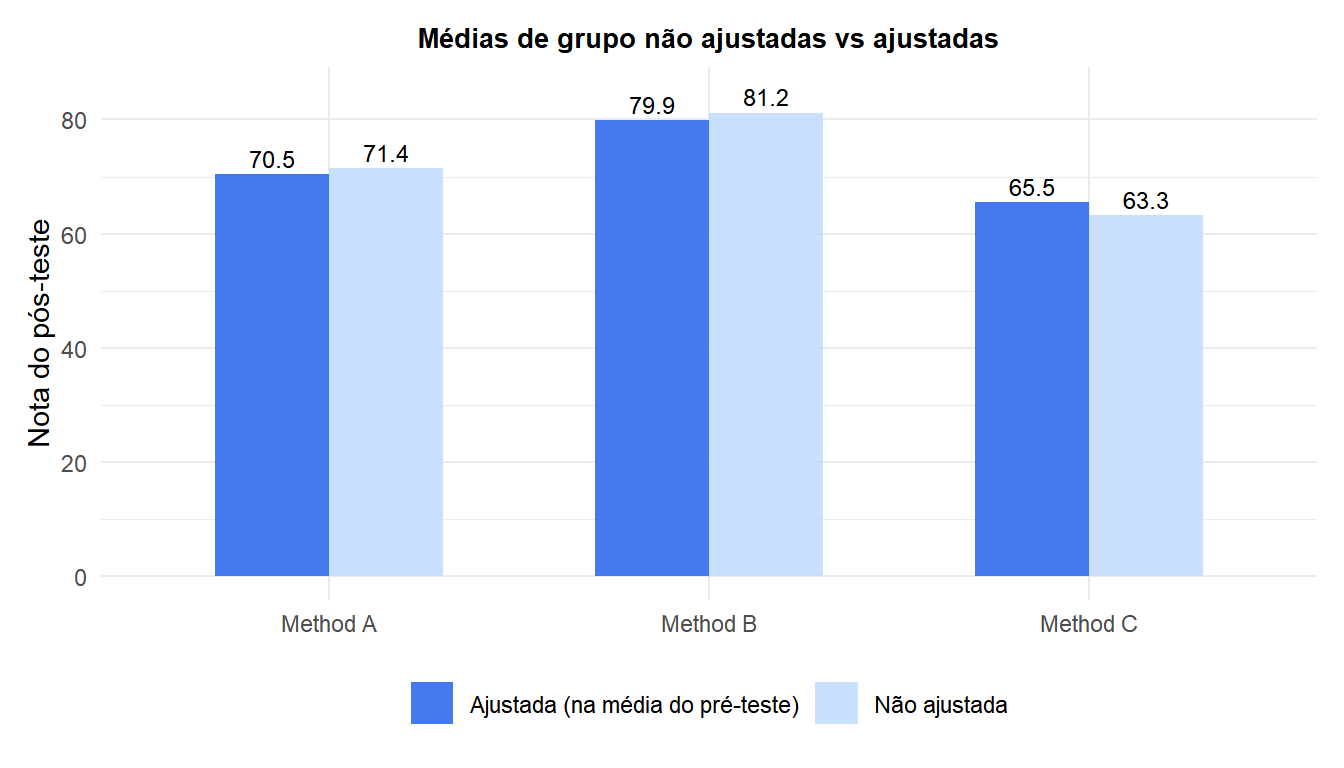
Ajustar pela nota do pré-teste desloca as médias: grupos que começaram com conhecimento prévio mais alto têm suas médias reduzidas, tornando a comparação mais justa.
A suposição crítica: homogeneidade de inclinações
A ANCOVA assume que a covariável tem a mesma relação com a resposta em todos os grupos (retas paralelas). Se as inclinações diferirem, os grupos interagem com a covariável e uma única média ajustada por grupo é enganosa.
Teste: ajuste o modelo de interação lm(y ~ group * z) e compare com o modelo ANCOVA lm(y ~ group + z) usando um teste F ou teste de razão de verossimilhança. Uma interação significativa significa que as inclinações diferem e a ANCOVA padrão não é apropriada.
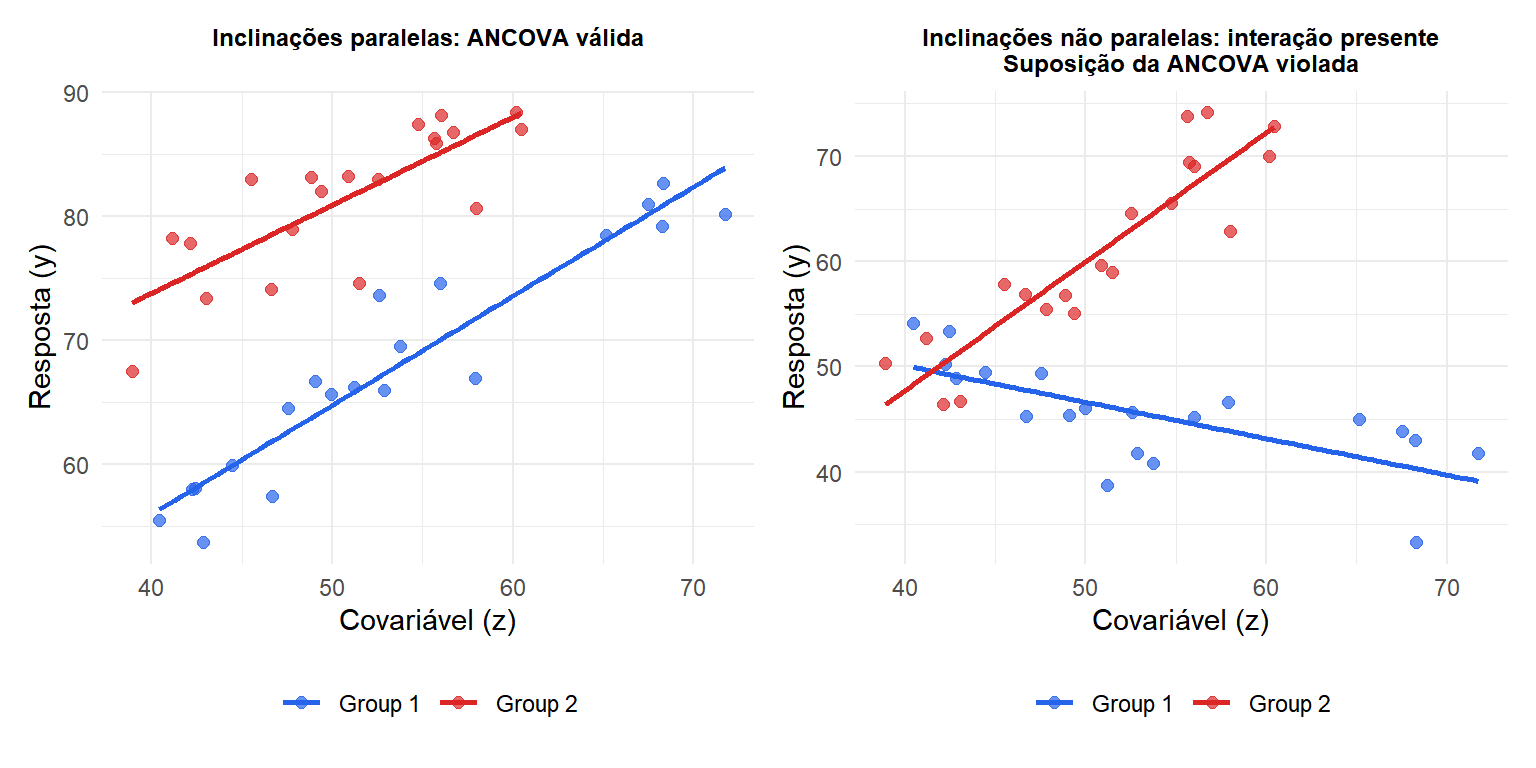
Quando as inclinações não são paralelas (direita), a comparação entre grupos depende do valor de \(z\): em \(z\) baixo, o Grupo 1 tem notas mais altas; em \(z\) alto, o Grupo 2 tem notas mais altas. Uma única média ajustada por grupo representaria mal esse padrão.
⚠️ A ANCOVA em estudos observacionais exige cautela
Em experimentos randomizados, a alocação aleatória garante que a covariável esteja balanceada entre os grupos antes do tratamento: os ajustes da ANCOVA são limpos. Em estudos observacionais, a covariável pode ser um mediador (no caminho causal entre grupo e resultado) em vez de um fator de confusão. Ajustar por um mediador bloqueia parte do efeito do tratamento e produz estimativas viesadas.
Exemplo: ao estudar o efeito de uma intervenção dietética no peso, se a intervenção funciona em parte reduzindo a ingestão calórica, ajustar pela ingestão calórica na ANCOVA removeria parte do efeito do tratamento que você está tentando medir.
Antes de incluir uma covariável na ANCOVA, pense cuidadosamente se ela é um fator de confusão (ajuste), um mediador (não ajuste), ou nenhum dos dois.
💡 ANCOVA em R
# Fit ANCOVA
fit <- lm(post ~ method + pre, data=df)
summary(fit)
anova(fit)    # F-tests for method and pre

# Test homogeneity of slopes (interaction)
fit_int <- lm(post ~ method * pre, data=df)
anova(fit, fit_int)   # significant -> slopes differ, ANCOVA not valid

# Adjusted (estimated marginal) means
library(emmeans)
emmeans(fit, "method")               # adjusted at grand mean of pre
emmeans(fit, "method", at=list(pre=55))  # adjusted at specific pre value

# Pairwise comparisons of adjusted means
pairs(emmeans(fit, "method"))
