Árvores de decisão
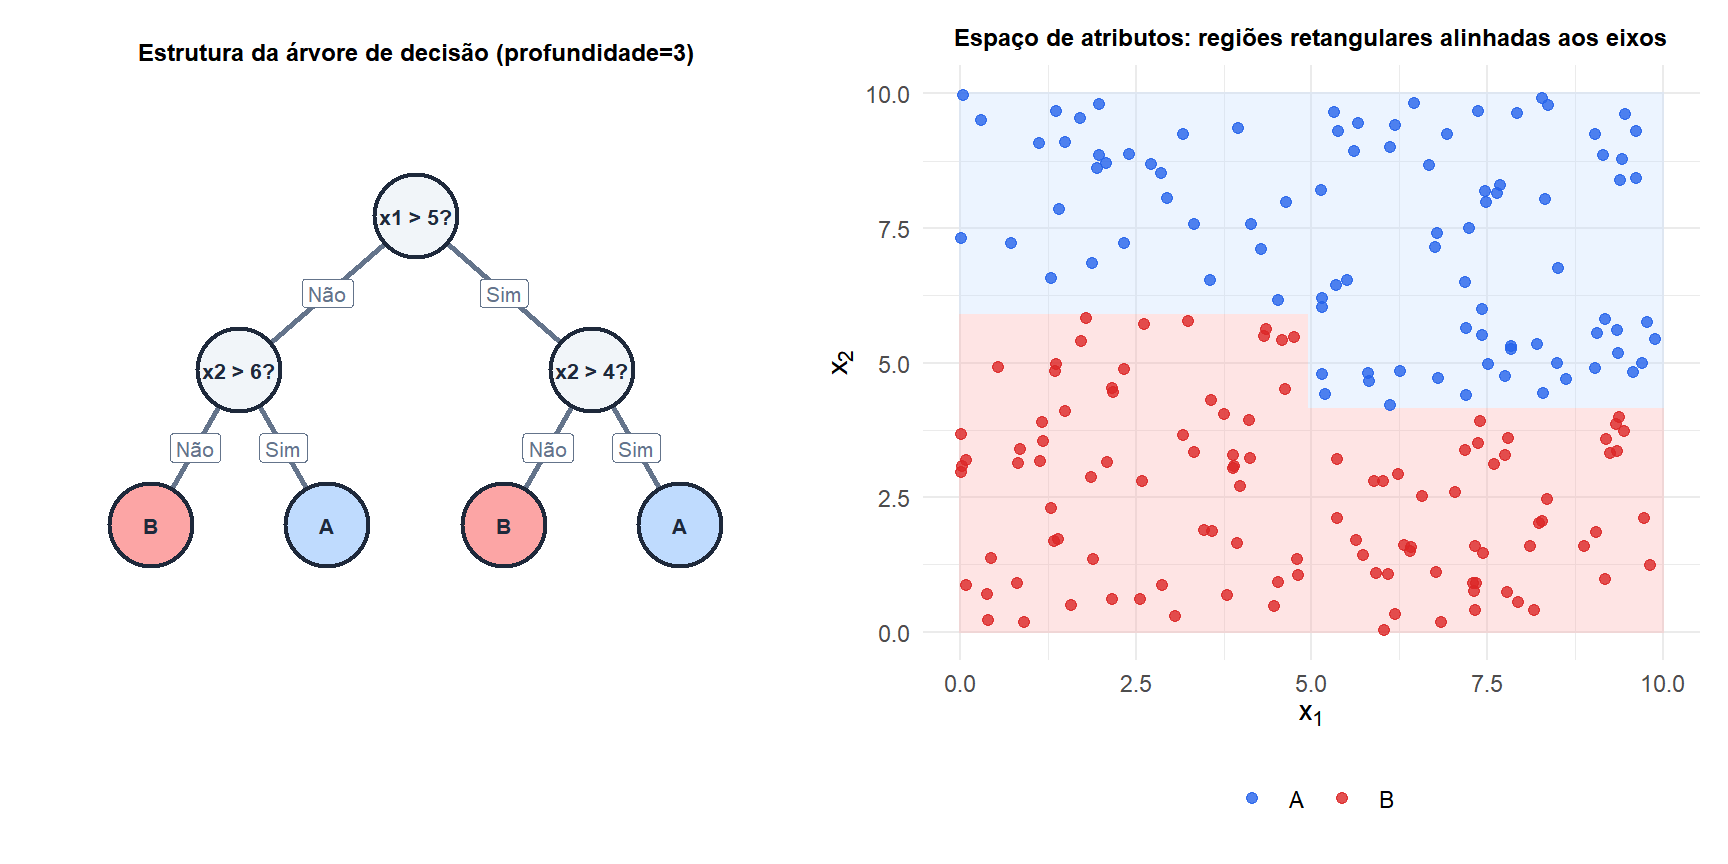
Uma árvore de decisão particiona o espaço de atributos em regiões retangulares, dividindo recursivamente pelo atributo e limiar que melhor separam as classes (ou reduzem o erro de previsão, em regressão). O resultado é uma partição interpretável e alinhada aos eixos: toda previsão é uma sequência de perguntas sim/não sobre os atributos. As árvores são o bloco de construção dos métodos de ensemble mais poderosos: random forests e gradient boosting.
Particionamento binário recursivo
O algoritmo CART (Classification and Regression Trees) constrói uma árvore de cima para baixo:
- Em cada nó, considere todo atributo \(j\) e todo limiar de divisão possível \(t\).
- Escolha o par \((j, t)\) que minimiza a impureza ponderada dos dois nós filhos resultantes.
- Recorra em cada filho até que um critério de parada seja atingido (profundidade máxima, tamanho mínimo do nó, ou nenhuma melhoria possível).
- Atribua a cada nó-folha a classe majoritária (classificação) ou a resposta média (regressão).
A busca por divisões é greedy (gulosa): em cada nó, a melhor divisão local é escolhida sem olhar adiante. Isso não garante uma árvore globalmente ótima, mas o problema de encontrar a árvore globalmente ótima é NP-difícil.
Critérios de divisão: medindo a impureza
Para um nó contendo \(n\) pontos dos quais \(n_k\) pertencem à classe \(k\), com \(\hat{p}_k = n_k/n\):
Impureza de Gini
\[G = \sum_{k=1}^K \hat{p}_k(1-\hat{p}_k) = 1 - \sum_{k=1}^K \hat{p}_k^2\]
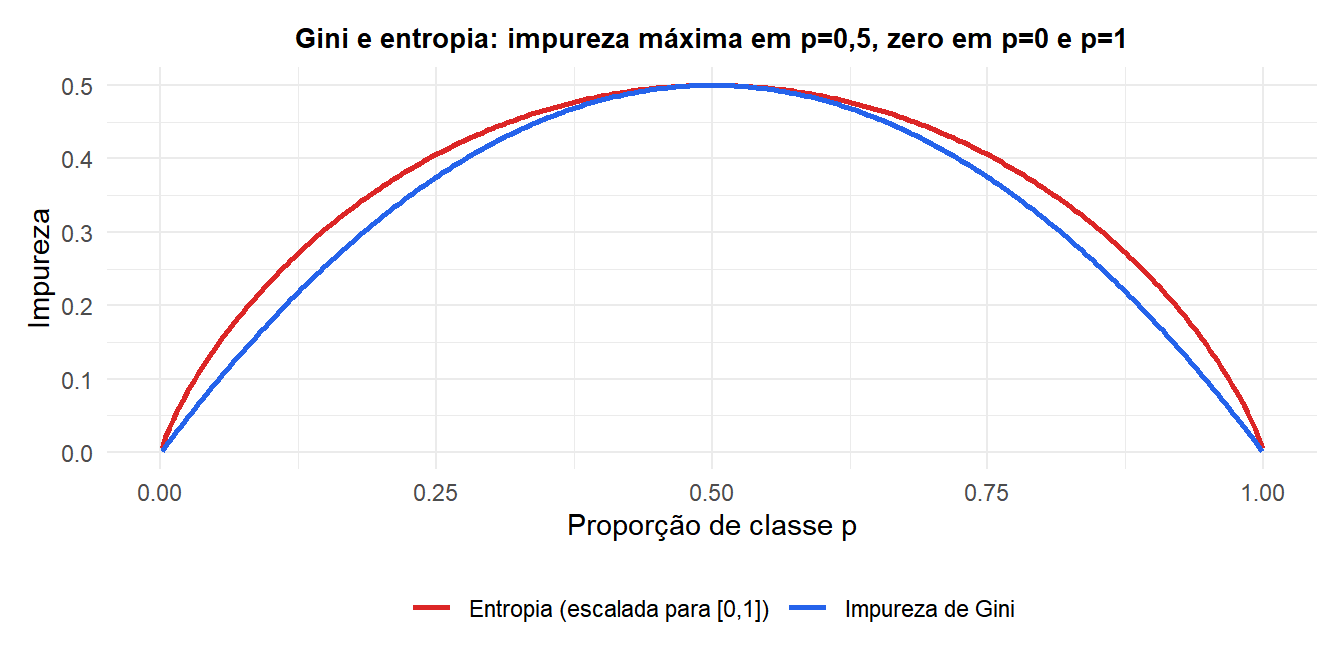
Mede a probabilidade de classificar incorretamente um ponto escolhido aleatoriamente usando a distribuição de classes do nó. \(G=0\) para um nó puro (uma classe), \(G=0,5\) para impureza máxima em um problema binário. Padrão no CART.
Ganho de informação (entropia)
\[H = -\sum_{k=1}^K \hat{p}_k \log_2 \hat{p}_k\]
O ganho de informação em uma divisão = entropia do pai menos a entropia ponderada dos filhos. Tende a preferir divisões que produzem filhos mais equilibrados do que o Gini, mas os resultados costumam ser semelhantes na prática.
EQM (árvores de regressão)
\[\text{EQM} = \frac{1}{n}\sum_{i \in \text{nó}} (y_i - \bar{y}_\text{nó})^2\]
A melhor divisão minimiza a soma ponderada do EQM nos dois nós filhos.
Pruning: evitando o overfitting
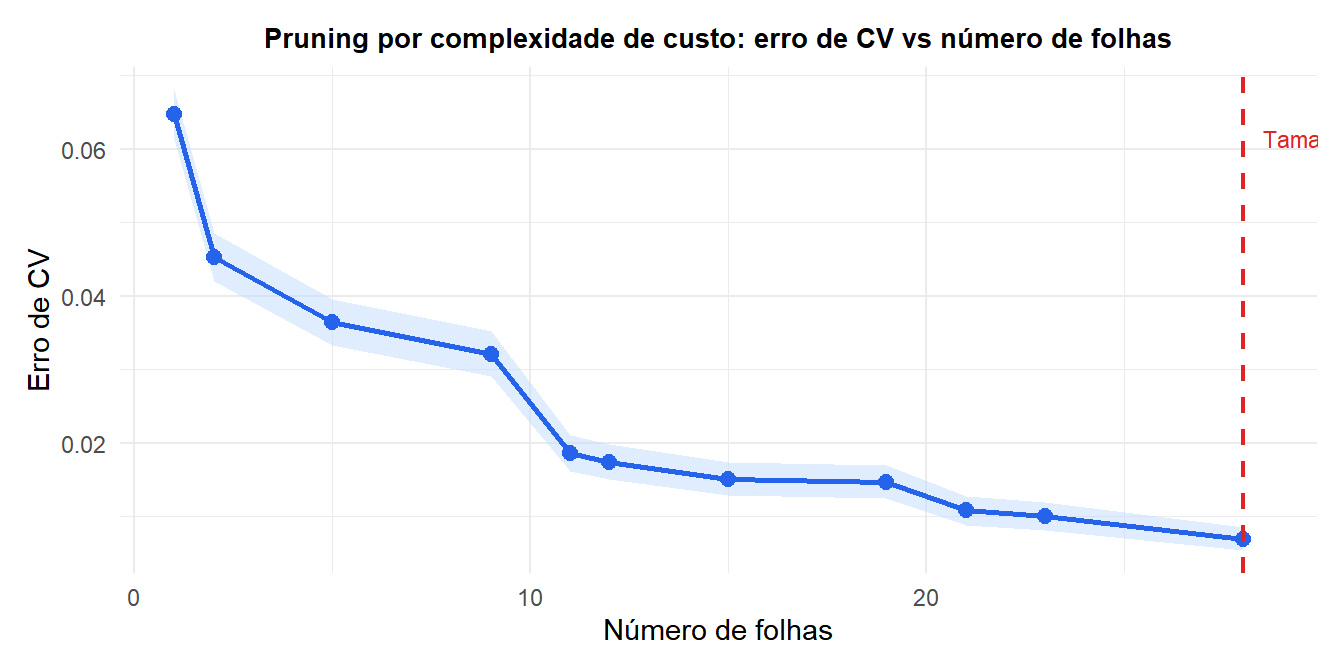
Uma árvore totalmente desenvolvida (sem critério de parada) ajusta perfeitamente os dados de treinamento, mas generaliza mal: ela memoriza o ruído. O pruning por complexidade de custo (pruning do elo mais fraco) controla isso adicionando uma penalidade pelo tamanho da árvore:
\[R_\alpha(T) = R(T) + \alpha|T|\]
em que \(R(T)\) é a taxa de erro de classificação no treinamento, \(|T|\) é o número de folhas, e \(\alpha \geq 0\) é o parâmetro de complexidade. Para cada \(\alpha\), existe uma subárvore única \(T_\alpha\) que minimiza \(R_\alpha\). Conforme \(\alpha\) aumenta, os ramos são progressivamente cortados até que reste apenas a raiz.
O \(\alpha\) ótimo é selecionado por validação cruzada: ajuste a árvore completa, gere a sequência de subárvores para \(\alpha\) crescente, e escolha o \(\alpha\) que minimiza o erro de CV.
Importância de atributos
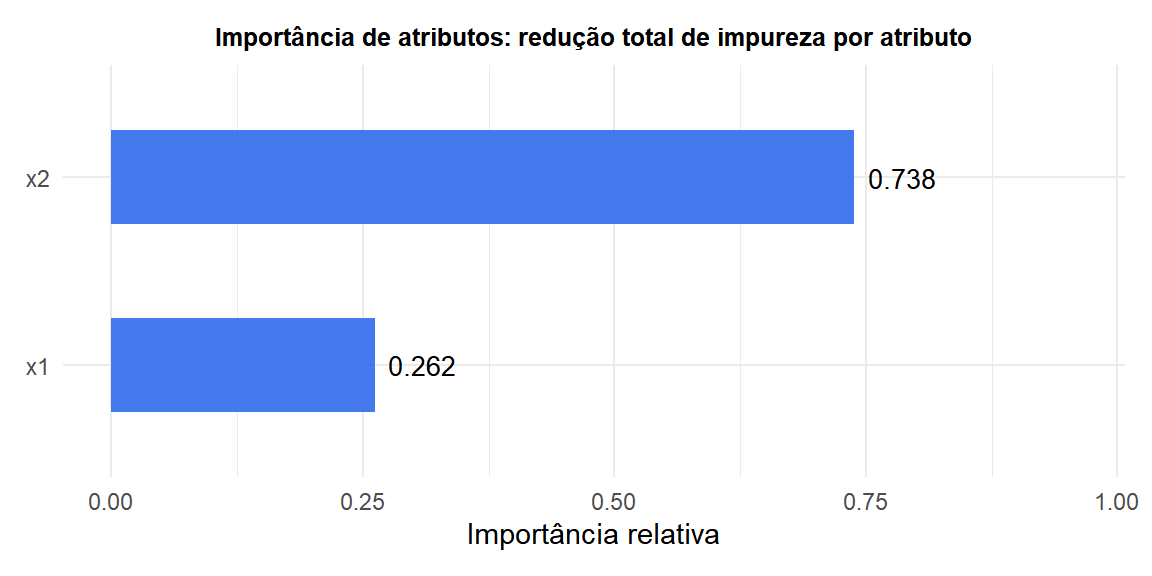
A importância do atributo \(j\) é a redução total de impureza alcançada por todas as divisões em \(j\), ponderada pelo número de amostras que chegam a cada divisão:
\[\text{Importância}(j) = \sum_{\text{divisões em } j} \frac{n_\text{nó}}{n} \cdot \Delta\text{Impureza}\]
Atributos usados perto da raiz (onde mais amostras passam) contribuem mais. Isso dá uma classificação interpretável de relevância de atributos, embora possa ser tendenciosa em favor de atributos com mais valores únicos.
Propriedades das árvores de decisão
Vantagens:
- Interpretáveis: podem ser visualizadas e explicadas a públicos não técnicos.
- Não exigem escalonamento de atributos: as divisões são comparações de limiar, não distâncias.
- Tratam tipos de atributos mistos: numéricos e categóricos nativamente.
- Capturam automaticamente interações entre atributos.
- Robustas a outliers na resposta (outliers afetam apenas uma folha).
Limitações:
- Alta variância: pequenas mudanças nos dados de treinamento podem produzir árvores completamente diferentes. Um único ponto de dados perto de um limiar de divisão pode alterar toda a estrutura da árvore abaixo dessa divisão.
- Fronteiras alinhadas aos eixos: não conseguem capturar fronteiras de decisão diagonais sem muitas divisões.
- Tendenciosas em favor de atributos com muitos valores únicos.
- Subótimas: a estratégia de divisão greedy não encontra a árvore globalmente melhor.
⚠️ Árvores de decisão isoladas raramente são competitivas
A alta variância de árvores individuais as torna preditores fracos por si só. Elas quase sempre são usadas como blocos de construção para métodos de ensemble:
- Bagging e random forests: calculam a média de muitas árvores profundas treinadas em amostras bootstrap, reduzindo a variância e preservando o viés baixo.
- Gradient boosting: constrói árvores superficiais sequencialmente, cada uma corrigindo os erros das anteriores.
Uma única árvore de decisão com pruning é valiosa para interpretabilidade e como linha de base, mas se a precisão de previsão é o objetivo, sempre compare com random forest ou gradient boosting antes de se decidir por uma única árvore.
💡 Árvores de decisão em R
library(rpart)

# Fit a classification tree
fit <- rpart(y ~ ., data=df_train, method="class",
             control=rpart.control(cp=0))   # grow full tree

# Visualize
library(rpart.plot)
rpart.plot(fit, type=4, extra=101)

# Cost-complexity pruning: choose cp by CV
printcp(fit)
plotcp(fit)

# Prune to optimal cp (1-SE rule)
best_cp <- fit$cptable[which.min(fit$cptable[,"xerror"]), "CP"]
fit_pruned <- prune(fit, cp=best_cp)

# Feature importance
fit$variable.importance / sum(fit$variable.importance)

# Regression tree
fit_reg <- rpart(y ~ ., data=df_train, method="anova")
