Diagnósticos de regressão linear
Os diagnósticos de regressão verificam se as suposições por trás do MQO são satisfeitas e se alguma observação distorce indevidamente o modelo. Executar uma regressão sem diagnósticos é como aceitar um resultado sem verificar o trabalho: as estimativas podem estar corretas, ou podem estar completamente erradas, e não é possível saber qual sem checar.
As suposições LINE
As quatro suposições da regressão linear, lembradas pela sigla LINE (do inglês):
- Linearidade: \(E[y|x] = \mathbf{x}^T\boldsymbol{\beta}\) (a média condicional é linear nos preditores).
- Independência: os resíduos \(\varepsilon_i\) são independentes entre observações.
- Normalidade: \(\varepsilon_i \sim N(0, \sigma^2)\).
- Equal variância (homocedasticidade): \(\text{Var}(\varepsilon_i) = \sigma^2\) para todo \(i\).
Linearidade e independência são as mais críticas: suas violações levam a estimativas viesadas ou inconsistentes. A normalidade importa principalmente em amostras pequenas (a inferência é robusta à não normalidade para \(n\) grande, via TCL). A heterocedasticidade não viesa \(\hat{\boldsymbol{\beta}}\), mas infla ou deflaciona os erros padrão, tornando os testes de hipóteses não confiáveis.
Os quatro gráficos diagnósticos
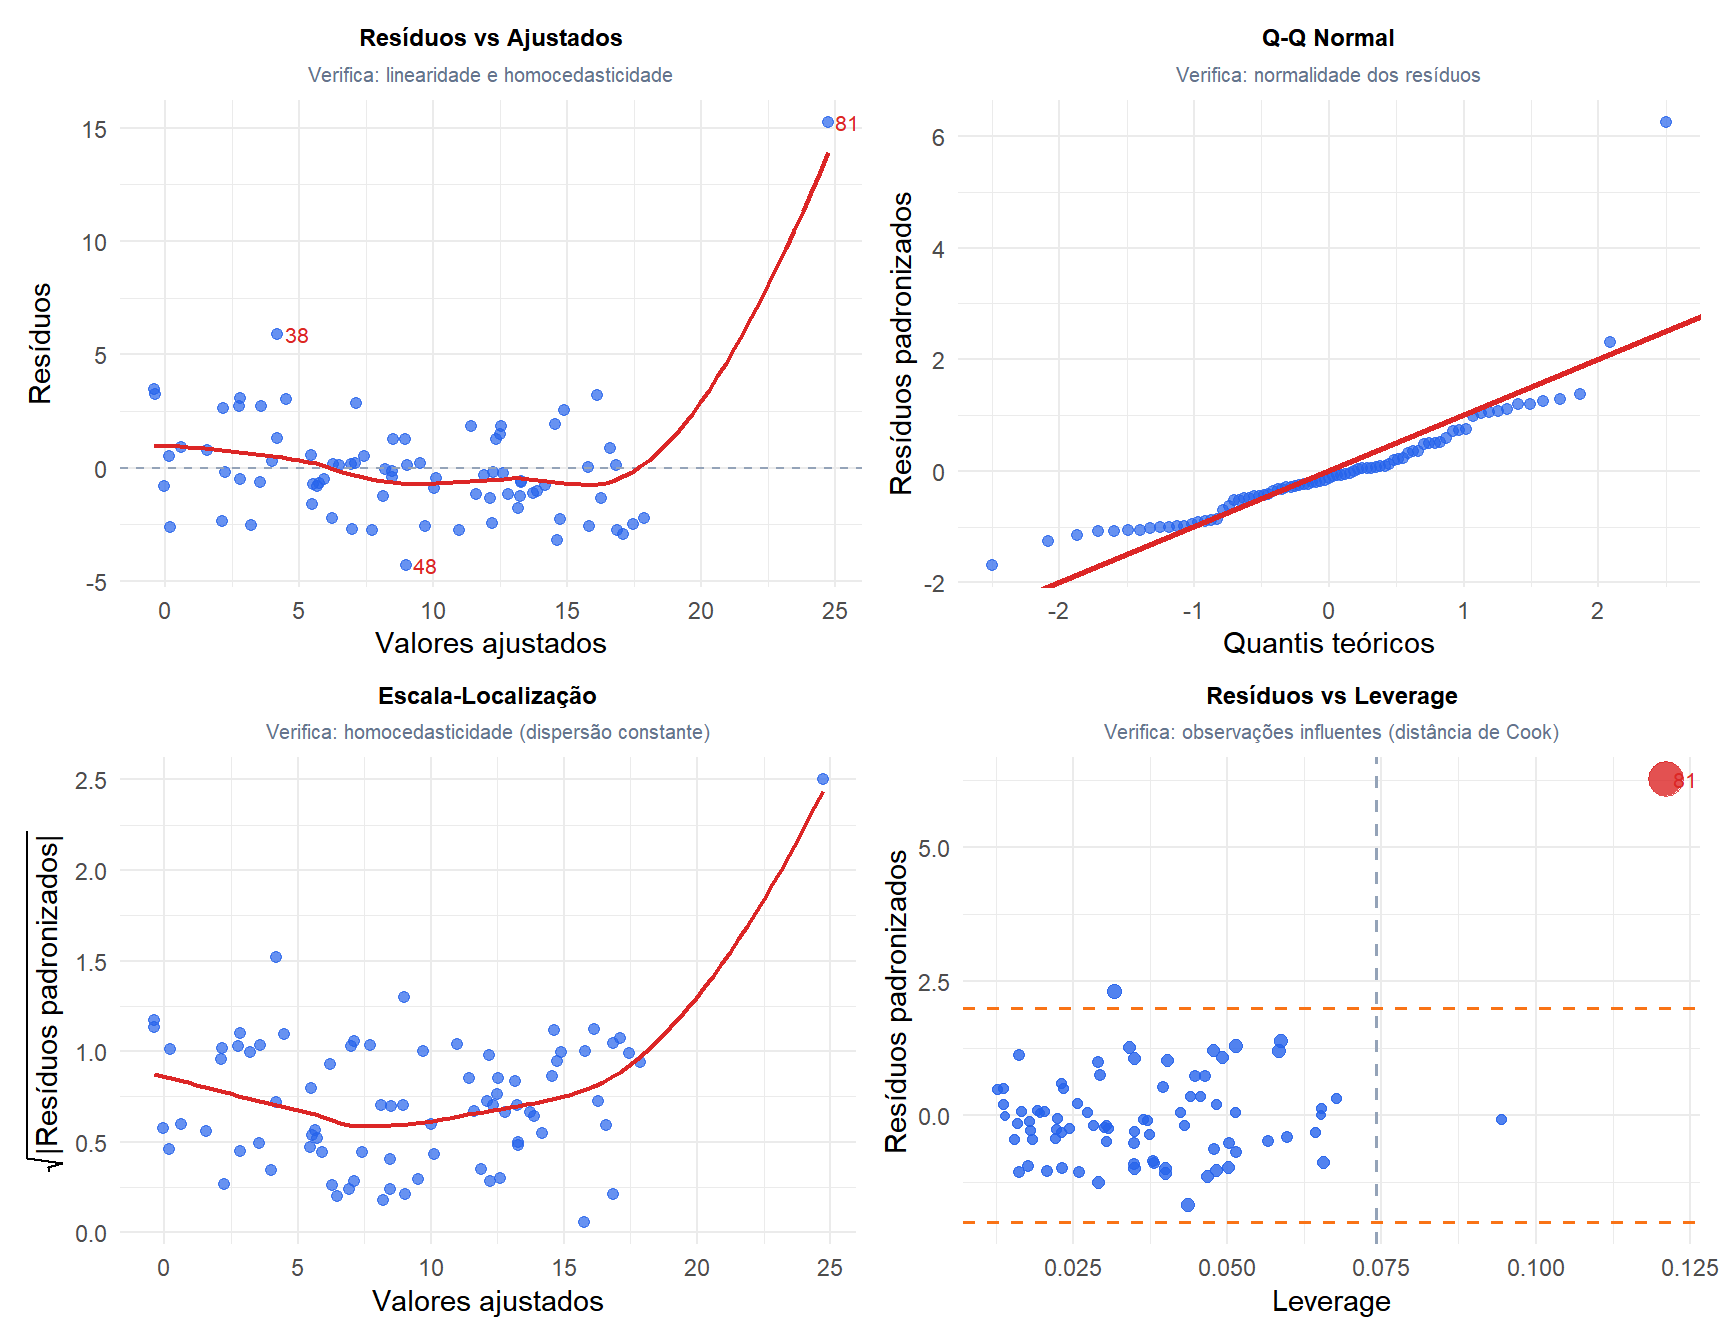
Os quatro gráficos expõem diferentes violações das suposições:
- Resíduos vs Ajustados: uma linha vermelha plana significa que a linearidade se mantém. Um formato de U ou de funil indica não linearidade ou heterocedasticidade.
- Q-Q Normal: pontos sobre a diagonal indicam que a normalidade se mantém. Curvas em S indicam caudas pesadas; desvios curvos indicam assimetria.
- Escala-Localização: uma linha vermelha plana indica homocedasticidade. Uma tendência ascendente significa que a variância aumenta com o valor ajustado.
- Resíduos vs Leverage: pontos com alta distância de Cook (bolhas grandes, rotuladas) são influentes. As linhas horizontais tracejadas marcam \(\pm 2\) resíduos padronizados.
Testes formais para violações das suposições
Teste de Breusch-Pagan para heterocedasticidade
Regride os resíduos ao quadrado sobre os preditores. Um resultado significativo rejeita \(H_0\): variância constante.
Teste de Shapiro-Wilk para normalidade dos resíduos
Testa se os resíduos vêm de uma distribuição normal. Para \(n\) grande (\(> 5.000\)), até mesmo uma não normalidade trivial é detectada: use gráficos Q-Q para avaliar a significância prática.
Teste de Durbin-Watson para autocorrelação
\[DW = \frac{\sum_{i=2}^n (e_i - e_{i-1})^2}{\sum_{i=1}^n e_i^2}\]
\(DW \approx 2\) significa ausência de autocorrelação. \(DW < 1{,}5\) sugere autocorrelação positiva (resíduos consecutivos tendem a ter o mesmo sinal). Relevante para dados de séries temporais; menos importante para dados transversais.
Outliers, leverage e pontos influentes
Três conceitos distintos que costumam ser confundidos:
Outlier
Um ponto com um resíduo grande: o \(y_i\) observado está longe de \(\hat{y}_i\). Detectado por resíduos padronizados \(|e_i / \hat{\sigma}| > 2\) ou \(> 3\). Um outlier em \(y\) não necessariamente influencia a reta de regressão se seu \(x_i\) estiver próximo de \(\bar{x}\).
Alto leverage
Um ponto com um valor extremo de \(x_i\), longe do centro do espaço de preditores. Medido pela diagonal da matriz hat \(h_{ii} = \mathbf{x}_i^T(\mathbf{X}^T\mathbf{X})^{-1}\mathbf{x}_i\). Um limiar comum é \(h_{ii} > 2(k+1)/n\). Pontos de alto leverage têm potencial para influenciar o ajuste, mas podem ou não fazê-lo, dependendo de seu valor \(y_i\).
Ponto influente
Um ponto que de fato muda substancialmente os coeficientes de regressão quando removido. Combina alto leverage com um resíduo grande. Medido pela distância de Cook:
\[D_i = \frac{(\hat{\boldsymbol{\beta}} - \hat{\boldsymbol{\beta}}_{(-i)})^T \mathbf{X}^T\mathbf{X} (\hat{\boldsymbol{\beta}} - \hat{\boldsymbol{\beta}}_{(-i)})}{(k+1)\hat{\sigma}^2}\]
\(D_i > 0{,}5\) merece investigação; \(D_i > 1\) geralmente é considerado influente.
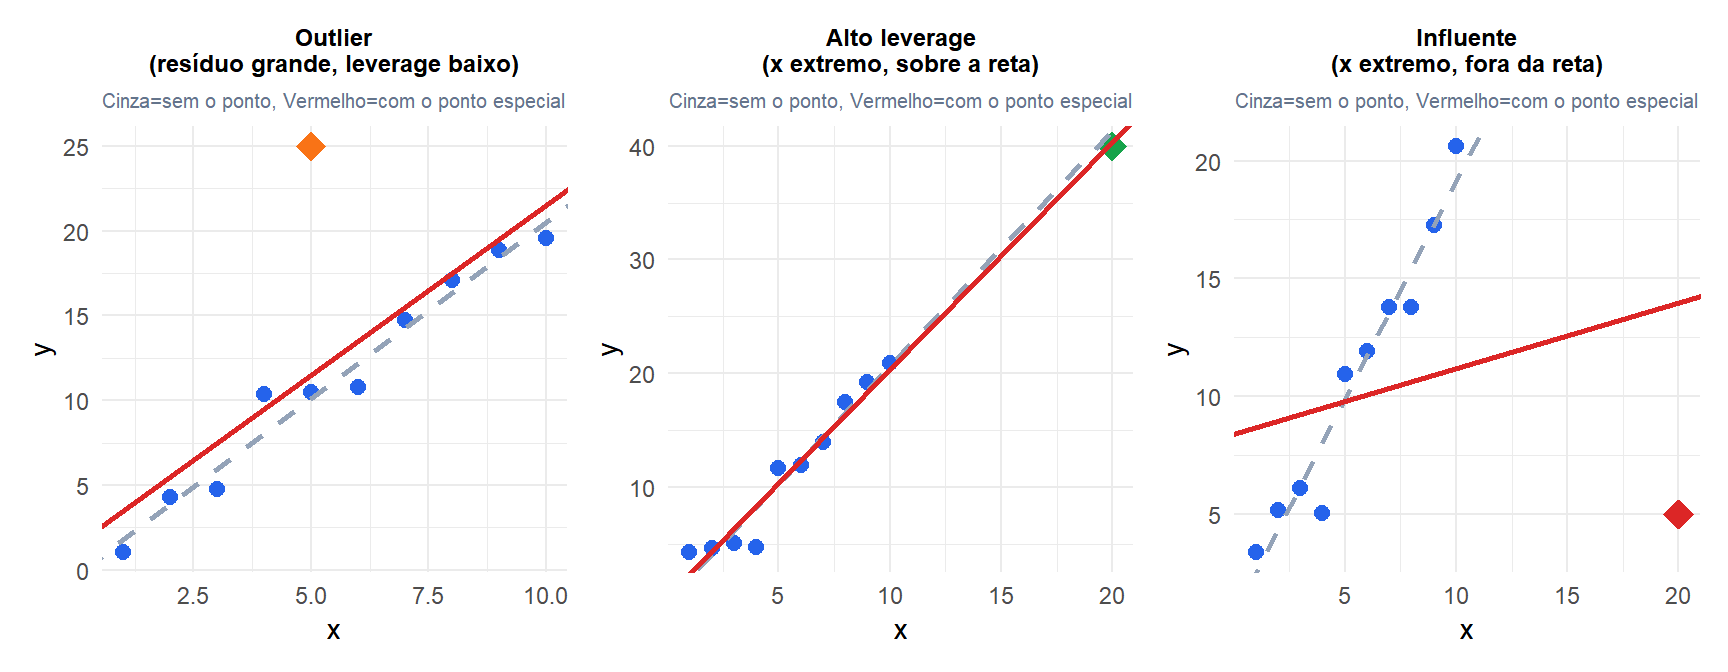
O outlier (laranja) tem um resíduo grande, mas está em \(x=5\) (próximo de \(\bar{x}\)): a reta quase não se move. O ponto de alto leverage (verde) está longe de \(\bar{x}\), mas se encontra sobre a reta verdadeira: a reta quase não se move. O ponto influente (vermelho) combina \(x\) extremo com um resíduo grande: a reta gira substancialmente.
⚠️ Nunca exclua pontos influentes sem investigar
Uma observação influente não é automaticamente um erro. Ela poderia ser:
- Um ponto genuinamente extremo, mas válido, que o modelo deveria acomodar.
- Um erro de entrada de dados que deveria ser corrigido.
- Uma quebra estrutural ou evento especial (uma crise financeira, uma mudança de política) que justifica uma variável indicadora separada.
Antes de remover qualquer ponto, investigue por que ele é influente. Excluir observações influentes válidas para melhorar métricas de ajuste é manipulação de dados e produz um modelo que falhará em observações semelhantes no futuro.
💡 Diagnósticos de regressão em R
fit <- lm(y ~ x1 + x2, data=df)

# Four diagnostic plots at once
par(mfrow=c(2,2))
plot(fit)

# Formal tests
library(lmtest)
bptest(fit)          # Breusch-Pagan: H0 = homoscedasticity
dwtest(fit)          # Durbin-Watson: H0 = no autocorrelation
shapiro.test(residuals(fit))   # H0 = normality

# Influence measures
influencePlot(fit)   # leverage vs standardized residuals
cooks.distance(fit)
hatvalues(fit)

# All at once
library(car)
outlierTest(fit)     # Bonferroni-corrected test for outliers
vif(fit)             # multicollinearity
