Regularização
A regularização adiciona uma penalidade sobre o tamanho dos coeficientes do modelo à função de perda. Isso encolhe os coeficientes em direção a zero, reduzindo a variância ao custo de um pequeno aumento no viés. O resultado é um modelo que generaliza melhor para dados novos. Ridge e Lasso são os dois métodos fundamentais de regularização; o ElasticNet os combina.
Por que a regularização é necessária
O MQO minimiza o erro de treinamento sem nenhuma restrição sobre o tamanho dos coeficientes. Quando o número de preditores \(p\) é grande em relação a \(n\), ou quando os preditores são correlacionados, o MQO produz coeficientes grandes e instáveis que se ajustam bem aos dados de treinamento, mas falham em dados novos.
Considere ajustar um modelo com \(p = n - 1\) preditores: o MQO atinge erro de treinamento zero interpolando cada ponto. Os coeficientes são enormes e o modelo é inútil para previsão. A regularização evita isso penalizando coeficientes grandes.
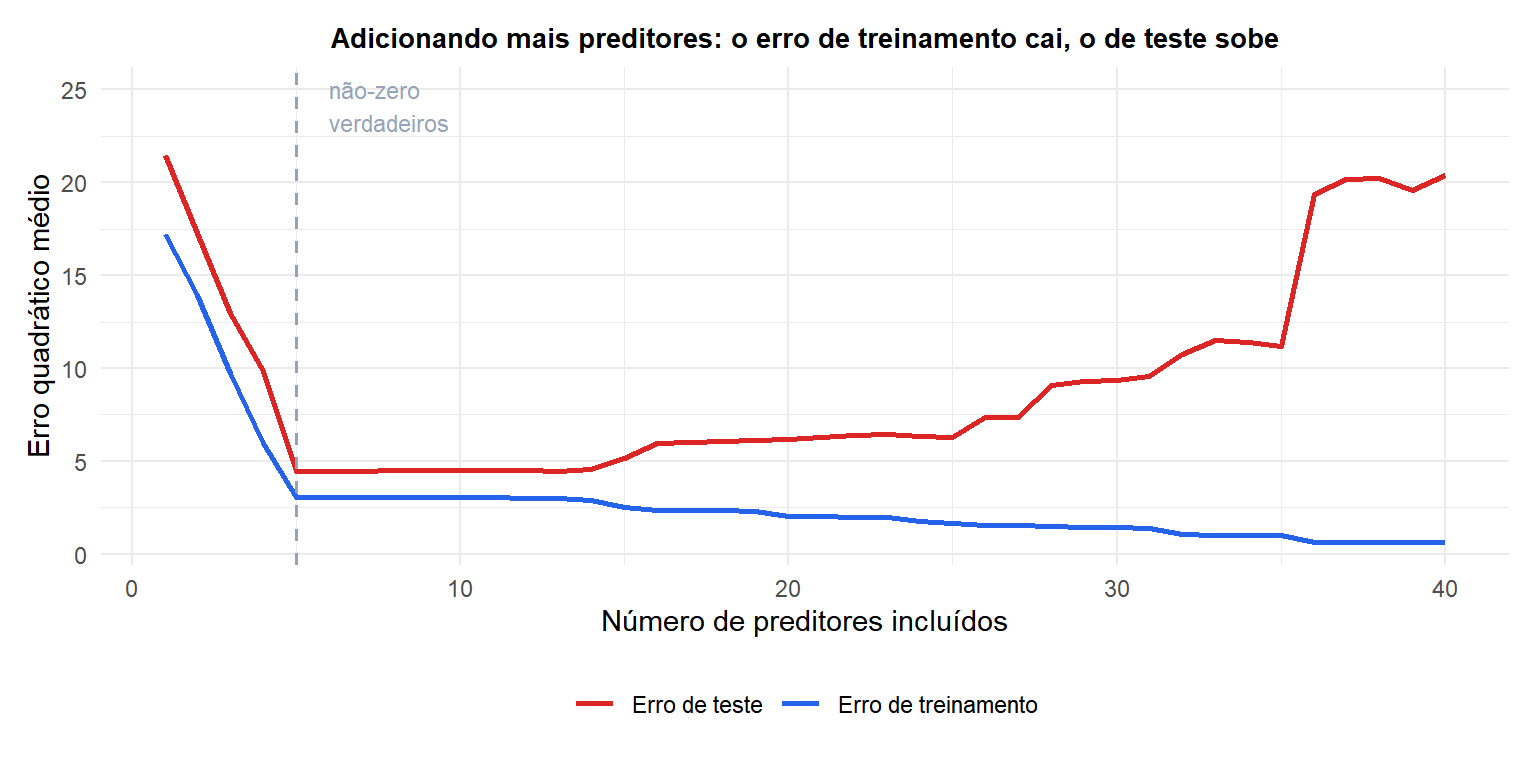
O erro de treinamento (azul) sempre diminui conforme mais preditores são adicionados. O erro de teste (vermelho) diminui inicialmente, depois sobe conforme o modelo começa a sofrer overfitting do ruído.
A estrutura de perda penalizada
A regularização modifica o objetivo do MQO adicionando uma penalidade sobre o vetor de coeficientes:
\[\hat{\boldsymbol{\beta}}_\lambda = \arg\min_{\boldsymbol{\beta}} \underbrace{\|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|_2^2}_{\text{ajuste aos dados}} + \lambda \underbrace{\Omega(\boldsymbol{\beta})}_{\text{penalidade}}\]
- \(\lambda \geq 0\): o parâmetro de regularização. Controla a intensidade da penalidade.
- \(\lambda = 0\): sem regularização, reduz-se ao MQO.
- \(\lambda \to \infty\): todos os coeficientes encolhem para zero.
- \(\Omega(\boldsymbol{\beta})\): a função de penalidade. Escolhas diferentes dão métodos diferentes.
O intercepto \(\beta_0\) nunca é penalizado: ele apenas desloca as previsões, e encolhê-lo introduziria viés na média.
Ridge (\(L_2\)) e Lasso (\(L_1\))
Regressão Ridge (penalidade \(L_2\))
\[\hat{\boldsymbol{\beta}}^{\text{Ridge}} = \arg\min_{\boldsymbol{\beta}} \|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|_2^2 + \lambda \sum_j \beta_j^2\]
Tem solução em forma fechada: \(\hat{\boldsymbol{\beta}}^{\text{Ridge}} = (\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I})^{-1}\mathbf{X}^T\mathbf{y}\).
O Ridge encolhe todos os coeficientes em direção a zero, mas nunca a exatamente zero. Ele trata bem a multicolinearidade: adicionar \(\lambda\mathbf{I}\) torna \(\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I}\) invertível mesmo quando \(\mathbf{X}^T\mathbf{X}\) é singular.
Regressão Lasso (penalidade \(L_1\))
\[\hat{\boldsymbol{\beta}}^{\text{Lasso}} = \arg\min_{\boldsymbol{\beta}} \|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|_2^2 + \lambda \sum_j |\beta_j|\]
Sem solução em forma fechada: exige descida de coordenadas ou métodos de subgradiente. A propriedade-chave: o Lasso pode encolher coeficientes a exatamente zero, realizando seleção automática de variáveis. Coeficientes de preditores irrelevantes são fixados em exatamente zero conforme \(\lambda\) aumenta.
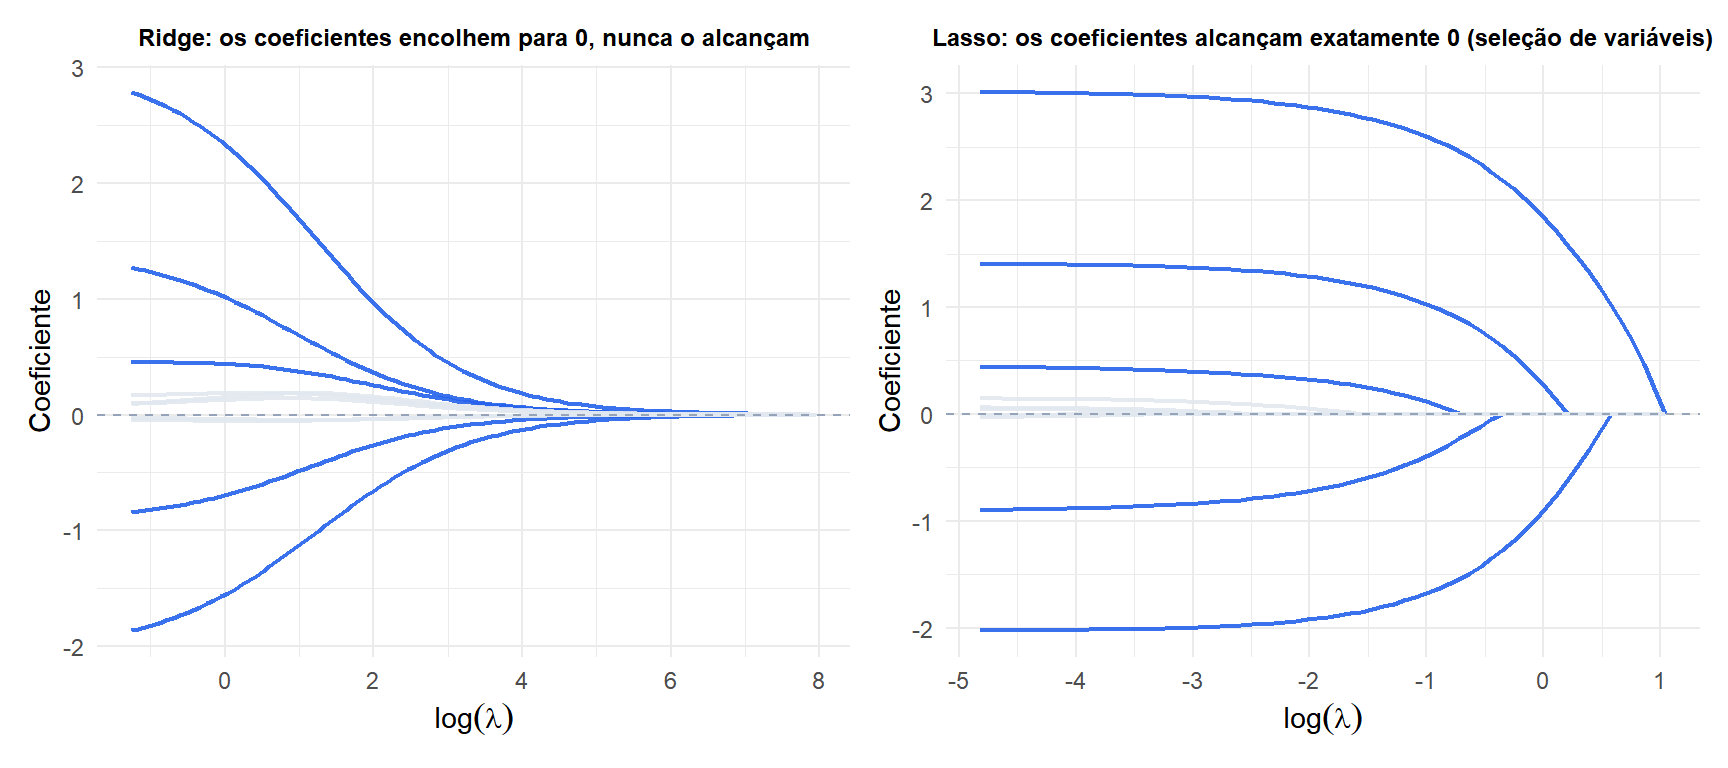
No caminho do Ridge (esquerda), todos os coeficientes encolhem suavemente, mas permanecem não nulos. No caminho do Lasso (direita), os cinco coeficientes verdadeiramente zero (cinza) são eliminados logo cedo conforme \(\lambda\) aumenta; os cinco não nulos (azul) persistem por mais tempo.
Intuição geométrica
A forma restrita da regularização revela por que as duas penalidades se comportam de maneira diferente:
- Ridge: minimizar \(\|\mathbf{y}-\mathbf{X}\boldsymbol{\beta}\|^2\) sujeito a \(\sum_j \beta_j^2 \leq t\). A região de restrição é uma esfera. A solução de MQO é puxada em direção à superfície da esfera; ela toca a esfera em um ponto em que nenhum coeficiente é exatamente zero.
- Lasso: minimizar sujeito a \(\sum_j |\beta_j| \leq t\). A região de restrição é um diamante (bola \(L_1\)). O diamante tem vértices nos eixos coordenados. A solução de MQO é puxada em direção ao ponto mais próximo no diamante; frequentemente ela atinge um vértice, em que uma ou mais coordenadas são exatamente zero.
Esse argumento geométrico explica por que o Lasso produz soluções esparsas e o Ridge não.
Selecionando \(\lambda\)
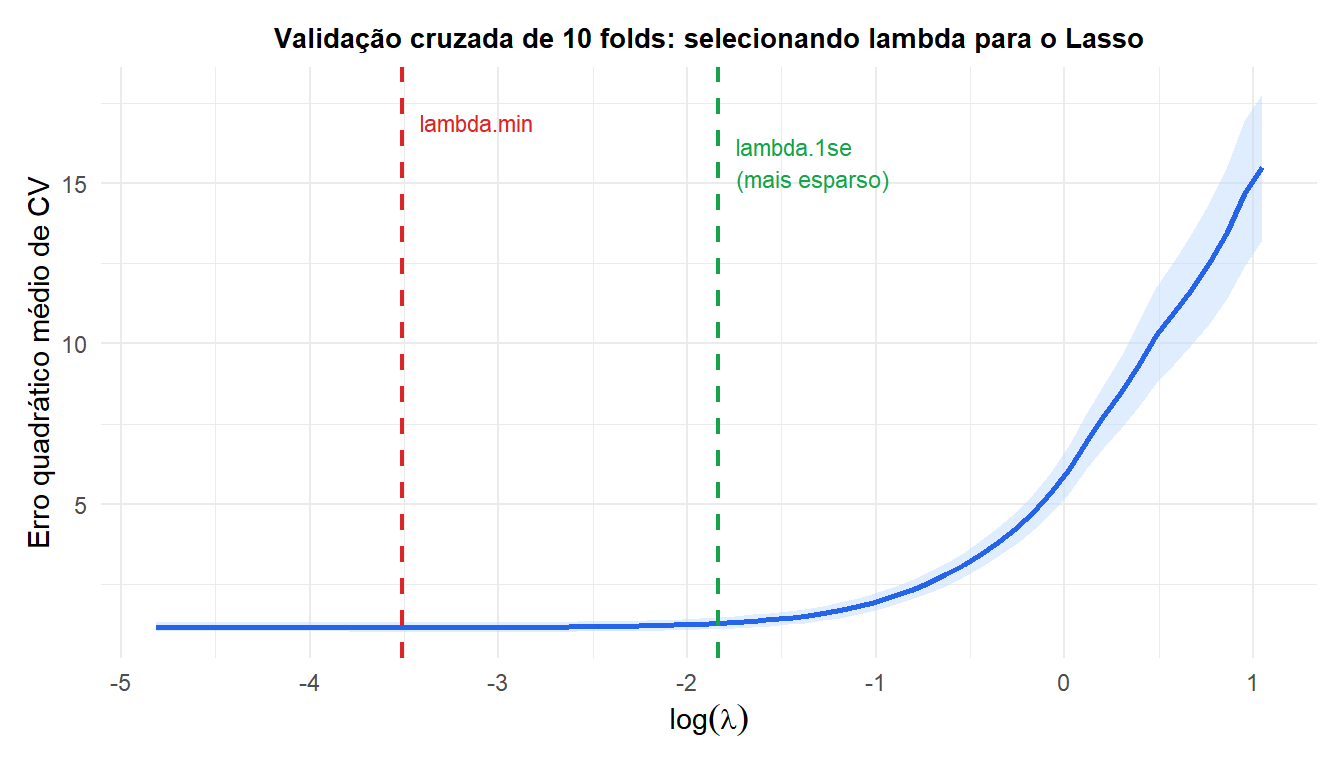
\(\lambda\) é um hiperparâmetro: não é estimado a partir dos dados pelo MQO, mas selecionado por validação cruzada. A abordagem padrão:
- Ajuste o modelo em uma grade de valores de \(\lambda\) (por exemplo, 100 valores em escala logarítmica, de muito grande a próximo de zero).
- Para cada \(\lambda\), calcule o erro de validação cruzada (tipicamente CV de 10 folds).
- Escolha o \(\lambda\) que minimiza o erro de CV (
lambda.min), ou o maior \(\lambda\) dentro de um erro padrão do mínimo (lambda.1se): este último dá um modelo mais esparso com desempenho preditivo semelhante.
Interpretação bayesiana
A regularização tem uma interpretação bayesiana clara como estimação MAP (máximo a posteriori) com diferentes prioris sobre \(\boldsymbol{\beta}\):
- Ridge: equivalente a uma priori gaussiana \(\beta_j \sim N(0, 1/\lambda)\). A priori gaussiana não tem massa em exatamente zero, então o Ridge nunca produz esparsidade exata.
- Lasso: equivalente a uma priori de Laplace (dupla exponencial) \(\beta_j \sim \text{Laplace}(0, 1/\lambda)\). A priori de Laplace tem um pico agudo em zero, favorecendo zeros exatos.
Isso explica por que o Lasso faz seleção de variáveis e o Ridge não: é uma consequência da forma da priori em zero.
⚠️ Padronize os preditores antes de regularizar
Ridge e Lasso penalizam coeficientes grandes. Se os preditores estão em escalas diferentes (por exemplo, renda em milhares vs idade em anos), as penalidades são aplicadas de forma desigual: o preditor com a maior escala recebe o maior encolhimento, independentemente de sua importância.
Sempre padronize os preditores para média zero e variância unitária antes de ajustar modelos regularizados. O glmnet faz isso automaticamente por padrão (standardize=TRUE). Ao usar outro software, padronize manualmente antes.
Além disso: o intercepto não é penalizado e não deve ser padronizado.
💡 Ridge e Lasso em R
library(glmnet)

# Standardize predictors (done automatically by glmnet)
# alpha=0: Ridge; alpha=1: Lasso; alpha in (0,1): ElasticNet
fit_ridge <- glmnet(X, y, alpha=0)
fit_lasso <- glmnet(X, y, alpha=1)

# Select lambda by cross-validation
cv_fit <- cv.glmnet(X, y, alpha=1, nfolds=10)
best_lambda <- cv_fit$lambda.min     # minimum CV error
sparse_lambda <- cv_fit$lambda.1se  # 1-SE rule (sparser)

# Coefficients at best lambda
coef(cv_fit, s="lambda.min")
coef(cv_fit, s="lambda.1se")

# Predictions
predict(cv_fit, newx=X_new, s="lambda.min")
