Redes neurais
Uma rede neural feedforward é uma composição de transformações afins e funções de ativação não lineares. Adicionar camadas permite que a rede aprenda representações hierárquicas: camadas iniciais detectam padrões simples, camadas posteriores os combinam em padrões complexos. O backpropagation calcula eficientemente o gradiente da perda em relação a cada peso via regra da cadeia, permitindo que o gradiente descendente otimize milhões de parâmetros.
Arquitetura
Uma rede com \(L\) camadas calcula:
\[\mathbf{a}^{(0)} = \mathbf{x} \quad (\text{entrada})\]
\[\mathbf{z}^{(\ell)} = \mathbf{W}^{(\ell)}\mathbf{a}^{(\ell-1)} + \mathbf{b}^{(\ell)}, \qquad \mathbf{a}^{(\ell)} = g^{(\ell)}(\mathbf{z}^{(\ell)}), \qquad \ell = 1,\ldots,L\]
em que \(\mathbf{W}^{(\ell)}\) e \(\mathbf{b}^{(\ell)}\) são a matriz de pesos e o vetor de bias da camada \(\ell\), e \(g^{(\ell)}\) é a função de ativação. A saída da camada final \(\mathbf{a}^{(L)}\) é a previsão.
Teorema da aproximação universal: uma rede feedforward com uma única camada oculta e uma ativação não linear pode aproximar qualquer função contínua em um domínio compacto com precisão arbitrária, dados neurônios suficientes. Isso garante poder expressivo, mas não diz nada sobre como encontrar os pesos ou quantos neurônios são necessários na prática.
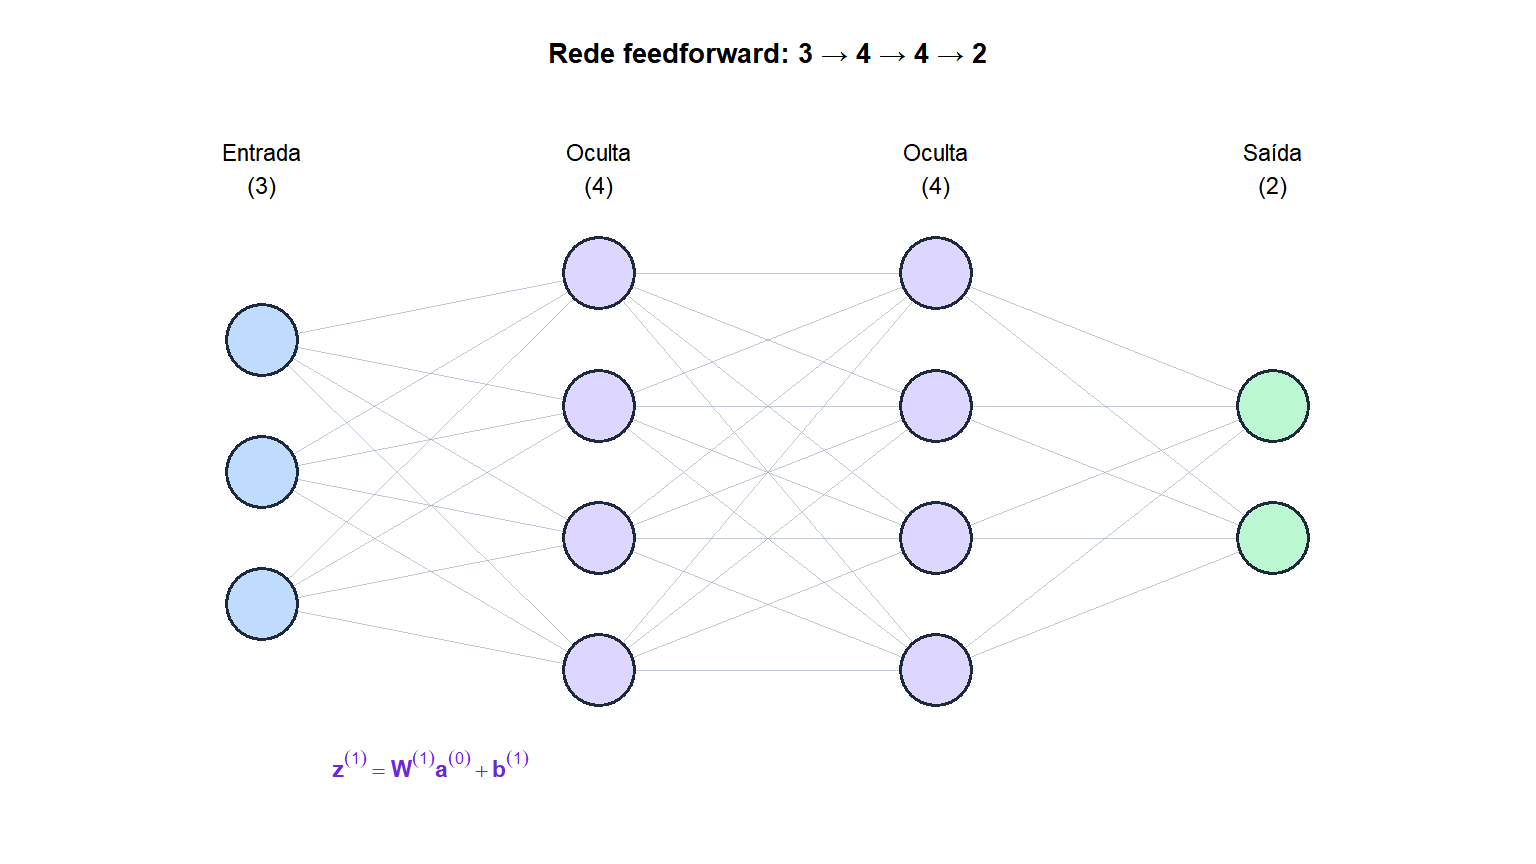
Funções de ativação
Sem funções de ativação não lineares, uma rede profunda se reduz a uma única transformação linear, independentemente da profundidade. As funções de ativação rompem essa linearidade.
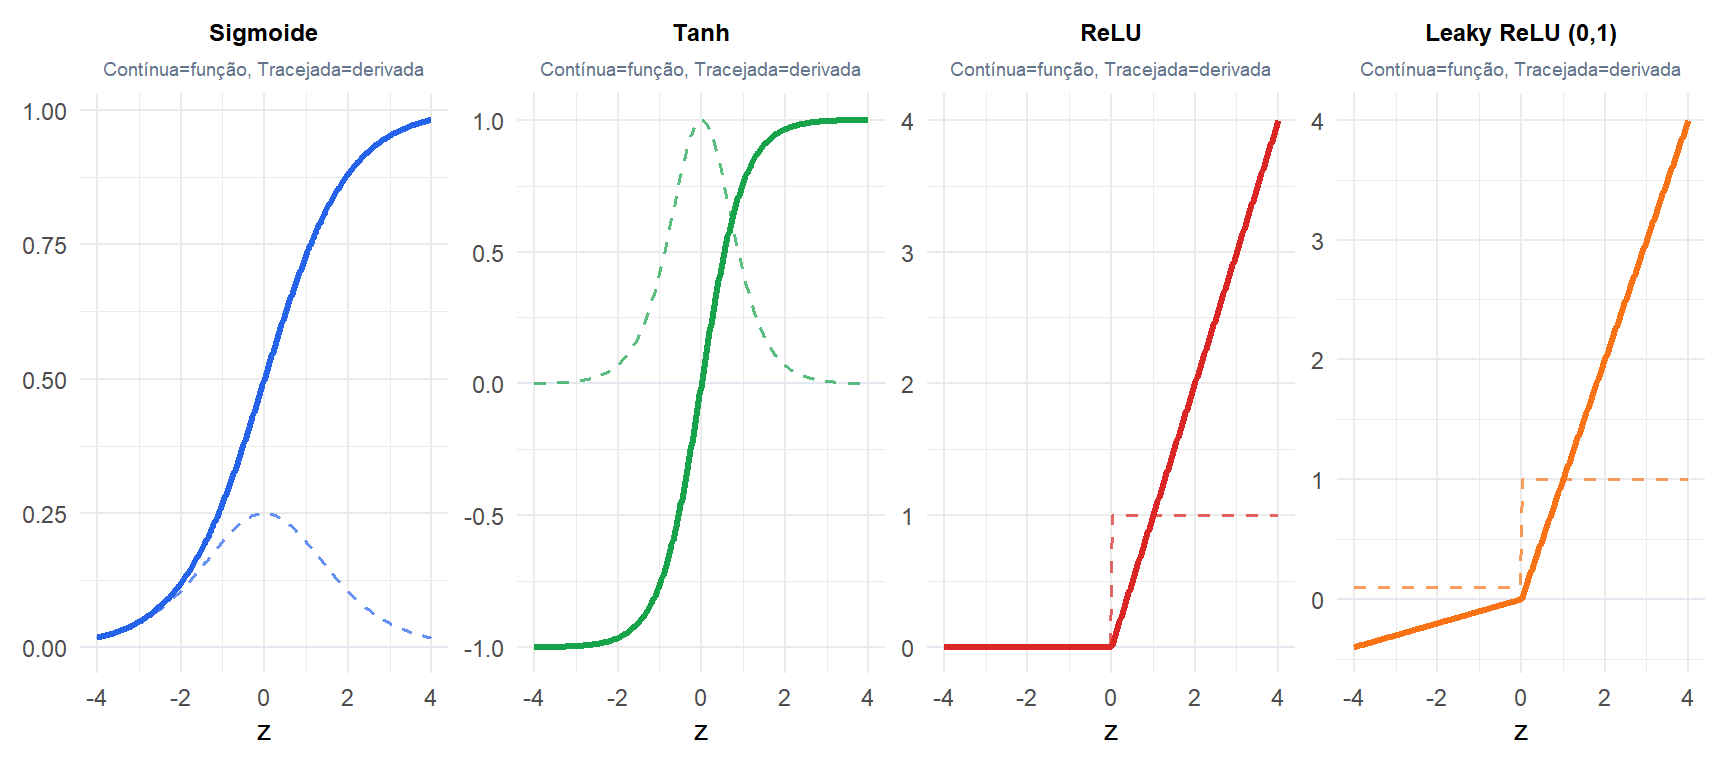
Sigmoide e tanh saturam em valores extremos: suas derivadas se aproximam de zero, causando o problema do gradiente que desaparece. A ReLU (\(\max(0,z)\)) tem uma derivada constante de 1 para entradas positivas, o que evita que o gradiente desapareça e é a escolha padrão para camadas ocultas. Sua fraqueza: neurônios mortos (a saída da ReLU é sempre zero para entradas \(\leq 0\), então o gradiente é zero e o neurônio nunca se atualiza). A Leaky ReLU corrige isso permitindo uma pequena inclinação negativa.
Backpropagation
O backpropagation calcula \(\partial \mathcal{L}/\partial \mathbf{W}^{(\ell)}\) para todas as camadas eficientemente usando a regra da cadeia. Defina o sinal de erro na camada \(\ell\) como \(\boldsymbol{\delta}^{(\ell)} = \partial \mathcal{L}/\partial \mathbf{z}^{(\ell)}\).
Passagem direta: calcule \(\mathbf{z}^{(\ell)}\) e \(\mathbf{a}^{(\ell)}\) para todas as camadas, armazenando os valores intermediários.
Passagem reversa: começando a partir da camada de saída:
\[\boldsymbol{\delta}^{(L)} = \nabla_{\mathbf{a}^{(L)}} \mathcal{L} \odot g'^{(L)}(\mathbf{z}^{(L)})\]
\[\boldsymbol{\delta}^{(\ell)} = \left[(\mathbf{W}^{(\ell+1)})^T \boldsymbol{\delta}^{(\ell+1)}\right] \odot g'^{(\ell)}(\mathbf{z}^{(\ell)})\]
\[\frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(\ell)}} = \boldsymbol{\delta}^{(\ell)}(\mathbf{a}^{(\ell-1)})^T, \qquad \frac{\partial \mathcal{L}}{\partial \mathbf{b}^{(\ell)}} = \boldsymbol{\delta}^{(\ell)}\]
O custo total é \(O(W)\) por amostra, em que \(W\) é o número de pesos: a mesma ordem de uma única passagem direta. Sem backpropagation, a diferenciação numérica custaria \(O(W^2)\).
Atualização de pesos (SGD por mini-batch):
\[\mathbf{W}^{(\ell)} \leftarrow \mathbf{W}^{(\ell)} - \frac{\eta}{B}\sum_{i \in \mathcal{B}} \frac{\partial \mathcal{L}_i}{\partial \mathbf{W}^{(\ell)}}\]
em que \(B\) é o tamanho do mini-batch e \(\eta\) é a taxa de aprendizado.
O problema do gradiente que desaparece
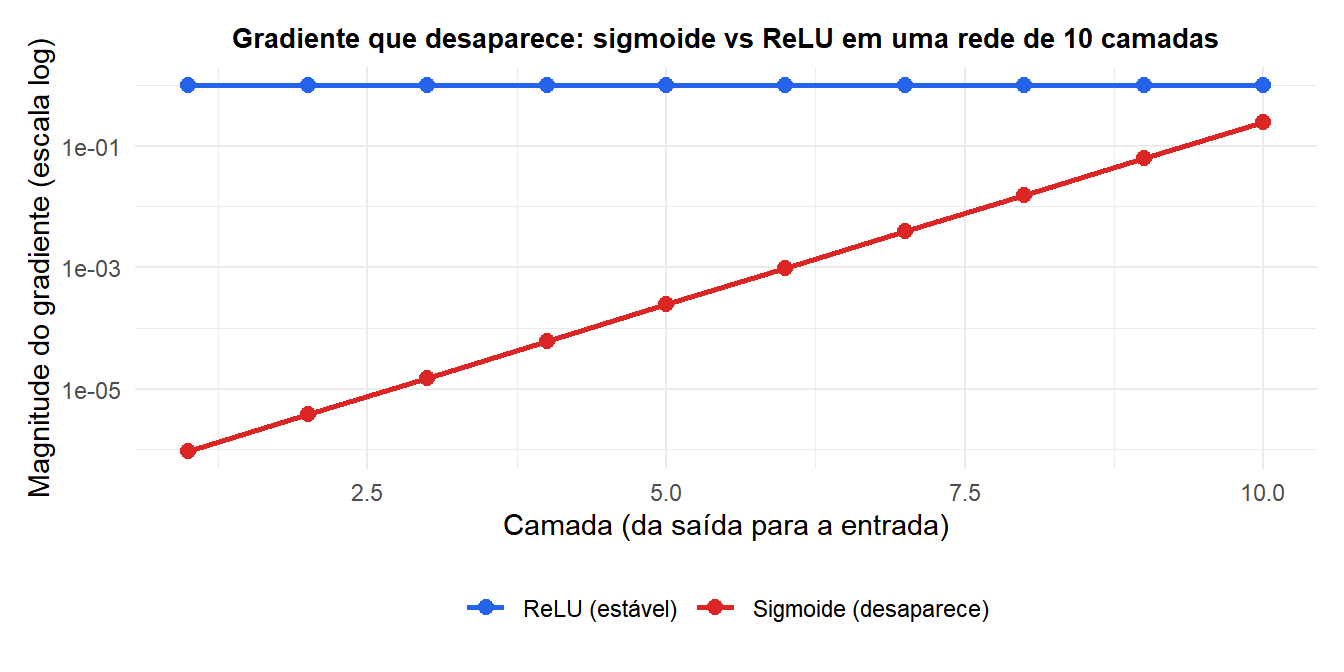
Em redes profundas com ativações sigmoide ou tanh, o gradiente da perda em relação aos pesos das camadas iniciais envolve produtos de muitos termos como \(\sigma'(z) \leq 0{,}25\). Para uma rede de 10 camadas: \(0{,}25^{10} \approx 10^{-6}\). O gradiente efetivamente desaparece, e as camadas iniciais aprendem extremamente devagar ou nem aprendem.
Regularização
Redes neurais têm muitos parâmetros e sofrem overfitting facilmente sem regularização.
Dropout
A cada passo de treinamento, zere aleatoriamente a saída de cada neurônio com probabilidade \(p\) (tipicamente 0,2-0,5). No momento do teste, reescale as saídas por \((1-p)\). Isso evita a coadaptação: nenhum neurônio pode depender da presença de outros neurônios específicos. Equivalente a treinar um ensemble de \(2^n\) redes diferentes e calcular a média de suas previsões.
Normalização em lote
Após cada transformação linear, normalize as ativações para média zero e variância unitária ao longo do mini-batch, depois reescale e desloque com parâmetros aprendidos \(\gamma\) e \(\beta\):
\[\hat{\mathbf{z}} = \frac{\mathbf{z} - \mu_{\mathcal{B}}}{\sqrt{\sigma_{\mathcal{B}}^2 + \varepsilon}}, \qquad \mathbf{a} = \gamma\hat{\mathbf{z}} + \beta\]
A normalização em lote acelera o treinamento reduzindo a mudança interna de covariáveis, permite taxas de aprendizado mais altas, e tem um leve efeito de regularização. É padrão na maioria das arquiteturas modernas de deep learning.
Weight decay (regularização \(L_2\))
Adicione \(\lambda\|\mathbf{W}\|_F^2\) à perda. Encolhe os pesos em direção a zero, reduzindo a complexidade do modelo. Equivalente a uma priori Gaussiana sobre os pesos, de uma perspectiva bayesiana.
⚠️ Redes neurais exigem inicialização cuidadosa
Se os pesos forem inicializados em zero, todos os neurônios calculam a mesma saída e recebem o mesmo gradiente: a rede nunca rompe a simetria. Se os pesos forem muito grandes, as ativações saturam e os gradientes desaparecem. Se forem muito pequenos, os sinais se dissipam através das camadas.
Inicialização padrão: inicialização He (\(\mathbf{W} \sim N(0, 2/n_\text{entrada})\)) para ReLU; inicialização Glorot/Xavier (\(\mathbf{W} \sim N(0, 2/(n_\text{entrada}+n_\text{saída}))\)) para tanh/sigmoide. Essas mantêm a variância das ativações e dos gradientes aproximadamente constante entre as camadas.
💡 Redes neurais em R
library(torch)

# Define a simple feedforward network
net <- nn_module(
  initialize = function() {
    self$fc1 <- nn_linear(10, 64)
    self$fc2 <- nn_linear(64, 32)
    self$fc3 <- nn_linear(32, 1)
    self$drop <- nn_dropout(p=0.3)
  },
  forward = function(x) {
    x %>% self$fc1() %>% nnf_relu() %>%
          self$drop() %>%
          self$fc2() %>% nnf_relu() %>%
          self$fc3() %>% torch_sigmoid()
  }
)

# With keras (simpler interface)
library(keras)
model <- keras_model_sequential() %>%
  layer_dense(64, activation="relu", input_shape=10) %>%
  layer_batch_normalization() %>%
  layer_dropout(0.3) %>%
  layer_dense(32, activation="relu") %>%
  layer_dense(1,  activation="sigmoid")

model %>% compile(optimizer="adam",
                  loss="binary_crossentropy",
                  metrics="accuracy")
model %>% fit(X_train, y_train, epochs=50,
              batch_size=32, validation_split=0.2)
