Regressão linear múltipla
A regressão linear múltipla estende a regressão simples para \(k\) preditores. Cada coeficiente mede o efeito de um preditor mantendo todos os outros constantes, uma distinção crucial em relação à regressão simples, em que cada coeficiente também absorve os efeitos das variáveis omitidas.
O modelo
Adicionar preditores simplesmente estende a mesma equação linear com mais termos, um coeficiente por preditor:
\[y_i = \beta_0 + \beta_1 x_{i1} + \beta_2 x_{i2} + \cdots + \beta_k x_{ik} + \varepsilon_i, \qquad \varepsilon_i \sim N(0, \sigma^2)\]
Em forma matricial, com \(\mathbf{y} \in \mathbb{R}^n\), matriz de desenho \(\mathbf{X} \in \mathbb{R}^{n \times (k+1)}\) (primeira coluna toda de uns) e \(\boldsymbol{\beta} \in \mathbb{R}^{k+1}\):
\[\mathbf{y} = \mathbf{X}\boldsymbol{\beta} + \boldsymbol{\varepsilon}, \qquad \boldsymbol{\varepsilon} \sim N(\mathbf{0}, \sigma^2 \mathbf{I})\]
O estimador de MQO minimiza \(\|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|^2\) e tem a solução em forma fechada:
\[\hat{\boldsymbol{\beta}} = (\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T\mathbf{y}\]
Isso exige que \(\mathbf{X}^T\mathbf{X}\) seja invertível: as colunas de \(\mathbf{X}\) devem ser linearmente independentes (sem multicolinearidade perfeita). Os valores ajustados são \(\hat{\mathbf{y}} = \mathbf{X}\hat{\boldsymbol{\beta}} = \mathbf{H}\mathbf{y}\), em que \(\mathbf{H} = \mathbf{X}(\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T\) é a matriz de projeção (hat matrix).
Teorema de Gauss-Markov: sob linearidade, independência, homocedasticidade e erros de média zero (sem exigir normalidade), o MQO é BLUE: o Melhor Estimador Linear Não Viesado. Nenhum outro estimador linear não viesado tem variância menor.
Interpretando os coeficientes
Cada \(\hat{\beta}_j\) mede a mudança esperada em \(y\) para um aumento de uma unidade em \(x_j\), mantendo todos os outros preditores constantes. Esse efeito parcial é fundamentalmente diferente da inclinação em uma regressão simples, que também captura a correlação entre \(x_j\) e os demais preditores.
\[\widehat{\text{Preço}} = 50.000 + 200 \cdot \text{Área} + 10.000 \cdot \text{Quartos} - 1.000 \cdot \text{Idade}\]
- Coeficiente de área (200): cada m² adicional adiciona €200 ao preço previsto, mantendo quartos e idade fixos.
- Coeficiente de quartos (10.000): cada quarto adicional adiciona €10.000, mantendo área e idade fixas. Note que isso mantém a área constante: uma casa maior que por acaso tem mais quartos não é contada em duplicidade.
- Coeficiente de idade ($-$1.000): cada ano adicional reduz o preço em €1.000, mantendo área e quartos fixos.

Qualidade do ajuste
R² e R² ajustado
\(R^2 = 1 - \text{SQR}/\text{SQT}\) sempre aumenta quando um preditor é adicionado, mesmo que esse preditor seja puro ruído. O R² ajustado penaliza pelo número de preditores \(k\):
\[\bar{R}^2 = 1 - \frac{\text{SQR}/(n-k-1)}{\text{SQT}/(n-1)} = 1 - (1-R^2)\frac{n-1}{n-k-1}\]
O R² ajustado pode diminuir quando um preditor irrelevante é adicionado. Use \(R^2\) para reportar a variância explicada; use o R² ajustado ou o AIC/BIC para seleção de modelos.
Teste F para significância global
Testa \(H_0: \beta_1 = \beta_2 = \cdots = \beta_k = 0\) (nenhum preditor é útil) contra \(H_1\): pelo menos um \(\beta_j \neq 0\):
\[F = \frac{(\text{SQT}-\text{SQR})/k}{\text{SQR}/(n-k-1)} = \frac{\text{QMR}}{\text{QME}} \sim F(k, n-k-1) \text{ sob } H_0\]
Um teste F significativo significa que o modelo como um todo é útil. Os testes t individuais então identificam quais preditores contribuem.
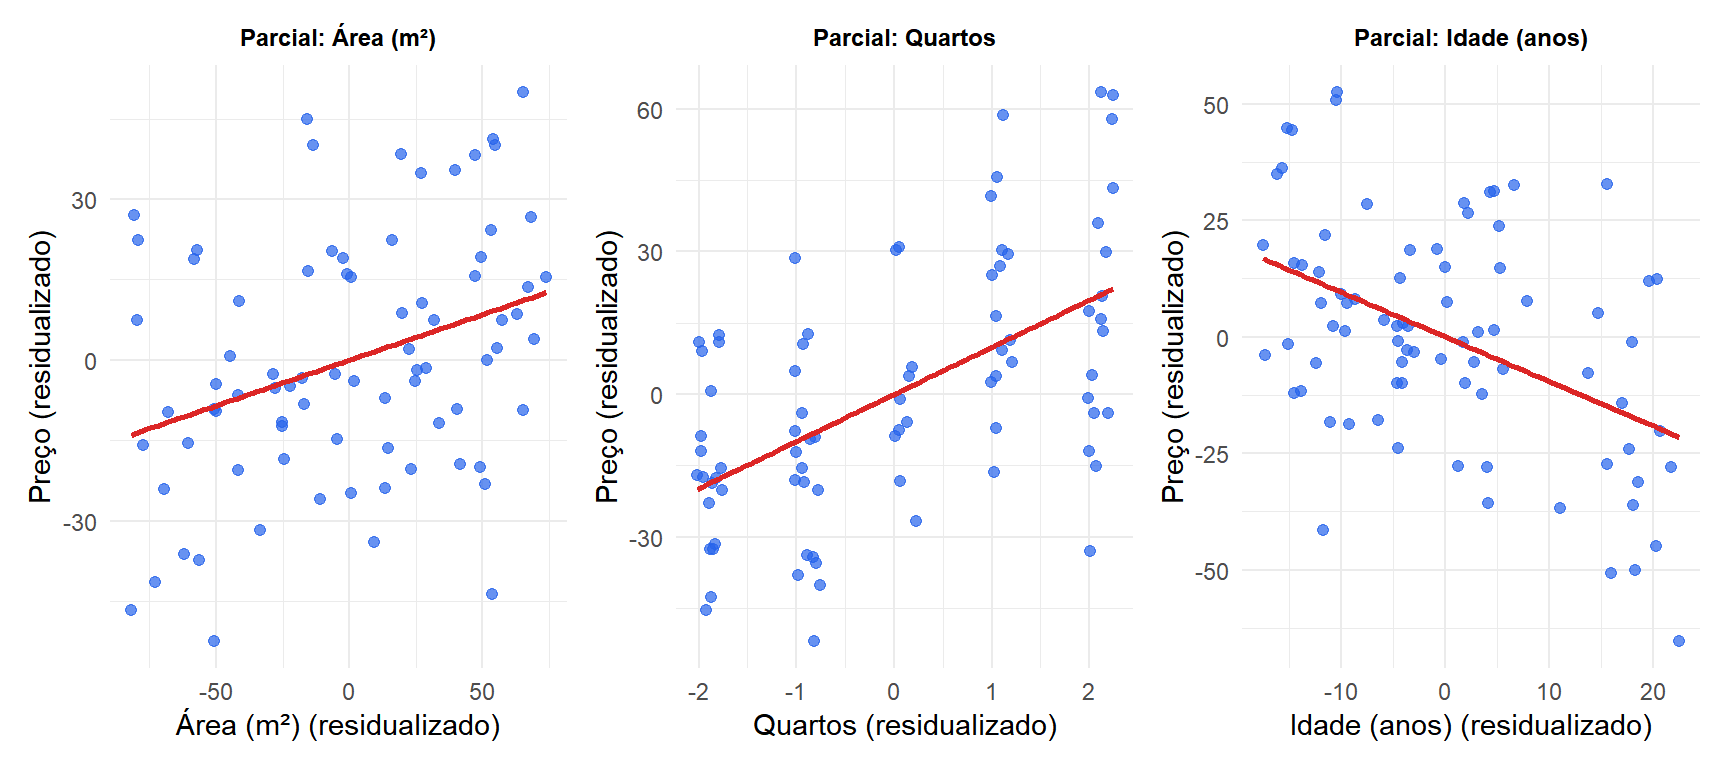
Os gráficos de regressão parcial mostram a relação entre cada preditor e a resposta após remover os efeitos de todos os outros. A inclinação em cada painel é igual ao coeficiente de MQO correspondente: o efeito da área, dos quartos e da idade, cada um mantendo os outros constantes.
Multicolinearidade
Para um exemplo resolvido completo e como corrigi-la, veja o post dedicado a multicolinearidade e VIF.
Quando os preditores são altamente correlacionados, \(\mathbf{X}^T\mathbf{X}\) se torna quase singular: as estimativas dos coeficientes são instáveis, com erros padrão grandes. Os preditores dividem o crédito por explicar \(y\), tornando impossível isolar seus efeitos individuais.
O Fator de Inflação da Variância (VIF) quantifica a multicolinearidade para cada preditor \(j\):
\[\text{VIF}_j = \frac{1}{1 - R_j^2}\]
em que \(R_j^2\) é o \(R^2\) de regredir \(x_j\) sobre todos os outros preditores. Um \(\text{VIF}_j > 10\) (alguns usam 5) indica multicolinearidade problemática.
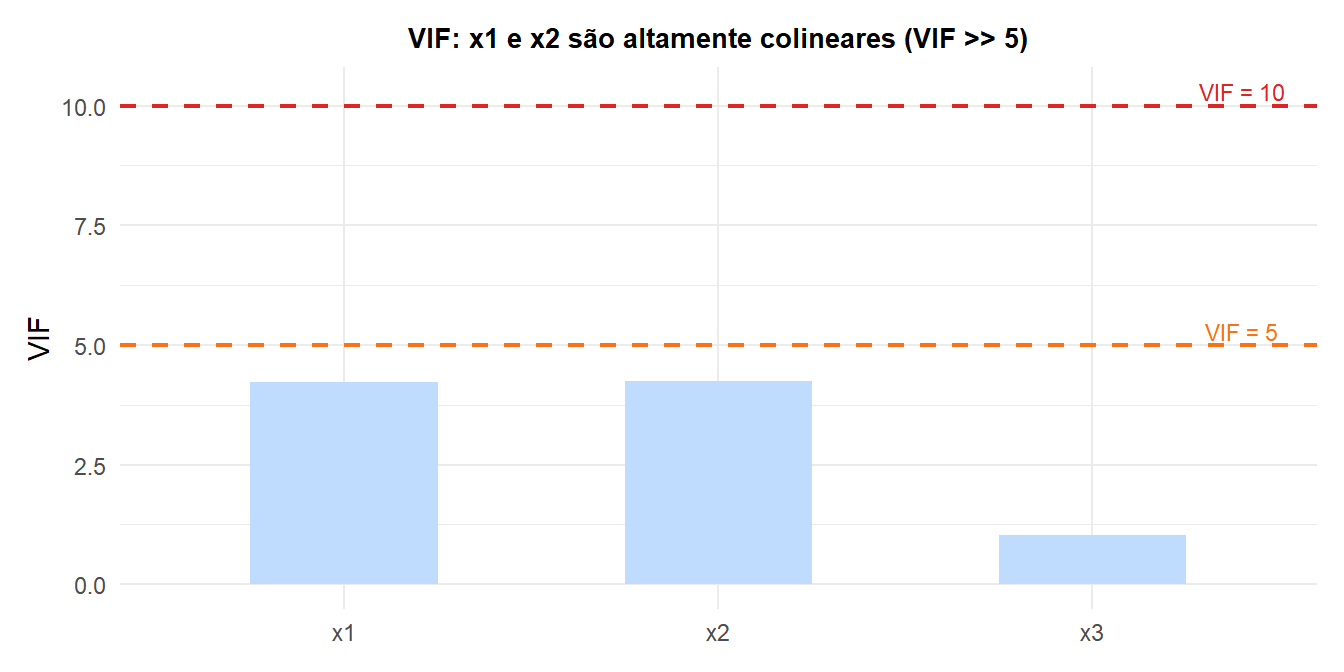
Quando o VIF é alto para \(x_1\) e \(x_2\), os coeficientes individuais \(\hat{\beta}_1\) e \(\hat{\beta}_2\) têm erros padrão grandes e podem até ter o sinal errado, enquanto sua soma \(\hat{\beta}_1 + \hat{\beta}_2\) é estimada com precisão. Soluções: remover um dos preditores colineares, combiná-los (por exemplo, calculando a média) ou usar regressão Ridge.
⚠️ Adicionar preditores sempre aumenta o R², mas não a qualidade do modelo
Todo preditor adicionado a um modelo aumentará (ou, na pior das hipóteses, não mudará) o \(R^2\), mesmo que seja puro ruído aleatório. Com \(n=20\) observações e \(k=19\) preditores, \(R^2 = 1\) por construção, mas o modelo não prevê nada útil em dados novos.
Use sempre o R² ajustado, o AIC ou o BIC para comparar modelos com números diferentes de preditores. Melhor ainda, avalie com dados retidos por meio de validação cruzada: apenas as melhorias que generalizam para dados novos são reais.
💡 Regressão linear múltipla em R
fit <- lm(price ~ size + bedrooms + age, data = df)
summary(fit)             # coefficients, t-tests, F-test, R² and adjusted R²
confint(fit)             # 95% CIs for all coefficients
anova(fit)               # ANOVA table

# Multicollinearity
library(car)
vif(fit)                 # VIF for each predictor; > 5 is concerning

# Partial regression plots
avPlots(fit)

# Model comparison
AIC(fit1, fit2)
BIC(fit1, fit2)
