Regressão Ridge
A regressão Ridge (também chamada de regularização de Tikhonov ou regularização \(L_2\)) adiciona a soma dos coeficientes ao quadrado como penalidade ao objetivo do MQO. O resultado é uma solução em forma fechada que encolhe todos os coeficientes em direção a zero e corrige a instabilidade causada por matrizes de desenho quase singulares ou singulares.
Função objetivo e solução
O Ridge adiciona um único termo de penalidade ao objetivo dos mínimos quadrados ordinários, e essa única mudança produz um estimador em forma fechada:
\[\hat{\boldsymbol{\beta}}^R = \arg\min_{\boldsymbol{\beta}} \|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|_2^2 + \lambda\|\boldsymbol{\beta}\|_2^2\]
\[\hat{\boldsymbol{\beta}}^R = (\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I})^{-1}\mathbf{X}^T\mathbf{y}\]
Adicionar \(\lambda\mathbf{I}\) a \(\mathbf{X}^T\mathbf{X}\) antes de inverter é a operação-chave. Mesmo quando \(\mathbf{X}^T\mathbf{X}\) é singular (preditores perfeitamente colineares, \(p > n\)), \(\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I}\) é sempre invertível para qualquer \(\lambda > 0\). É por isso que o Ridge é particularmente eficaz para multicolinearidade.
A decomposição viés-variância do estimador Ridge:
\[E[\hat{\boldsymbol{\beta}}^R] = (\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I})^{-1}\mathbf{X}^T\mathbf{X}\boldsymbol{\beta} \neq \boldsymbol{\beta} \quad (\text{viesado})\]
\[\text{Var}(\hat{\boldsymbol{\beta}}^R) = \sigma^2(\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I})^{-1}\mathbf{X}^T\mathbf{X}(\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I})^{-1}\]
A variância é estritamente menor do que a variância do MQO; o viés aumenta com \(\lambda\). Para \(\lambda\) suficientemente grande, a redução na variância supera o aumento no viés: o EQM total diminui.
Interpretação via SVD: encolhendo os valores singulares
A decomposição em valores singulares \(\mathbf{X} = \mathbf{U}\mathbf{D}\mathbf{V}^T\) (com valores singulares \(d_1 \geq d_2 \geq \cdots \geq d_p\)) dá um retrato claro do que o Ridge faz:
\[\hat{\boldsymbol{\beta}}^R = \mathbf{V}\text{diag}\!\left(\frac{d_j^2}{d_j^2 + \lambda}\right)\mathbf{V}^T\hat{\boldsymbol{\beta}}^{\text{OLS}}\]
Cada coeficiente é multiplicado por um fator de encolhimento \(d_j^2/(d_j^2 + \lambda) \in (0,1)\). Direções com valores singulares grandes (alta variância, bem determinadas pelos dados) são pouco encolhidas. Direções com valores singulares pequenos (baixa variância, mal determinadas, associadas a preditores quase colineares) são fortemente encolhidas.
O Ridge não elimina nenhuma direção: ele encolhe todas elas, de forma mais agressiva nas direções em que os dados fornecem menos informação.
Ridge e multicolinearidade
A multicolinearidade infla a variância dos coeficientes de MQO porque \(\mathbf{X}^T\mathbf{X}\) é quase singular: autovalores pequenos produzem entradas enormes em \((\mathbf{X}^T\mathbf{X})^{-1}\). Adicionar \(\lambda\mathbf{I}\) eleva todos os autovalores em \(\lambda\), reduzindo drasticamente \((\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I})^{-1}\) nas direções de autovalor quase zero.
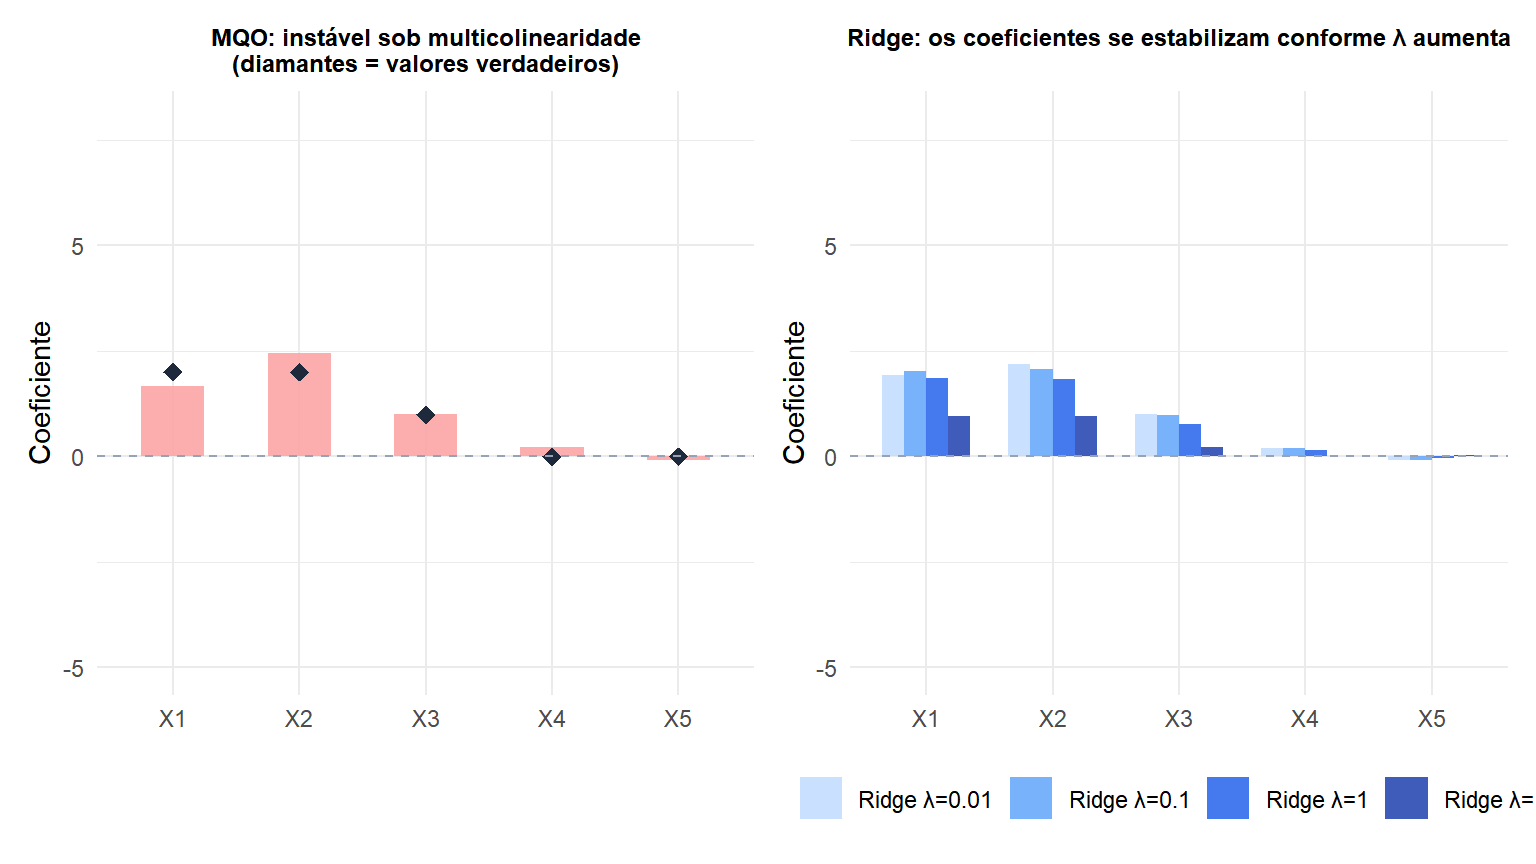
O MQO (esquerda) produz coeficientes extremamente instáveis para \(X_1\) e \(X_2\) (quase colineares). O Ridge (direita) os estabiliza progressivamente conforme \(\lambda\) aumenta, convergindo para estimativas iguais e estáveis.
Caminho de encolhimento e graus de liberdade efetivos
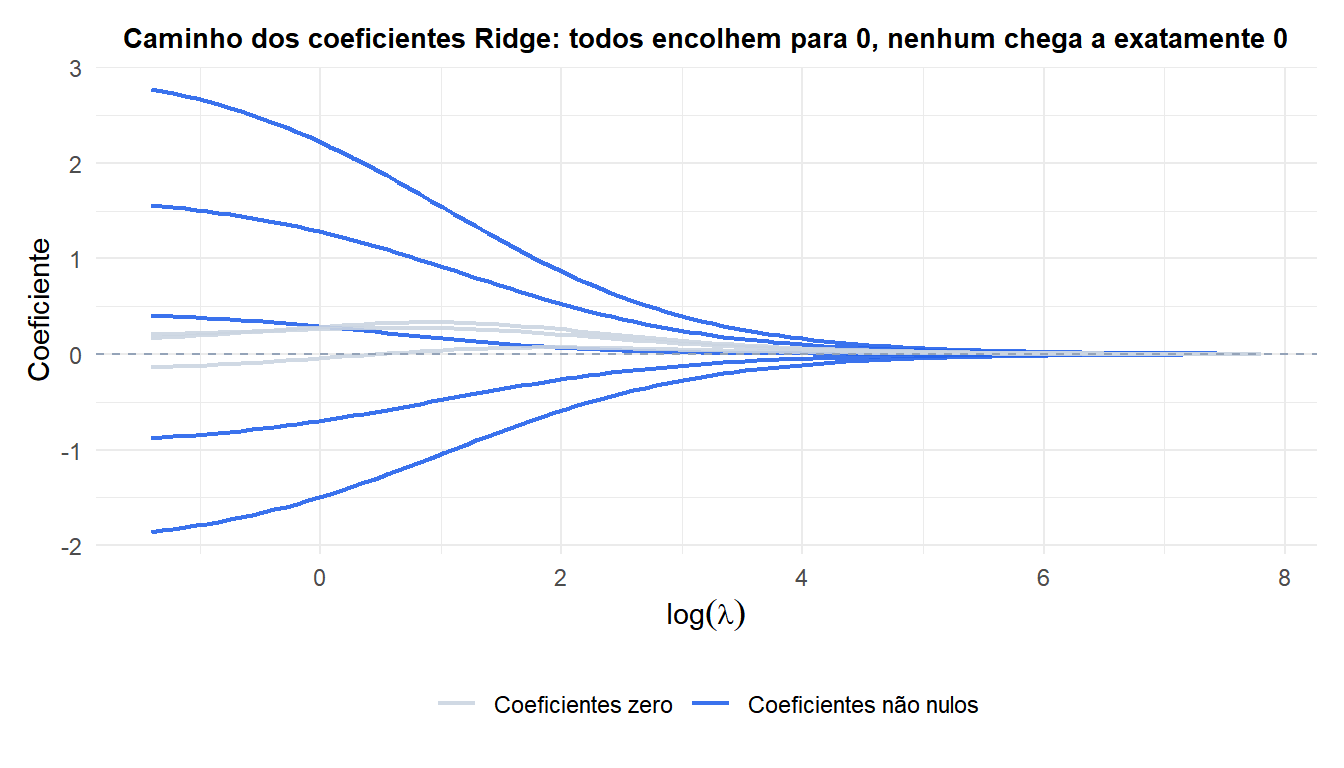
Todos os coeficientes encolhem suavemente conforme \(\lambda\) aumenta. Os cinco coeficientes verdadeiramente não nulos (azul) persistem por mais tempo; os nulos (cinza) já estavam próximos de zero. Nenhum deles chega a exatamente zero, o que distingue o Ridge do Lasso.
Os graus de liberdade efetivos do ajuste Ridge:
\[\text{gl}(\lambda) = \text{tr}\left[\mathbf{X}(\mathbf{X}^T\mathbf{X} + \lambda\mathbf{I})^{-1}\mathbf{X}^T\right] = \sum_{j=1}^p \frac{d_j^2}{d_j^2 + \lambda}\]
Em \(\lambda=0\): gl = \(p\) (MQO). Conforme \(\lambda \to \infty\): gl \(\to\) 0. Isso fornece uma medida interpretável de complexidade do modelo.
Quando usar o Ridge
O Ridge é a escolha natural quando:
- Os preditores são altamente correlacionados (multicolinearidade).
- \(p\) é grande em relação a \(n\), mas espera-se que todos os preditores contribuam (sinal denso).
- O objetivo é a precisão da previsão, e não a seleção de variáveis.
- Sabe-se que a relação entre a resposta e os preditores é densa (muitos efeitos pequenos em vez de poucos grandes).
Se o modelo verdadeiro for esparso (apenas alguns preditores importam), o Lasso ou o ElasticNet terão desempenho superior ao Ridge, porque eles fixam coeficientes irrelevantes em exatamente zero.
⚠️ O Ridge não realiza seleção de variáveis
Um erro comum: ajustar o Ridge e depois usar os coeficientes não nulos como um subconjunto selecionado de preditores. Todo coeficiente do Ridge é não nulo para qualquer \(\lambda\) finito. Se você precisa saber quais preditores importam, use o Lasso ou o ElasticNet. O Ridge fornece um modelo de previsão, não uma ferramenta de seleção de variáveis.
💡 Regressão Ridge em R
library(glmnet)

# Fit Ridge (alpha=0)
fit_ridge <- glmnet(X, y, alpha=0)
plot(fit_ridge, xvar="lambda", label=TRUE)  # coefficient path

# Select lambda by 10-fold CV
cv_ridge <- cv.glmnet(X, y, alpha=0, nfolds=10)
plot(cv_ridge)
best_lambda <- cv_ridge$lambda.min

# Coefficients and predictions
coef(cv_ridge, s="lambda.min")
predict(cv_ridge, newx=X_new, s="lambda.min")

# Effective degrees of freedom
d <- svd(X)$d
df_lambda <- sum(d^2 / (d^2 + best_lambda))
