Valores de Shapley e SHAP
Os valores de Shapley respondem a uma pergunta aparentemente simples: dada a previsão de um modelo para uma observação específica, o quanto cada atributo contribuiu para essa previsão? Eles vêm da teoria dos jogos cooperativos e têm uma justificativa matemática única: são o único método de atribuição que satisfaz quatro axiomas naturais de justiça simultaneamente. O SHAP torna os valores de Shapley viáveis para modelos de machine learning.
O problema da atribuição
Um modelo prevê que um solicitante de empréstimo tem 78% de probabilidade de inadimplência, em comparação com a previsão média de 35%. A previsão está 43 pontos percentuais acima da média. Quanto desse excesso cada atributo (renda, idade, histórico de crédito, índice de endividamento) explica?
Essa não é uma pergunta trivial. Os atributos interagem: o efeito da renda depende do índice de endividamento. Uma abordagem ingênua que avalia os atributos um por vez perde essas interações. Os valores de Shapley resolvem isso calculando a média sobre todas as ordens possíveis em que os atributos podem ser “introduzidos” no modelo.
Valores de Shapley: a base na teoria dos jogos
Na teoria dos jogos cooperativos, um conjunto de jogadores \(N = \{1, \ldots, p\}\) joga um jogo e recebe um pagamento conjunto \(v(S)\) para cada coalizão \(S \subseteq N\). O valor de Shapley \(\phi_j\) é a parte justa do jogador \(j\):
\[\phi_j = \sum_{S \subseteq N \setminus \{j\}} \frac{|S|!\,(p-|S|-1)!}{p!} \left[v(S \cup \{j\}) - v(S)\right]\]
Para a interpretabilidade de modelos: jogadores = atributos, pagamento = previsão do modelo, \(v(S)\) = saída esperada do modelo quando apenas os atributos em \(S\) são conhecidos (os demais são marginalizados).
A fórmula calcula a média da contribuição marginal do atributo \(j\) sobre todas as ordens possíveis dos atributos: o quanto adicionar \(j\) à coalizão \(S\) muda a previsão?
Os quatro axiomas de justiça
Os valores de Shapley são a única atribuição que satisfaz os quatro simultaneamente:
Eficiência: os valores de Shapley somam a diferença entre a previsão e a linha de base (previsão média):
\[\sum_{j=1}^p \phi_j = f(\mathbf{x}) - E[f(\mathbf{X})]\]
Todo desvio em relação à linha de base é completamente explicado.
Simetria: se dois atributos \(j\) e \(k\) fazem contribuições idênticas a toda coalizão (\(v(S \cup \{j\}) = v(S \cup \{k\})\) para todo \(S\)), eles recebem o mesmo valor de Shapley.
Variável fictícia (dummy): se um atributo \(j\) não muda a previsão em nenhuma coalizão (\(v(S \cup \{j\}) = v(S)\) para todo \(S\)), seu valor de Shapley é zero.
Aditividade: para modelos que se decompõem como \(f = f_1 + f_2\), os valores de Shapley se somam: \(\phi_j(f) = \phi_j(f_1) + \phi_j(f_2)\).
Nenhum outro método de atribuição satisfaz os quatro. Métodos como atribuição baseada em gradiente, LIME, e importância por permutação violam pelo menos um dos axiomas.
SHAP: aproximação eficiente de Shapley
Calcular os valores de Shapley exatos exige avaliar o modelo em todos os \(2^p\) subconjuntos, o que é exponencial. O SHAP (SHapley Additive exPlanations, Lundberg e Lee, 2017) fornece algoritmos eficientes exatos ou aproximados para classes específicas de modelos:
TreeSHAP: valores de Shapley exatos para modelos baseados em árvores (árvores de decisão, random forests, XGBoost, LightGBM) em tempo \(O(TLD^2)\), em que \(T\) é o número de árvores, \(L\) é o número de folhas, e \(D\) é a profundidade da árvore. Isso é polinomial, tornando-o viável para grandes ensembles.
LinearSHAP: valores de Shapley exatos para modelos lineares. Para um modelo linear \(f(\mathbf{x}) = \boldsymbol{\beta}^T\mathbf{x} + \beta_0\), o valor de Shapley do atributo \(j\) é simplesmente \(\phi_j = \beta_j(x_j - E[x_j])\) quando os atributos são independentes.
KernelSHAP: aproximação agnóstica ao modelo usando regressão linear ponderada sobre coalizões amostradas. Funciona para qualquer modelo de caixa-preta, mas é mais lenta.
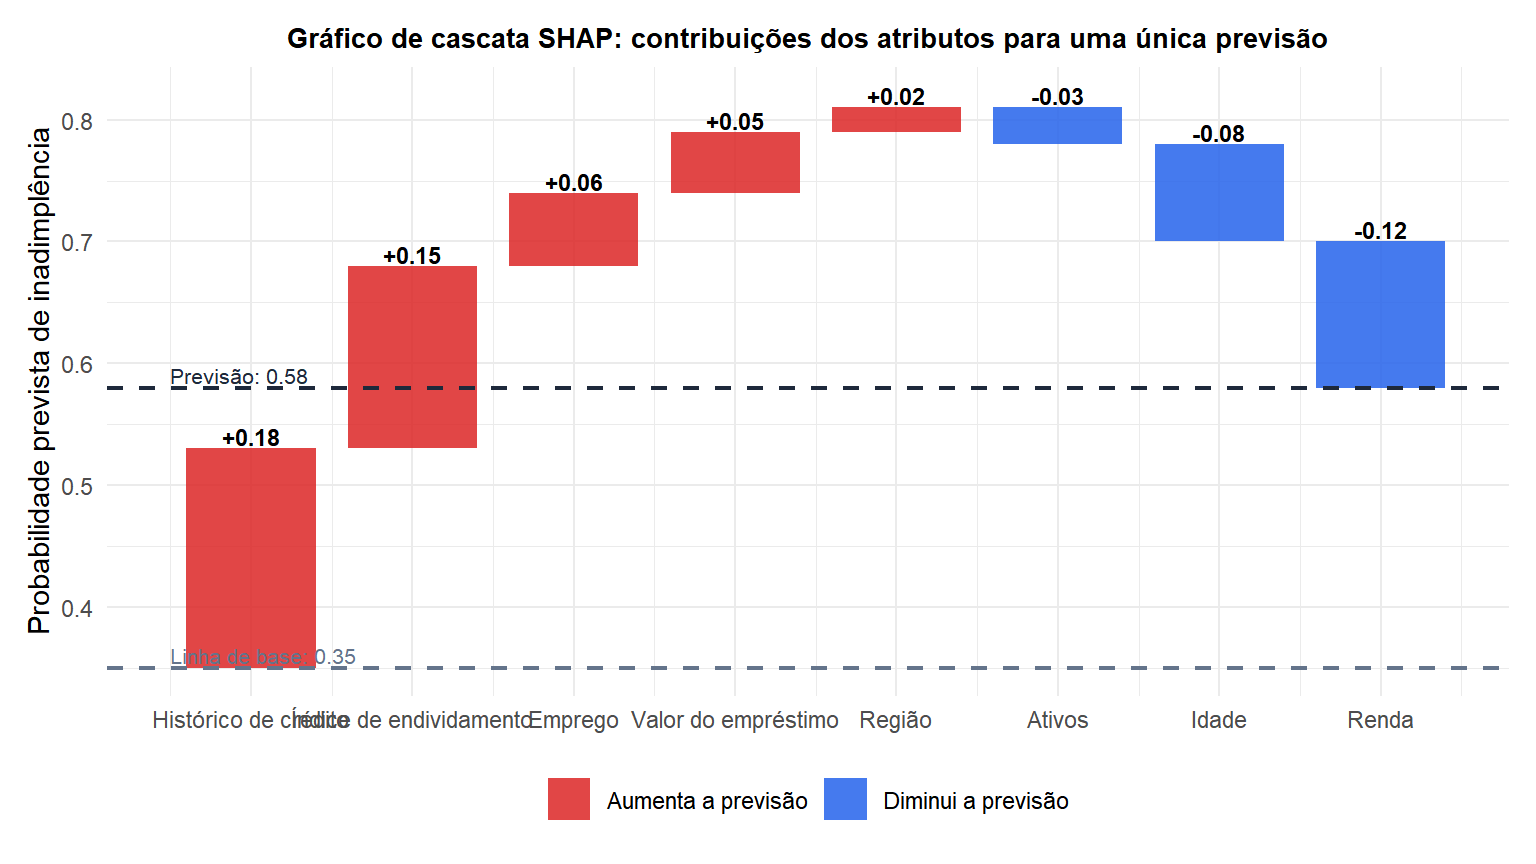
O gráfico de cascata começa na linha de base (previsão média = 0,35) e adiciona sequencialmente o valor SHAP de cada atributo. Barras vermelhas empurram a previsão para cima; barras azuis a empurram para baixo. A previsão final (0,58) é igual à linha de base mais todos os valores SHAP, satisfazendo o axioma de eficiência.
Interpretabilidade global: o gráfico de resumo SHAP
Os valores de Shapley individuais explicam uma previsão. Para entender o modelo globalmente, calcule os valores SHAP para todas as observações e visualize a distribuição.
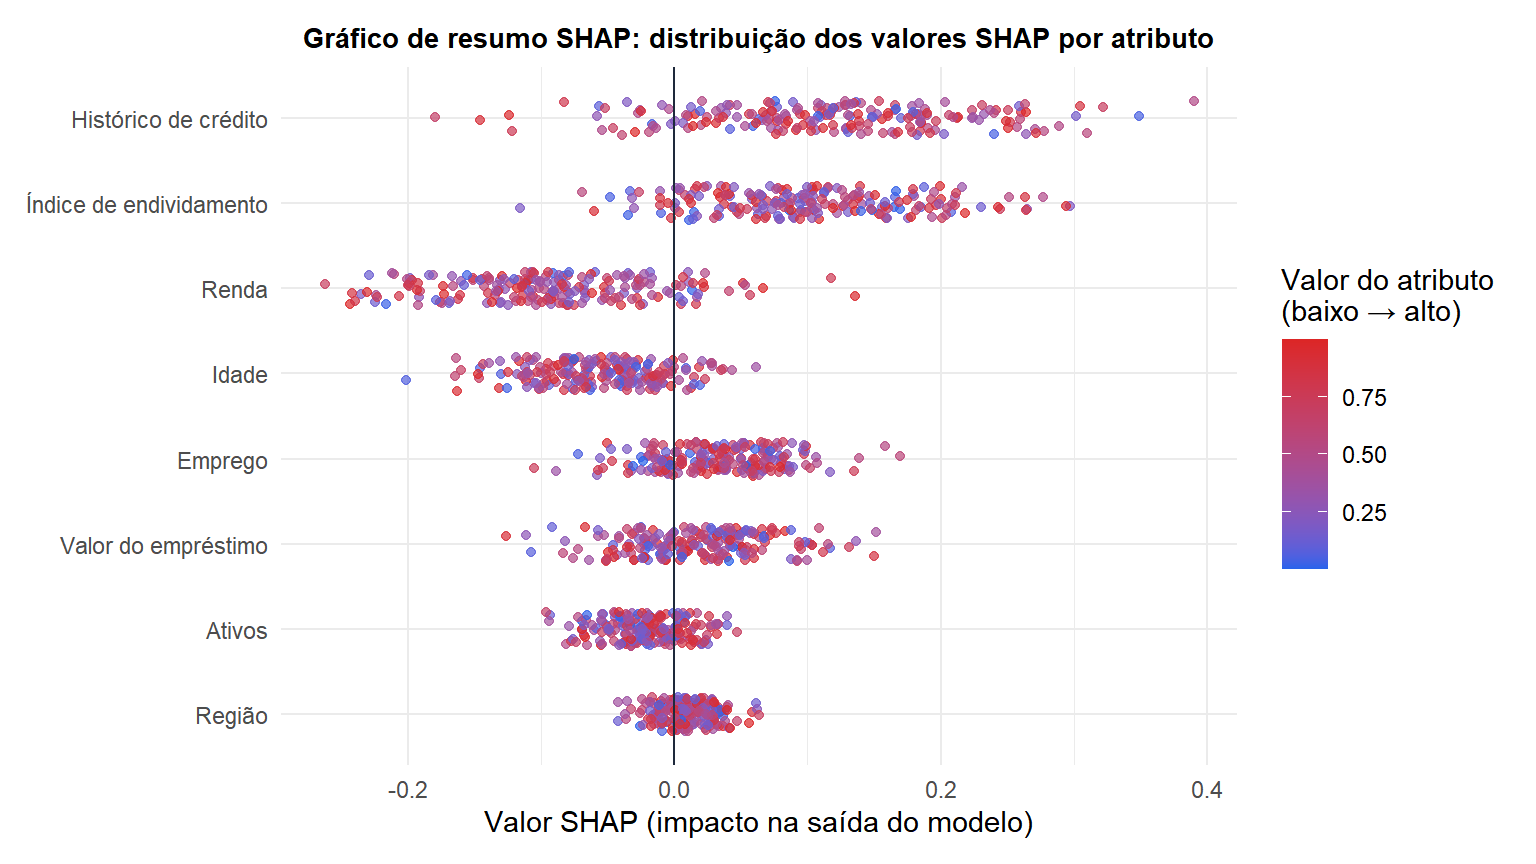
Cada ponto é uma observação. A posição no eixo x mostra o valor SHAP (direção e magnitude do efeito do atributo). A cor mostra o valor do atributo (azul = baixo, vermelho = alto). O gráfico de resumo revela: índice de endividamento alto (vermelho) empurra as previsões para cima; renda alta (vermelho) empurra as previsões para baixo. Os atributos são ordenados pela média do valor absoluto do SHAP (importância global).
SHAP vs importância de atributos tradicional
| Importância por permutação | Importância por impureza | SHAP | |
|---|---|---|---|
| Explica previsões individuais | Não | Não | Sim |
| Consistente com o modelo | Não (pode diferir) | Não | Sim (axioma de eficiência) |
| Trata atributos correlacionados | Mal | Mal | Melhor |
| Mostra a direção do efeito | Não | Não | Sim |
| Computacionalmente caro | Moderado | Rápido | Rápido (TreeSHAP) |
O SHAP supera a importância de atributos tradicional em quase toda dimensão, exceto velocidade (embora o TreeSHAP seja rápido o suficiente para a maioria das aplicações). Para atributos correlacionados, o SHAP distribui o crédito de forma mais justa do que a importância por permutação, que pode atribuir importância zero a um atributo relevante se um atributo correlacionado absorver seu efeito.
⚠️ O SHAP mede associação, não causalidade
Um valor SHAP de +0,18 para “histórico de crédito” significa que conhecer o histórico de crédito deste solicitante empurra a previsão do modelo 18 pontos percentuais acima da linha de base. Não significa que mudar o histórico de crédito mudaria o resultado em 18 pontos percentuais no mundo real.
O SHAP explica o modelo, não o processo gerador de dados. Se o modelo aprendeu uma correlação espúria (por exemplo, CEP como proxy para raça em um conjunto de dados enviesado), o SHAP explicará fielmente essa associação espúria. Ferramentas de interpretabilidade tornam os modelos mais transparentes; elas não corrigem modelos defeituosos.
Além disso: os valores SHAP dependem da distribuição de referência usada para marginalizar os atributos ausentes. Implementações diferentes tratam isso de forma diferente (esperança marginal vs condicional), levando a valores diferentes para o mesmo modelo. Sempre verifique qual linha de base está sendo usada.
💡 SHAP em R
library(shapviz)   # best SHAP visualization in R
library(xgboost)

# Train XGBoost model
dtrain <- xgb.DMatrix(X_train, label=y_train)
fit <- xgb.train(params=list(eta=0.1, max_depth=5,
                              objective="binary:logistic"),
                 data=dtrain, nrounds=100)

# Compute exact SHAP values (TreeSHAP)
shp <- shapviz(fit, X_pred=X_train)

# Waterfall plot for one observation
sv_waterfall(shp, row_id=1)

# Summary (beeswarm) plot
sv_importance(shp, kind="beeswarm")

# Dependence plot: SHAP vs feature value for one feature
sv_dependence(shp, v="income")

# Mean absolute SHAP (global importance bar chart)
sv_importance(shp, kind="bar")

# For any black-box model: KernelSHAP
library(kernelshap)
ks <- kernelshap(fit_rf, X=X_train, bg_X=X_train[1:100,])
sv <- shapviz(ks)
sv_importance(sv, kind="beeswarm")
