Distribuição de Pareto
A distribuição de Pareto modela fenômenos em que uma pequena fração das observações explica a maior parte do efeito total. É o fundamento matemático da regra 80/20 e descreve a riqueza, o tamanho das cidades, as magnitudes de terremotos e o tráfego da internet, em contextos em que eventos extremos são muito mais comuns do que a distribuição normal preveria.
Definição
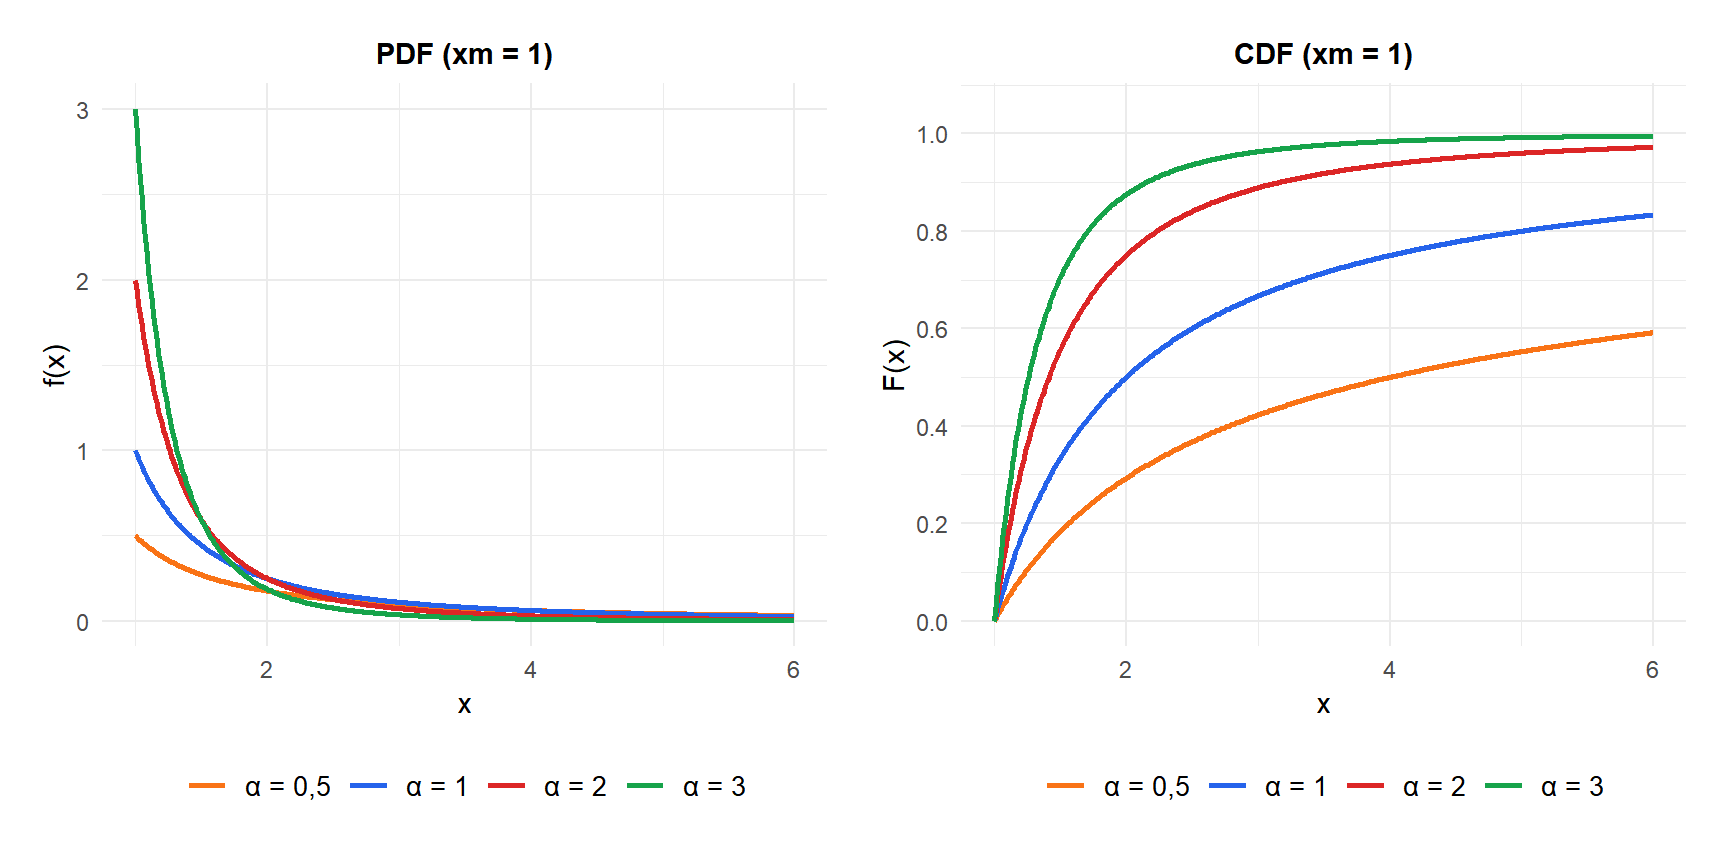
Uma variável aleatória \(X\) segue uma distribuição de Pareto com parâmetro de escala \(x_m > 0\) (valor mínimo possível) e parâmetro de forma \(\alpha > 0\) (índice de cauda), escrita \(X \sim \text{Pareto}(x_m, \alpha)\), se:
\[f(x) = \frac{\alpha\, x_m^\alpha}{x^{\alpha+1}}, \quad x \geq x_m\]
A CDF tem uma forma fechada simples:
\[F(x) = 1 - \left(\frac{x_m}{x}\right)^\alpha, \quad x \geq x_m\]
A função de sobrevivência \(P(X > x) = (x_m/x)^\alpha\) decai como uma lei de potência: reduzir \(\alpha\) à metade eleva ao quadrado a probabilidade de superar qualquer limiar. Isso é o que torna a Pareto de “cauda pesada”: a cauda decai muito mais lentamente do que a exponencial \(e^{-\lambda x}\).
Propriedades
Para \(X \sim \text{Pareto}(x_m, \alpha)\):
- Valor esperado (média)
\[E(X) = \frac{\alpha\, x_m}{\alpha - 1}, \quad \text{apenas definido para } \alpha > 1\]
Para \(\alpha \leq 1\), a média é infinita.
- Variância
\[\text{Var}(X) = \frac{\alpha\, x_m^2}{(\alpha-1)^2(\alpha-2)}, \quad \text{apenas definida para } \alpha > 2\]
Para \(1 < \alpha \leq 2\), a média existe mas a variância é infinita.
- Assimetria
\[\text{Assimetria} = \frac{2(1+\alpha)}{\alpha - 3}\sqrt{\frac{\alpha-2}{\alpha}}, \quad \text{para } \alpha > 3\]
Não definida para \(\alpha \leq 3\). Sempre positiva (assimetria à direita).
- Curtose
\[g_2 = \frac{6(\alpha^3 + \alpha^2 - 6\alpha - 2)}{\alpha(\alpha-3)(\alpha-4)}, \quad \text{para } \alpha > 4\]
- Mediana
\[\text{Mediana} = x_m \cdot 2^{1/\alpha}\]
- Moda
\[\text{Moda} = x_m\]
A distribuição é sempre decrescente: o valor mais provável é o mínimo \(x_m\).
- Função quantil
\[Q(p) = \frac{x_m}{(1-p)^{1/\alpha}}\]
⚠️ A média e a variância podem não existir
A distribuição de Pareto é peculiar porque seus momentos podem não existir:
- \(\alpha \leq 1\): a média é infinita. Médias calculadas a partir de amostras crescerão sem limite à medida que \(n\) aumenta.
- \(1 < \alpha \leq 2\): a média existe, mas a variância é infinita. A variância amostral continuará crescendo com o tamanho da amostra.
- \(\alpha > 2\): tanto a média quanto a variância existem.
Na prática, o \(\alpha\) para distribuições de riqueza é frequentemente estimado em torno de 1,5, o que significa que a riqueza tem média finita mas variância infinita. É por isso que “a riqueza média” pode ser uma estatística enganosa.
A regra 80/20
O princípio de Pareto afirma que aproximadamente 80% dos efeitos vêm de 20% das causas. Isso não é uma lei da natureza, mas uma consequência da distribuição de Pareto quando \(\alpha = \log(5)/\log(4) \approx 1{,}161\).
De forma mais geral, a fração da população \(p\) que representa a fração \(F\) do total (para uma quantidade distribuída segundo Pareto com \(\alpha > 1\)) é:
\[F = 1 - \left(\frac{x_m}{Q(1-p)}\right)^{\alpha-1} = 1 - (1-p)^{(\alpha-1)/\alpha}\]
Para \(\alpha = 1{,}161\) (o expoente de Pareto exato da regra 80/20):
- Os 20% com maior renda detêm 80% da renda total.
- Os 4% com maior renda detêm 64% da renda total (\(0{,}2^2 = 0{,}04\), \(0{,}8^2 = 0{,}64\)).
- O 1% com maior renda detém cerca de 55% da renda total.
Esses números não são coincidências: eles decorrem diretamente da estrutura de lei de potência da distribuição de Pareto.

Exemplo passo a passo
Sinistros de seguros acima de um limite mínimo de 10{.}000 USD seguem uma distribuição de Pareto com \(x_m = 10{.}000\) e \(\alpha = 2{,}5\).
Valor esperado do sinistro:
\[E(X) = \frac{2{,}5 \times 10{.}000}{2{,}5 - 1} = \frac{25{.}000}{1{,}5} \approx 16{.}667 \text{ USD}\]
Probabilidade de um sinistro superar 50{.}000 USD:
\[P(X > 50{.}000) = \left(\frac{10{.}000}{50{.}000}\right)^{2{,}5} = (0{,}2)^{2{,}5} \approx 0{,}0179\]
Cerca de 1,8% dos sinistros superam 50.000 USD.
Percentil 90 (sinistros que apenas 10% das apólices superam):
\[Q(0{,}90) = \frac{10{.}000}{(1-0{,}90)^{1/2{,}5}} = \frac{10{.}000}{0{,}1^{0{,}4}} \approx \frac{10{.}000}{0{,}251} \approx 39{.}800 \text{ USD}\]
Variância:
\[\text{Var}(X) = \frac{2{,}5 \times 10{.}000^2}{(1{,}5)^2 \times (0{,}5)} = \frac{250{.}000{.}000}{1{,}125} \approx 222{.}222{.}222 \text{ USD}^2\]
Desvio padrão \(\approx 14{.}907\) USD, quase tão grande quanto a média.
⚠️ Caudas de lei de potência vs caudas exponenciais
A diferença fundamental entre a distribuição de Pareto e distribuições como a exponencial ou a normal é a velocidade com que a cauda decai:
- Cauda exponencial: \(P(X > x) = e^{-\lambda x}\). Decai extremamente rápido. Dobrar \(x\) eleva ao quadrado a probabilidade da cauda apenas de forma aproximada.
- Cauda de lei de potência: \(P(X > x) = (x_m/x)^\alpha\). Decai lentamente. Um terremoto 10 vezes maior é apenas \(10^\alpha\) vezes mais raro, não exponencialmente mais raro.
É por isso que inundações centenárias, perdas de seguros de bilhões de dólares e publicações virais em redes sociais existem: modelos de cauda exponencial os preveriam como essencialmente impossíveis, mas modelos de lei de potência atribuem a eles uma probabilidade não negligenciável.
💡 Relação com outras distribuições
- Exponencial: a Pareto é o análogo contínuo da geométrica no sentido da ausência de memória, mas com cauda de lei de potência em vez de exponencial.
- Lomax (Pareto tipo II): \(Y = X - x_m\) em que \(X \sim \text{Pareto}(x_m, \alpha)\) dá uma distribuição Lomax que começa em 0.
- Log-uniforme: se \(\ln(X)\) é uniforme em \((\ln x_m, \infty)\), \(X\) é Pareto.
- Pareto generalizada: usada na teoria de valores extremos para modelar excedências acima de um limiar, generalizando a Pareto padrão.

