Distribuição t de Student
A distribuição t de Student é a que você usa quando quer fazer inferência sobre a média populacional, mas não conhece a variância populacional. Tem caudas mais pesadas do que a normal e converge para ela à medida que o tamanho amostral cresce, o que a torna a ferramenta padrão para testes t e intervalos de confiança.
Definição
Se \(Z \sim N(0,1)\) e \(V \sim \chi^2(\nu)\) são independentes, então:
\[T = \frac{Z}{\sqrt{V/\nu}} \sim t(\nu)\]
\(T\) segue uma distribuição t de Student com \(\nu\) graus de liberdade. Sua PDF é:
\[f(x) = \frac{\Gamma\!\left(\frac{\nu+1}{2}\right)}{\sqrt{\nu\pi}\;\Gamma\!\left(\frac{\nu}{2}\right)} \left(1 + \frac{x^2}{\nu}\right)^{-(\nu+1)/2}, \quad -\infty < x < \infty\]
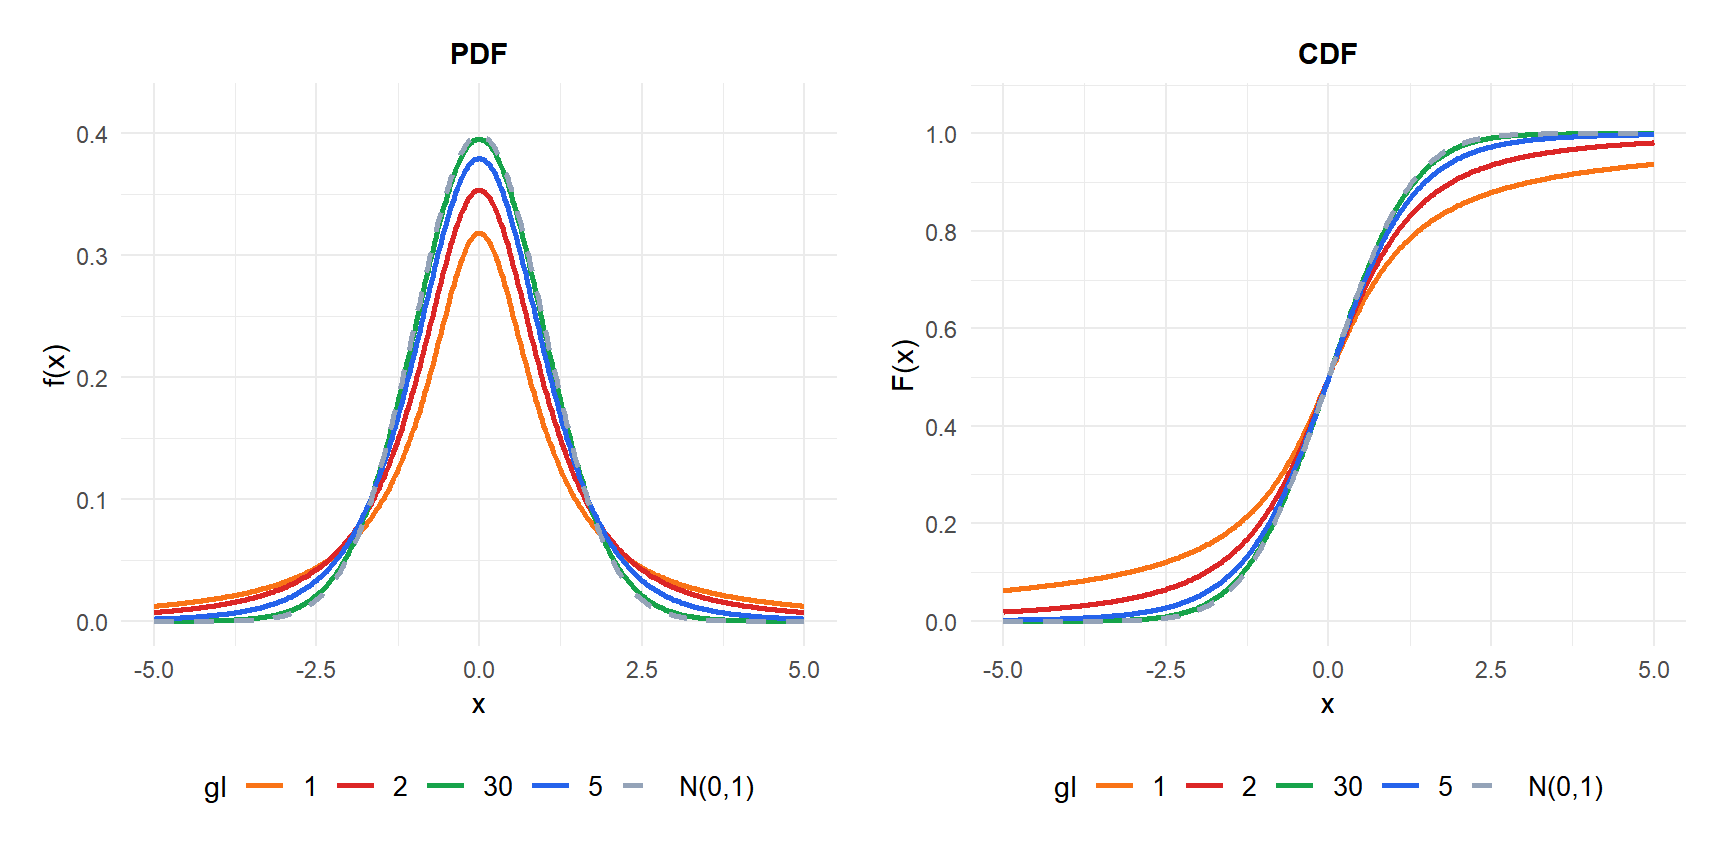
A distribuição é simétrica em torno de zero e tem forma de sino como a normal, mas com caudas mais pesadas. Quando \(\nu \to \infty\), \(t(\nu) \to N(0,1)\).
⚠️ Quem é Student?
“Student” foi o pseudônimo de William Sealy Gosset, um estatístico que trabalhava na cervejaria Guinness em Dublin no início dos anos 1900. A Guinness não permitia que seus funcionários publicassem pesquisas, então Gosset publicou sob o pseudônimo “Student” em 1908. Ele desenvolveu a distribuição para lidar com pequenas amostras de cevada e lúpulo, o que a torna uma das origens mais práticas de um resultado estatístico fundamental.
Efeito dos graus de liberdade
Os graus de liberdade \(\nu\) controlam o quão pesadas são as caudas:
- \(\nu\) pequeno: caudas muito pesadas. Valores extremos são muito mais prováveis do que sob a normal. Com \(\nu = 1\), a distribuição é uma Cauchy, que não tem média.
- \(\nu \geq 30\): praticamente indistinguível de \(N(0,1)\) para a maioria dos propósitos.
- \(\nu \to \infty\): converge exatamente para \(N(0,1)\).
Propriedades
Para \(T \sim t(\nu)\):
- Valor esperado (média)
\[E(T) = 0, \quad \text{para } \nu > 1\]
Indefinido para \(\nu = 1\) (distribuição de Cauchy).
- Variância
\[\text{Var}(T) = \frac{\nu}{\nu - 2}, \quad \text{para } \nu > 2\]
Indefinida para \(\nu \leq 2\). Sempre maior que 1, aproximando-se de 1 quando \(\nu \to \infty\).
- Assimetria
Sempre 0: a distribuição é perfeitamente simétrica em torno de 0, para \(\nu > 3\).
- Curtose
\[g_2 = \frac{6}{\nu - 4}, \quad \text{para } \nu > 4\]
Sempre positiva (leptocúrtica). Aproxima-se de 0 quando \(\nu \to \infty\).
- Moda e mediana
Ambas iguais a 0 por simetria.
- Função quantil
Não tem forma fechada; os valores são lidos em tabelas t ou calculados com software. Valores-chave de \(t_{0{,}975,\, \nu}\) (IC bilateral de 95%):
| \(\nu\) | \(t_{0{,}975}\) |
|---|---|
| 5 | 2,571 |
| 10 | 2,228 |
| 20 | 2,086 |
| 30 | 2,042 |
| \(\infty\) | 1,960 |
À medida que \(\nu\) cresce, o valor crítico se aproxima de 1,960, o quantil da normal padrão.
Por que usar t em vez de z?
Ao testar uma hipótese sobre a média populacional \(\mu\), a estatística natural é:
\[Z = \frac{\bar{X} - \mu}{\sigma / \sqrt{n}}\]
Essa estatística segue exatamente \(N(0,1)\). O problema: \(\sigma\) quase nunca é conhecida. Substituí-la pelo desvio padrão amostral \(S\) dá:
\[T = \frac{\bar{X} - \mu}{S / \sqrt{n}} \sim t(n-1)\]
Essa estatística segue uma distribuição t porque \(S\) introduz variabilidade adicional. A distribuição t tem caudas mais pesadas do que a normal para compensar a incerteza extra de estimar \(\sigma\).
⚠️ Quando você pode usar z em vez de t?
Na prática, muitos livros dizem “use z quando \(n \geq 30\) e \(\sigma\) é conhecida, use t caso contrário”. A regra real é mais simples: use sempre t quando \(\sigma\) for desconhecida, independentemente do tamanho amostral. Para \(n\) grande, t e z dão resultados quase idênticos, então usar t nunca está errado.
O único caso em que z é estritamente correto e t é uma aproximação é quando \(\sigma\) é verdadeiramente conhecida, o que é raro fora de experimentos controlados.
Aplicações
Teste t de uma amostra e intervalo de confiança
Para testar \(H_0: \mu = \mu_0\) ou construir um IC para \(\mu\):
\[T = \frac{\bar{X} - \mu_0}{S/\sqrt{n}} \sim t(n-1)\]
Um intervalo de confiança \((1-\alpha)\) para \(\mu\):
\[\bar{X} \pm t_{\alpha/2,\, n-1} \cdot \frac{S}{\sqrt{n}}\]
Uma empresa de alimentos afirma que suas embalagens pesam 500 g em média. Um auditor de qualidade pesa 12 embalagens e obtém \(\bar{X} = 494\) g e \(S = 8\) g.
Teste \(H_0: \mu = 500\) contra \(H_1: \mu \neq 500\) com \(\alpha = 0{,}05\).
\[T = \frac{494 - 500}{8/\sqrt{12}} = \frac{-6}{2{,}309} \approx -2{,}60\]
Valor crítico: \(t_{0{,}025,\, 11} \approx 2{,}201\).
Como \(|{-2{,}60}| > 2{,}201\), rejeitamos \(H_0\). Há evidência significativa de que as embalagens pesam menos do que o declarado.
IC de 95%: \(494 \pm 2{,}201 \times 2{,}309 = 494 \pm 5{,}08 = (488{,}9,\ 499{,}1)\) g.

Teste t de duas amostras
Para comparar as médias de dois grupos independentes com variâncias iguais:
\[T = \frac{\bar{X}_1 - \bar{X}_2}{S_p\sqrt{1/n_1 + 1/n_2}} \sim t(n_1 + n_2 - 2)\]
em que \(S_p^2 = \frac{(n_1-1)S_1^2 + (n_2-1)S_2^2}{n_1+n_2-2}\) é a variância combinada.
Para variâncias desiguais, o teste t de Welch usa graus de liberdade modificados (aproximação de Satterthwaite).
⚠️ Sempre verifique a suposição de variâncias iguais
O teste t de duas amostras combinado assume variâncias iguais. Se as variâncias diferem substancialmente, use o teste t de Welch: ele não assume variâncias iguais e geralmente é recomendado como padrão. No R, t.test() usa Welch por padrão; adicione var.equal = TRUE para a versão combinada.
Teste t pareado
Quando as observações vêm em pares (antes/depois, sujeitos pareados), calcule as diferenças \(D_i = X_{i1} - X_{i2}\) e aplique um teste t de uma amostra a \(D_i\).
Oito funcionários fazem um teste de velocidade de digitação antes e depois de um programa de treinamento. As diferenças (depois menos antes, em palavras por minuto) são:
\[d = (5, 8, -2, 12, 6, 3, 9, 4)\]
\(\bar{d} = 5{,}625\), \(S_d \approx 4{,}24\), \(n = 8\).
\[T = \frac{5{,}625}{4{,}24/\sqrt{8}} = \frac{5{,}625}{1{,}499} \approx 3{,}75\]
Valor crítico: \(t_{0{,}025,\, 7} \approx 2{,}365\).
Como \(3{,}75 > 2{,}365\), rejeitamos \(H_0\): o treinamento melhorou significativamente a velocidade de digitação (\(p \approx 0{,}007\)).
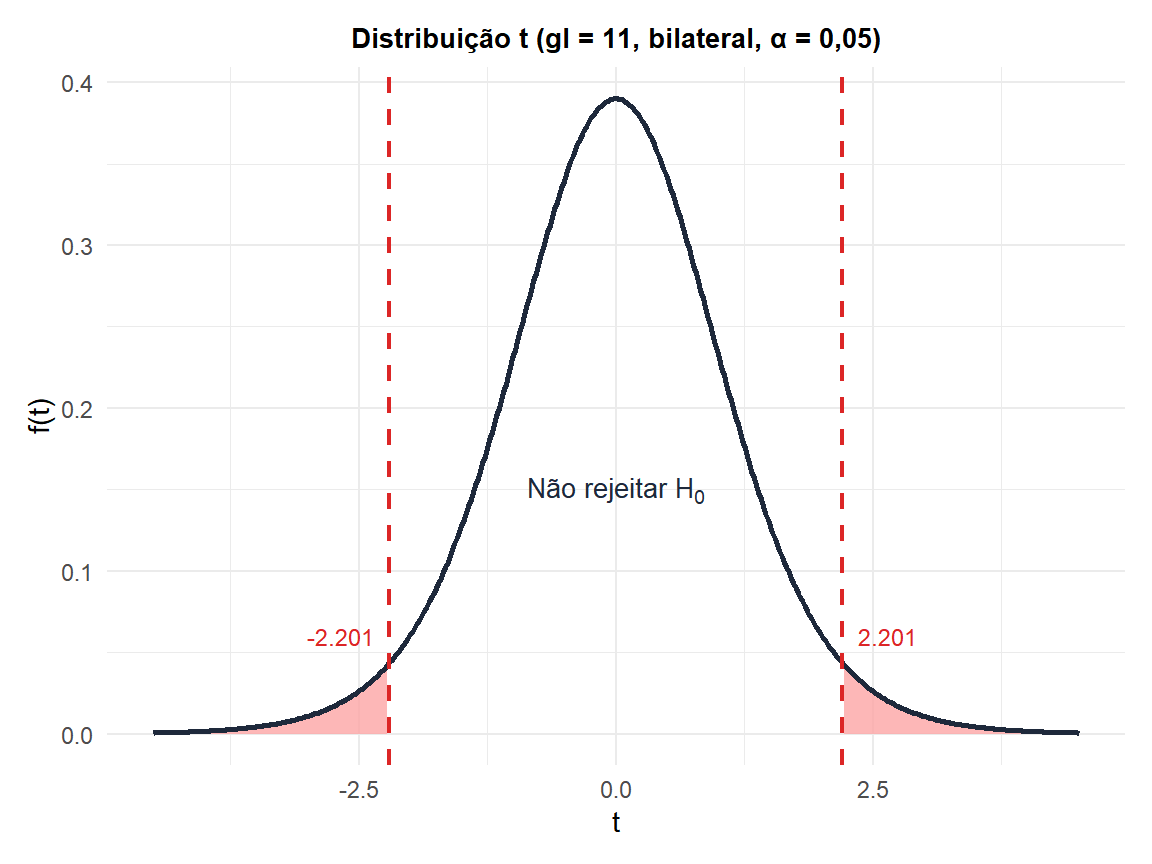
Figure 1: Teste t bilateral com 11 graus de liberdade a α=0,05: regiões de rejeição em vermelho
💡 Relação com outras distribuições
- Normal: \(t(\infty) = N(0,1)\). Quando \(\nu \to \infty\), a t converge para a normal padrão.
- Cauchy: \(t(1) = \text{Cauchy}(0,1)\). Sem média, sem variância.
- Qui-quadrado: \(T^2 \sim F(1, \nu)\), em que \(F\) é a distribuição F. Elevar ao quadrado uma estatística t dá uma estatística F.
- Distribuição F: \(t(\nu)^2 = F(1, \nu)\).
- Beta: \(T^2/(\nu + T^2) \sim \text{Beta}(1/2,\, \nu/2)\).

