Cálculo do tamanho da amostra
O cálculo do tamanho da amostra é o passo que determina quantas observações você precisa para estimar um parâmetro com o nível de precisão e confiança desejado. Uma amostra pequena demais dá um intervalo amplo demais para ser útil; uma grande demais desperdiça recursos. O objetivo é encontrar o menor \(n\) que atenda às suas exigências.
Princípio geral
Um intervalo de confiança tem a forma:
\[\text{estimativa} \pm \underbrace{z_{\alpha/2} \cdot \text{EP}}_{\text{margem de erro } d}\]
A margem de erro \(d\) diminui conforme \(n\) cresce (já que \(\text{EP} \propto 1/\sqrt{n}\)). Para alcançar uma margem de erro desejada \(d\), resolve-se para \(n\). O tamanho de amostra necessário sempre depende de três coisas:
- O nível de confiança \((1-\alpha)\): mais confiança exige \(n\) maior.
- A margem de erro \(d\): um \(d\) menor exige \(n\) maior.
- A variabilidade populacional (\(\sigma\) ou \(p\)): populações mais variáveis exigem \(n\) maior.
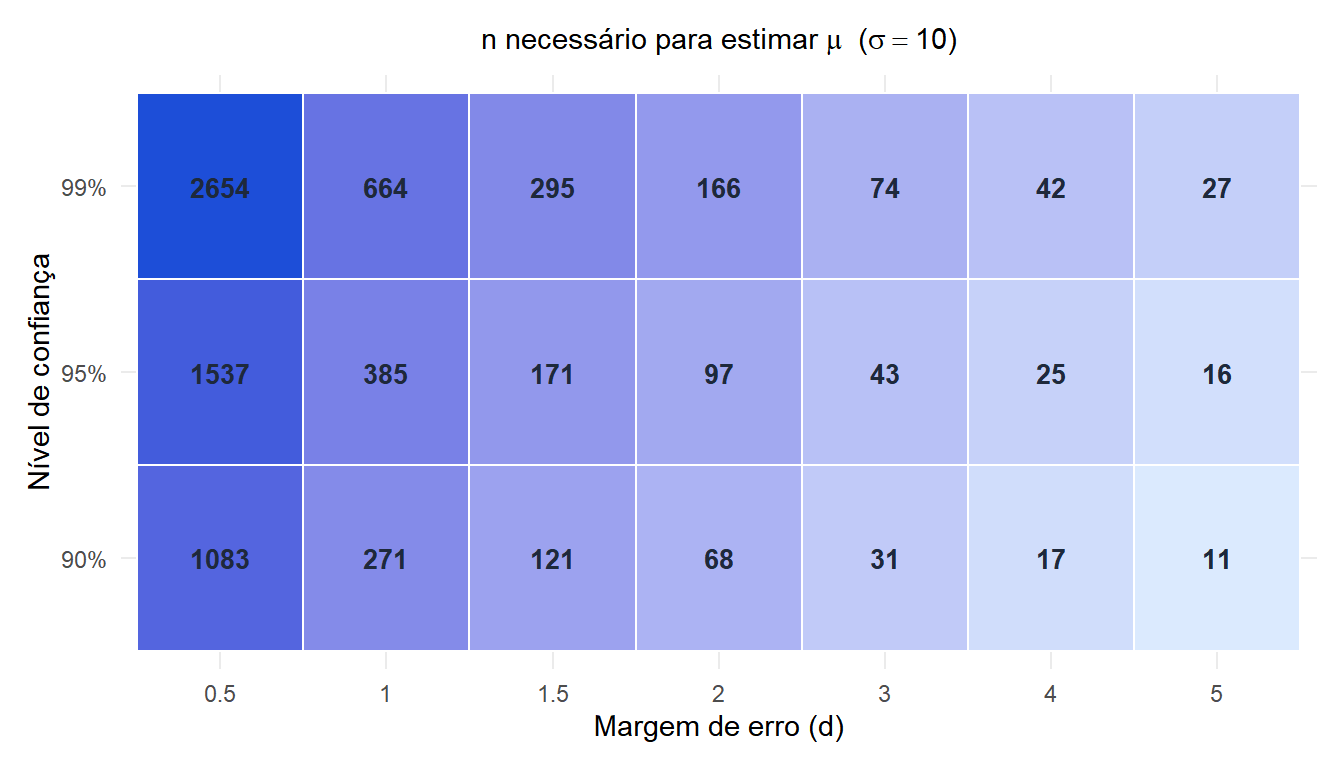
O mapa de calor mostra que margens de erro pequenas com níveis de confiança altos exigem amostras muito grandes. Reduzir a margem de erro à metade quadruplica o \(n\) necessário.
Tamanho de amostra para estimar uma média
Para estimar \(\mu\) com margem de erro \(d\) no nível de confiança \(1-\alpha\), quando \(\sigma\) é conhecido:
\[n \geq \left(\frac{z_{\alpha/2} \cdot \sigma}{d}\right)^2\]
Quando \(\sigma\) é desconhecido, substitua-o por uma estimativa piloto \(S\) e use \(t_{\alpha/2, n-1}\) em vez de \(z_{\alpha/2}\). Como \(t\) depende de \(n\), itere: comece com \(z\), calcule \(n\), depois verifique com \(t_{n-1}\) e ajuste se necessário.
Valores comuns de \(z_{\alpha/2}\):
| Nível de confiança | \(z_{\alpha/2}\) |
|---|---|
| 90% | 1,645 |
| 95% | 1,960 |
| 99% | 2,576 |
Um hospital quer estimar o tempo médio de internação para um grupo de diagnóstico com precisão de \(\pm 0{,}5\) dias a 95% de confiança. De um estudo piloto, \(S \approx 3{,}1\) dias.
\[n \geq \left(\frac{1{,}960 \times 3{,}1}{0{,}5}\right)^2 = \left(\frac{6{,}076}{0{,}5}\right)^2 = 12{,}152^2 \approx 147{,}7 \to 148\]
São necessários pelo menos 148 pacientes. Se o orçamento só permitir 50 pacientes, a margem de erro alcançável seria:
\[d = 1{,}960 \times \frac{3{,}1}{\sqrt{50}} \approx 0{,}86 \text{ dias}\]
O hospital precisa decidir se uma margem de \(\pm 0{,}86\) dias é aceitável.

Tamanho de amostra para estimar uma proporção
Para estimar \(p\) com margem de erro \(d\):
\[n \geq \frac{z_{\alpha/2}^2 \cdot p(1-p)}{d^2}\]
Como \(p\) é desconhecido, use uma estimativa prévia se disponível. Se não houver, use \(p = 0{,}5\), que maximiza \(p(1-p) = 0{,}25\) e dá o tamanho de amostra mais conservador (maior).
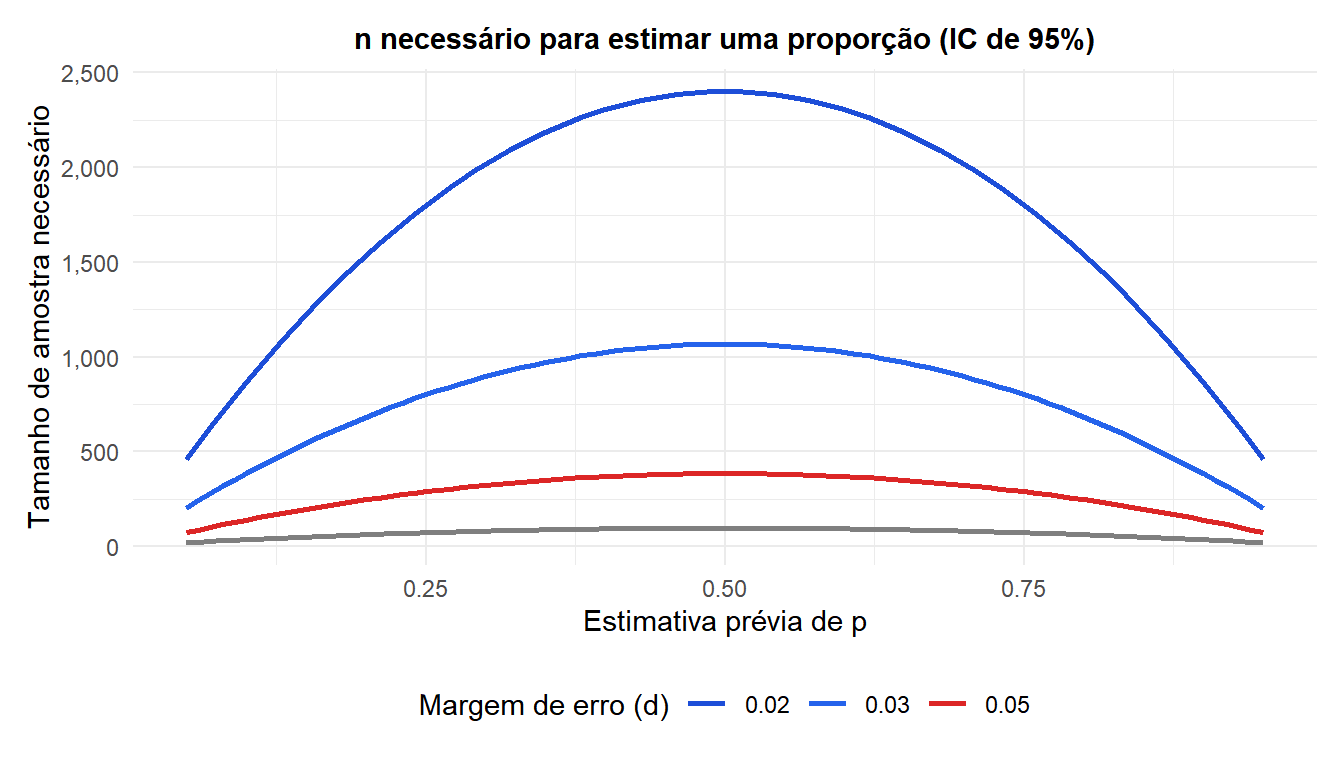
O gráfico mostra que o \(n\) máximo necessário sempre ocorre em \(p = 0{,}5\), e que reduzir \(d\) de 5% para 2% aproximadamente quadruplica o tamanho de amostra necessário.
Uma fábrica quer estimar sua taxa de defeitos com precisão de \(\pm 2\%\) a 95% de confiança. Uma auditoria anterior encontrou uma taxa de defeitos de cerca de 8%.
Usando a estimativa prévia \(p = 0{,}08\):
\[n \geq \frac{1{,}960^2 \times 0{,}08 \times 0{,}92}{0{,}02^2} = \frac{3{,}842 \times 0{,}0736}{0{,}0004} = \frac{0{,}2828}{0{,}0004} \approx 707\]
Usando o valor conservador \(p = 0{,}5\):
\[n \geq \frac{1{,}960^2 \times 0{,}25}{0{,}02^2} = \frac{0{,}9604}{0{,}0004} = 2.401\]
A estimativa prévia economiza 1.694 inspeções. Quando \(p\) está longe de 0,5, usar informação prévia é eficiente.
Tamanho de amostra para comparar duas médias
Para detectar uma diferença de \(\delta = \mu_1 - \mu_2\) com margem de erro \(d\) no nível de confiança \(1-\alpha\), assumindo tamanhos de amostra iguais \(n_1 = n_2 = n\) e variâncias iguais \(\sigma^2\):
\[n \geq 2\left(\frac{z_{\alpha/2} \cdot \sigma}{d}\right)^2\]
Para um teste de hipóteses que detecte uma diferença \(\delta\) com poder \(1-\beta\):
\[n \geq \frac{2\sigma^2(z_{\alpha/2} + z_\beta)^2}{\delta^2}\]
em que \(z_\beta\) é o quantil da normal padrão para o poder desejado (por exemplo, \(z_{0{,}80} = 0{,}842\) para 80% de poder, \(z_{0{,}90} = 1{,}282\) para 90% de poder).
Um ensaio compara a redução da pressão arterial entre dois medicamentos. De dados prévios, \(\sigma \approx 12\) mmHg. A diferença clinicamente relevante é \(\delta = 5\) mmHg. Planeje o ensaio com 95% de confiança e 80% de poder.
\[n \geq \frac{2 \times 144 \times (1{,}960 + 0{,}842)^2}{25} = \frac{288 \times 7{,}852}{25} = \frac{2.261}{25} \approx 91\]
Cada grupo precisa de pelo menos 91 pacientes (182 no total). Para 90% de poder:
\[n \geq \frac{2 \times 144 \times (1{,}960 + 1{,}282)^2}{25} = \frac{288 \times 10{,}511}{25} \approx 121 \text{ por grupo}\]
Passar de 80% para 90% de poder aumenta a amostra total de 182 para 242.
Considerações práticas
Todas as fórmulas acima calculam um mínimo teórico em condições ideais. Estudos reais precisam inflar esse número por alguns motivos previsíveis e recorrentes.
⚠️ O n calculado é um mínimo, não uma meta
A fórmula dá o \(n\) mínimo em condições ideais. Na prática, sempre infle esse valor para considerar:
- Abandono e não resposta: se você espera 15% de abandono, divida por 0,85. Um estudo que precisa de 148 observações completas exige recrutar \(148/0{,}85 \approx 175\) participantes.
- Comparações múltiplas: se você testa várias hipóteses, o \(\alpha\) efetivo por teste é menor, exigindo \(n\) maior.
- Amostragem por clusters: observações dentro de clusters são correlacionadas. Multiplique \(n\) pelo efeito de delineamento \(\text{DEFF} = 1 + (m-1)\rho\), em que \(m\) é o tamanho do cluster e \(\rho\) é a correlação intraclasse.
- Análises de subgrupos: se você precisa estimar parâmetros dentro de subgrupos, cada subgrupo precisa do seu próprio \(n\) mínimo.
Uma boa regra prática: calcule o \(n\) mínimo, adicione 20% como margem de segurança e depois revise a viabilidade.
💡 O que fazer quando o n necessário é muito grande
Se o tamanho de amostra calculado excede seu orçamento ou cronograma:
- Aumente \(d\): aceite uma margem de erro maior. Dobrar \(d\) divide \(n\) por quatro.
- Reduza o nível de confiança: ir de 99% para 95% reduz \(n\) em cerca de 30%.
- Use uma estimativa prévia melhor de \(p\) ou \(\sigma\): um estudo piloto para estimar a variabilidade pode reduzir substancialmente o \(n\) necessário.
- Use um teste unilateral: se só uma direção importa, \(z_{\alpha}\) em vez de \(z_{\alpha/2}\) reduz \(n\).
- Aceite menor poder: reduzir o poder de 90% para 80% economiza aproximadamente 25% das observações em um teste de duas amostras.
Documente explicitamente qualquer compromisso: revisores e órgãos reguladores vão perguntar.

