Estimação da média populacional
A média amostral \(\bar{X}\) é o estimador pontual padrão para a média populacional \(\mu\). Entender suas propriedades, sua distribuição amostral e seu erro padrão é a base de qualquer inferência sobre médias.
O estimador: média amostral
Dada uma amostra aleatória \(x_1, x_2, \ldots, x_n\) de uma população com média \(\mu\) e variância \(\sigma^2\), o estimador natural para \(\mu\) é a média amostral:
\[\bar{X} = \frac{1}{n} \sum_{i=1}^{n} X_i\]
A média amostral tem três propriedades-chave que a tornam a escolha padrão:
- Não tendenciosa: \(E[\bar{X}] = \mu\). Em média, considerando todas as amostras possíveis, \(\bar{X}\) acerta o alvo.
- Consistente: conforme \(n\) aumenta, \(\bar{X}\) converge para \(\mu\).
- Eficiente: entre todos os estimadores não tendenciosos, \(\bar{X}\) tem a menor variância quando a população é normal (ela atinge o limite de Cramér-Rao).
Distribuição amostral da média
Antes de coletar os dados, \(\bar{X}\) é uma variável aleatória. Sua distribuição entre todas as amostras possíveis de tamanho \(n\) é a distribuição amostral da média:
\[\bar{X} \sim N\!\left(\mu,\ \frac{\sigma}{\sqrt{n}}\right) \quad \text{exatamente, se a população é normal}\]
Pelo Teorema Central do Limite (TCL), essa aproximação vale para qualquer população com variância finita quando \(n\) é suficientemente grande (costuma-se usar \(n \geq 30\) como regra prática, embora o \(n\) necessário dependa da forma da população).
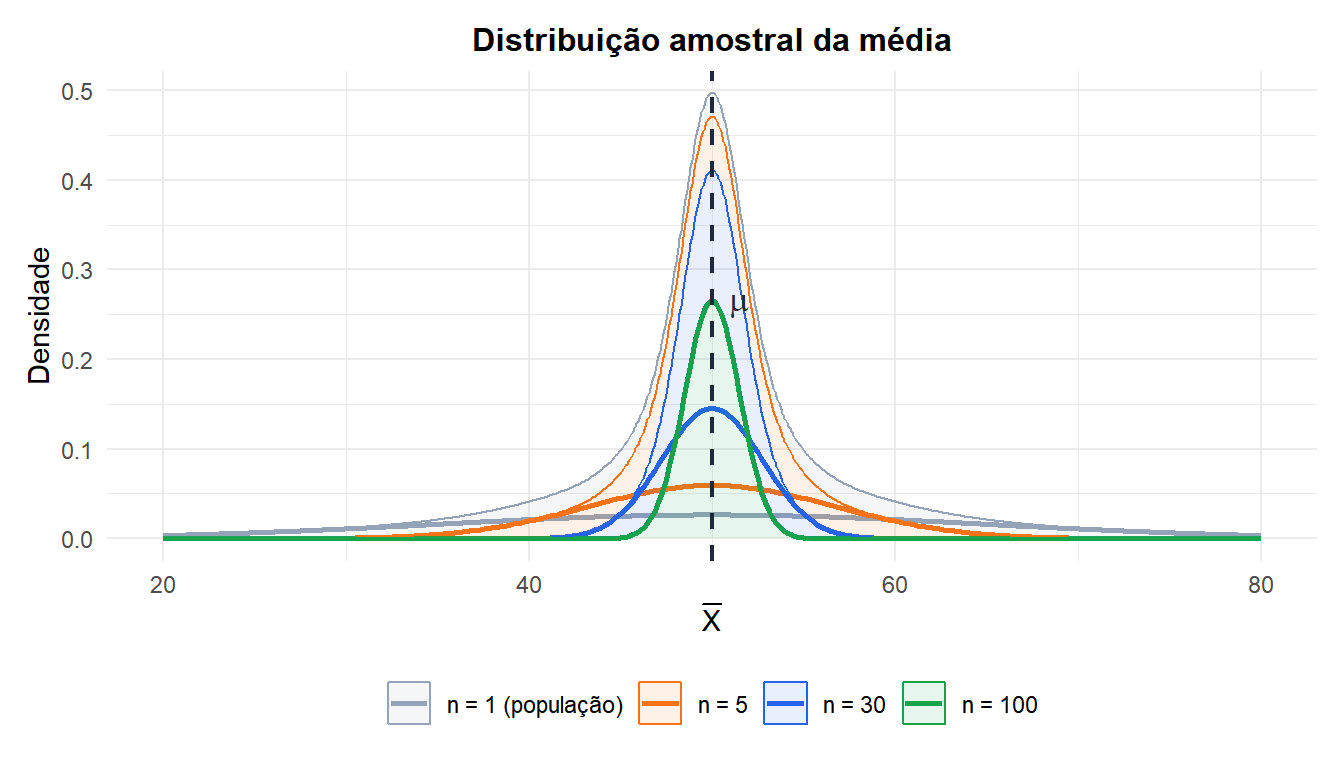
Figure 1: Conforme n aumenta, a distribuição amostral da média se torna mais estreita e mais simétrica, independentemente da distribuição da população
Erro padrão da média
A dispersão da distribuição amostral é medida pelo erro padrão (EP):
\[\text{EP}(\bar{X}) = \frac{\sigma}{\sqrt{n}}\]
O EP indica quanto se espera que \(\bar{X}\) varie de amostra para amostra. Ele diminui conforme \(n\) aumenta: dobrar o tamanho da amostra reduz o erro padrão à metade (são necessários quatro vezes mais dados para reduzi-lo à metade).
Na prática, \(\sigma\) é desconhecido e é estimado pelo desvio padrão amostral \(S\):
\[\widehat{\text{EP}}(\bar{X}) = \frac{S}{\sqrt{n}}\]
⚠️ Erro padrão não é o mesmo que desvio padrão
- Desvio padrão (\(S\)): mede a dispersão das observações individuais em torno da média amostral. Descreve a variabilidade dos dados.
- Erro padrão (\(\widehat{\text{EP}}\)): mede a dispersão da média amostral entre diferentes amostras. Descreve a precisão da estimativa.
Um conjunto de dados grande pode ter um \(S\) grande (os dados estão muito dispersos) e um \(\widehat{\text{EP}}\) muito pequeno (a média é estimada com precisão). Eles respondem a perguntas diferentes.
Exemplo passo a passo
Um hospital registra o tempo de internação (em dias) de uma amostra aleatória de 40 pacientes admitidos com um diagnóstico específico. Os resultados são: \(\bar{x} = 6{,}4\) dias, \(S = 3{,}1\) dias.
Estimativa pontual da média populacional:
\[\hat{\mu} = \bar{x} = 6{,}4 \text{ dias}\]
Erro padrão estimado:
\[\widehat{\text{EP}} = \frac{S}{\sqrt{n}} = \frac{3{,}1}{\sqrt{40}} = \frac{3{,}1}{6{,}32} \approx 0{,}49 \text{ dias}\]
Interpretação: a melhor estimativa única do tempo médio de internação para todos os pacientes com esse diagnóstico é 6,4 dias. O erro padrão de 0,49 dias nos diz que, se repetíssemos este estudo muitas vezes, a média amostral tipicamente ficaria a cerca de 0,49 dias da verdadeira média.
Mesma população (\(\mu = 6{,}4\), \(S = 3{,}1\)), tamanhos de amostra diferentes:
| \(n\) | \(\widehat{\text{EP}} = S/\sqrt{n}\) | Interpretação |
|---|---|---|
| 10 | \(3{,}1/\sqrt{10} \approx 0{,}98\) | Média conhecida com precisão de ~1 dia |
| 40 | \(3{,}1/\sqrt{40} \approx 0{,}49\) | Média conhecida com precisão de ~0,5 dias |
| 160 | \(3{,}1/\sqrt{160} \approx 0{,}25\) | Média conhecida com precisão de ~0,25 dias |
| 640 | \(3{,}1/\sqrt{640} \approx 0{,}12\) | Média conhecida com precisão de ~0,12 dias |
Cada vez que \(n\) é multiplicado por quatro, o erro padrão cai à metade. A precisão melhora com mais dados, mas com retornos decrescentes.

Por que a média amostral funciona: o TCL
O Teorema Central do Limite garante que \(\bar{X}\) segue aproximadamente uma distribuição normal para \(n\) grande, independentemente da forma da população. É isso que torna a média amostral universalmente útil:
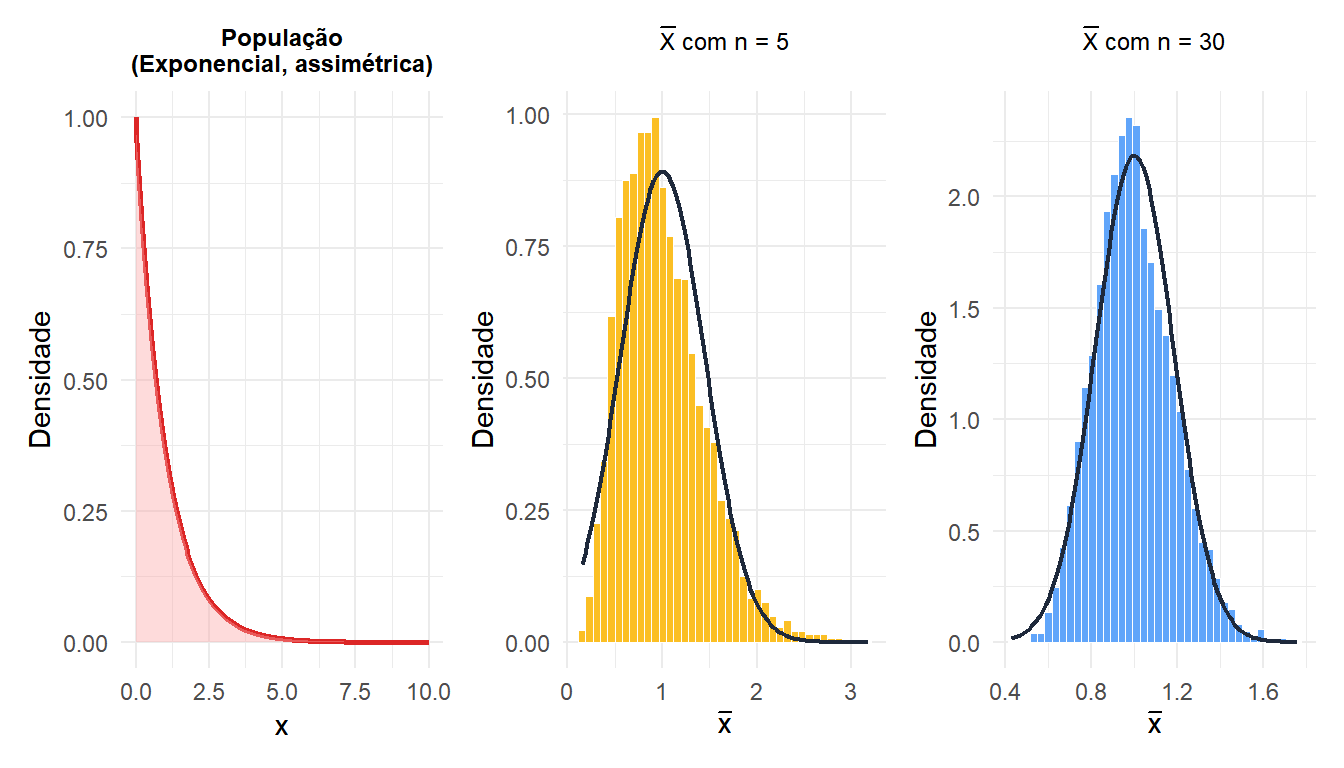
Figure 2: Médias de amostras de uma população exponencial fortemente assimétrica convergem para a normalidade conforme n aumenta
Mesmo partindo de uma distribuição exponencial fortemente assimétrica, a distribuição amostral de \(\bar{X}\) já é aproximadamente normal com \(n = 30\).
💡 Quando usar z vs. t para inferência sobre a média
A escolha depende do que é conhecido:
- \(\sigma\) conhecido: use a normal padrão \(Z = (\bar{X} - \mu)/(\sigma/\sqrt{n})\). Raro na prática.
- \(\sigma\) desconhecido, \(n\) grande: a distribuição \(t\) com \(n-1\) graus de liberdade. Para \(n \geq 30\) ela é praticamente indistinguível da normal.
- \(\sigma\) desconhecido, \(n\) pequeno: a distribuição \(t\) é essencial. Ela tem caudas mais pesadas para dar conta da incerteza adicional de estimar \(\sigma\).
Na prática: use sempre \(t\) quando \(\sigma\) for desconhecido. Para \(n\) grande, \(t\) e \(z\) dão o mesmo resultado de qualquer forma.

