Estimação da variância populacional
A variância amostral \(S^2\) é o estimador pontual padrão para a variância populacional \(\sigma^2\). Sua característica principal é a divisão por \(n-1\) em vez de \(n\), que corrige um viés sistemático que surge ao estimar a média com os mesmos dados.
O estimador: variância amostral
Dada uma amostra \(x_1, x_2, \ldots, x_n\) com média amostral \(\bar{x}\), a variância amostral é:
\[S^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2\]
Esse é um estimador não tendencioso de \(\sigma^2\): \(E[S^2] = \sigma^2\).
O estimador alternativo, obtido dividindo por \(n\), é o estimador de máxima verossimilhança (MLE):
\[\hat{\sigma}^2_{\text{MLE}} = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2\]
O MLE é tendencioso: \(E[\hat{\sigma}^2_{\text{MLE}}] = \frac{n-1}{n}\sigma^2 < \sigma^2\).
Por que dividir por \(n-1\)?
A intuição: ao calcular os desvios \((x_i - \bar{x})\), usamos \(\bar{x}\) em vez do \(\mu\) desconhecido. A média amostral \(\bar{x}\) está sempre no centro dos dados, então os desvios em relação a \(\bar{x}\) tendem a ser ligeiramente menores do que os desvios em relação a \(\mu\). Isso faz com que \(\frac{1}{n}\sum(x_i-\bar{x})^2\) subestime sistematicamente \(\sigma^2\).
De forma mais formal: os \(n\) desvios \((x_i - \bar{x})\) precisam somar zero (porque \(\sum(x_i - \bar{x}) = 0\)), então apenas \(n-1\) deles são livres para variar. O divisor \(n-1\) reflete essa perda de um grau de liberdade.
Suponha que a população real tenha \(\sigma^2 = 10\). Tomamos repetidamente amostras de tamanho \(n = 5\) e calculamos ambos os estimadores.
No longo prazo (em muitas amostras):
\[E\!\left[\frac{1}{5}\sum(x_i-\bar{x})^2\right] = \frac{4}{5} \times 10 = 8 \quad \text{(subestima em 20\%)}\]
\[E\!\left[\frac{1}{4}\sum(x_i-\bar{x})^2\right] = 10 \quad \text{(correto em média)}\]
Para amostras pequenas (\(n = 5\)), o viés do MLE é de 20%. Para \(n = 100\), é de apenas 1%, por isso a distinção importa mais em amostras pequenas.

Distribuição amostral de \(S^2\)
O resultado-chave que conecta \(S^2\) à distribuição qui-quadrado: se a população é normal, então:
\[\frac{(n-1)S^2}{\sigma^2} \sim \chi^2(n-1)\]
Esse resultado tem dois usos: confirma que \(S^2\) é não tendencioso (já que \(E[\chi^2(n-1)] = n-1\), o que dá \(E[S^2] = \sigma^2\)), e é a base para intervalos de confiança e testes de hipóteses sobre \(\sigma^2\).
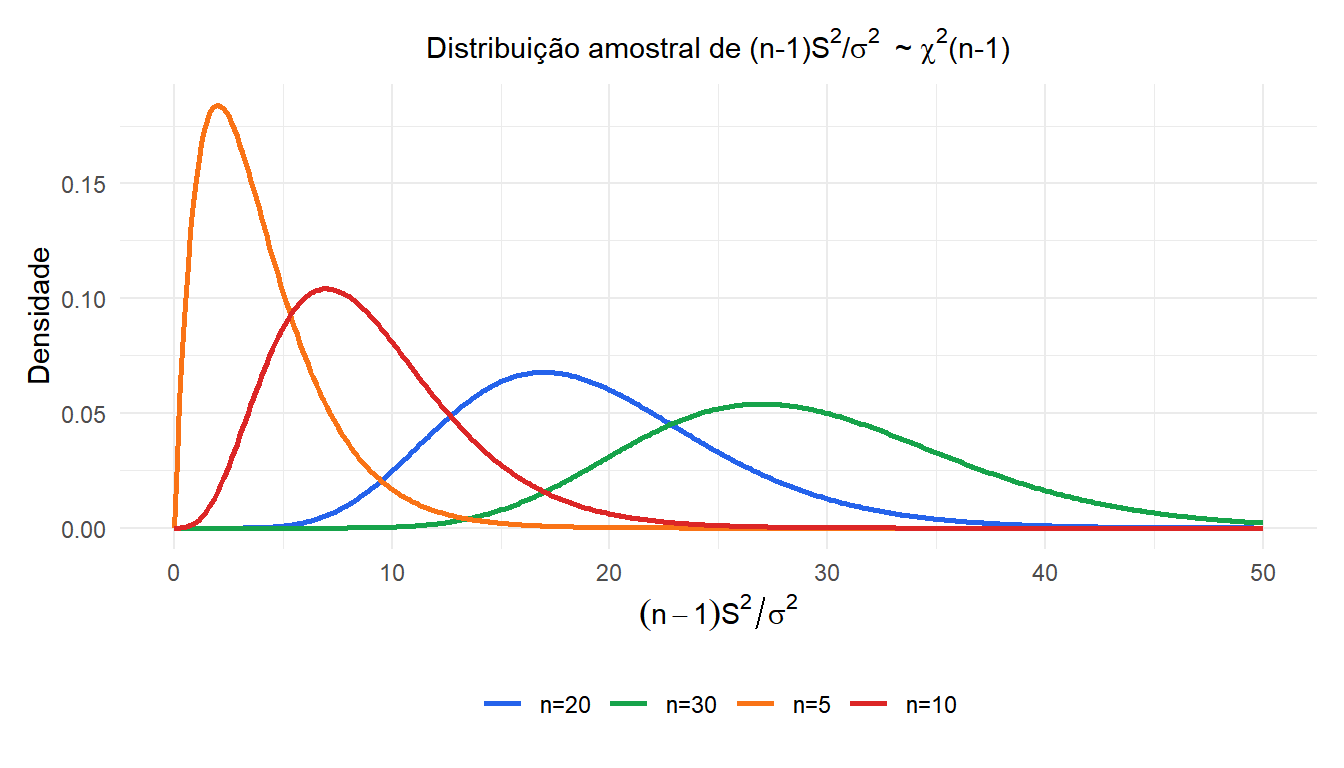
⚠️ A distribuição qui-quadrado não é simétrica
Diferentemente da distribuição amostral de \(\bar{X}\), a distribuição de \(S^2\) é sempre assimétrica à direita. Isso tem duas consequências práticas:
- Os intervalos de confiança para \(\sigma^2\) não são simétricos em torno de \(S^2\): o limite superior fica mais distante de \(S^2\) do que o limite inferior.
- A assimetria é mais pronunciada para \(n\) pequeno e desaparece lentamente conforme \(n\) cresce. Para amostras pequenas, a suposição de normalidade da população é importante: o resultado qui-quadrado só vale exatamente quando a população é normal.
Comparando os dois estimadores
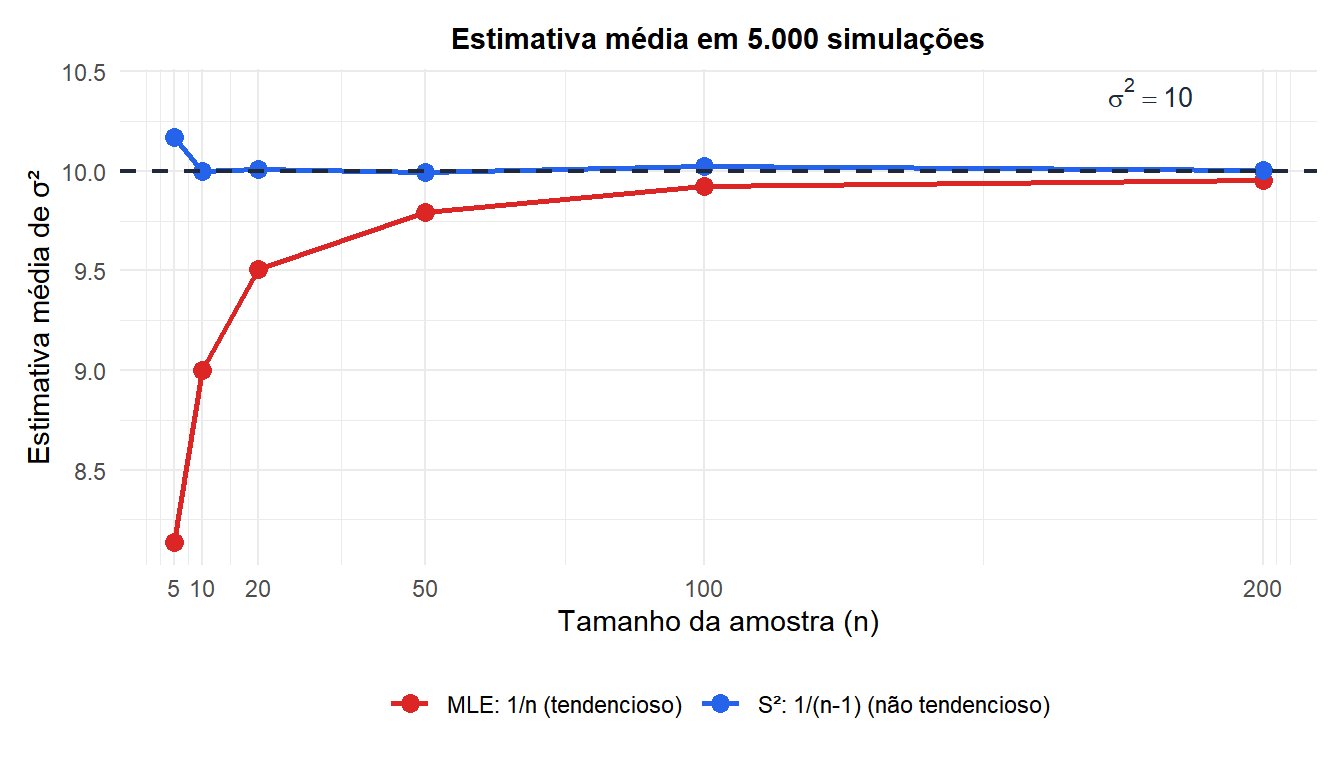
A simulação confirma: \(S^2\) (azul) permanece no alvo \(\sigma^2 = 10\) para todos os tamanhos de amostra, enquanto o MLE (vermelho) subestima sistematicamente, especialmente para \(n\) pequeno.
Exemplo passo a passo
Um engenheiro de qualidade mede o diâmetro (em mm) de 8 rolamentos de uma produção:
\[12{,}1;\; 11{,}9;\; 12{,}3;\; 12{,}0;\; 11{,}8;\; 12{,}2;\; 12{,}1;\; 12{,}4\]
Passo 1: calcule a média amostral:
\[\bar{x} = \frac{12{,}1 + 11{,}9 + \cdots + 12{,}4}{8} = \frac{96{,}8}{8} = 12{,}1 \text{ mm}\]
Passo 2: calcule os desvios ao quadrado:
\[\sum(x_i - \bar{x})^2 = 0 + 0{,}04 + 0{,}04 + 0{,}01 + 0{,}09 + 0{,}01 + 0 + 0{,}09 = 0{,}28\]
Passo 3: divida por \(n - 1 = 7\):
\[S^2 = \frac{0{,}28}{7} = 0{,}04 \text{ mm}^2, \qquad S = \sqrt{0{,}04} = 0{,}2 \text{ mm}\]
A variância populacional estimada é \(0{,}04\) mm², e o desvio padrão é \(0{,}2\) mm. O MLE daria \(0{,}28/8 = 0{,}035\) mm², subestimando em 12,5%.
💡 Variância amostral vs. desvio padrão amostral
\(S^2\) é não tendencioso para \(\sigma^2\), mas \(S = \sqrt{S^2}\) não é não tendencioso para \(\sigma\). A raiz quadrada de um estimador não tendencioso não é, em si, não tendenciosa (desigualdade de Jensen para funções côncavas). Na prática, esse viés é pequeno e \(S\) continua sendo o estimador padrão para \(\sigma\), embora tecnicamente exista um fator de correção para populações normais.

