O que é um estimador?
Um estimador é uma função dos dados amostrais usada para aproximar um parâmetro populacional desconhecido. Escolher um bom estimador não é óbvio: dois estimadores diferentes do mesmo parâmetro podem ter precisão, variância e comportamento muito diferentes diante de violações das suposições. Este post abre nosso guia mais amplo sobre estimação pontual e intervalos de confiança.
Definição
Um parâmetro populacional é uma característica fixa e desconhecida de uma população: a média \(\mu\), a variância \(\sigma^2\), a proporção \(p\), e assim por diante. Como não é possível medir a população inteira, coletamos uma amostra \(x_1, x_2, \ldots, x_n\) e usamos uma função dessas observações para aproximar o parâmetro.
Um estimador \(\hat{\theta}\) é qualquer função dos dados amostrais usada para estimar um parâmetro populacional \(\theta\):
\[\hat{\theta} = g(x_1, x_2, \ldots, x_n)\]
O resultado de aplicar o estimador a um conjunto de dados específico é chamado de estimativa. O estimador é a regra; a estimativa é o número.
⚠️ Estimador vs. estimativa: duas coisas diferentes
Um estimador é uma variável aleatória: antes de coletar os dados, ele pode assumir muitos valores possíveis dependendo de qual amostra você obtém. Uma estimativa é o valor específico que o estimador assume depois que você tem seus dados.
A média amostral \(\bar{X} = \frac{1}{n}\sum X_i\) é um estimador. O valor \(\bar{x} = 47{,}3\) calculado a partir de um conjunto de dados específico é uma estimativa. Essa distinção importa ao discutir propriedades como a não tendenciosidade, que é uma propriedade do estimador (seu comportamento médio em todas as amostras possíveis), não de uma estimativa isolada.
Os estimadores se dividem em duas grandes categorias:
- Estimadores pontuais: produzem um único valor como estimativa (\(\hat{\mu} = \bar{x}\)).
- Estimadores por intervalo: produzem um intervalo de valores plausíveis (intervalos de confiança).
Este post foca nos estimadores pontuais.
Propriedades desejáveis dos estimadores
- Não tendenciosidade
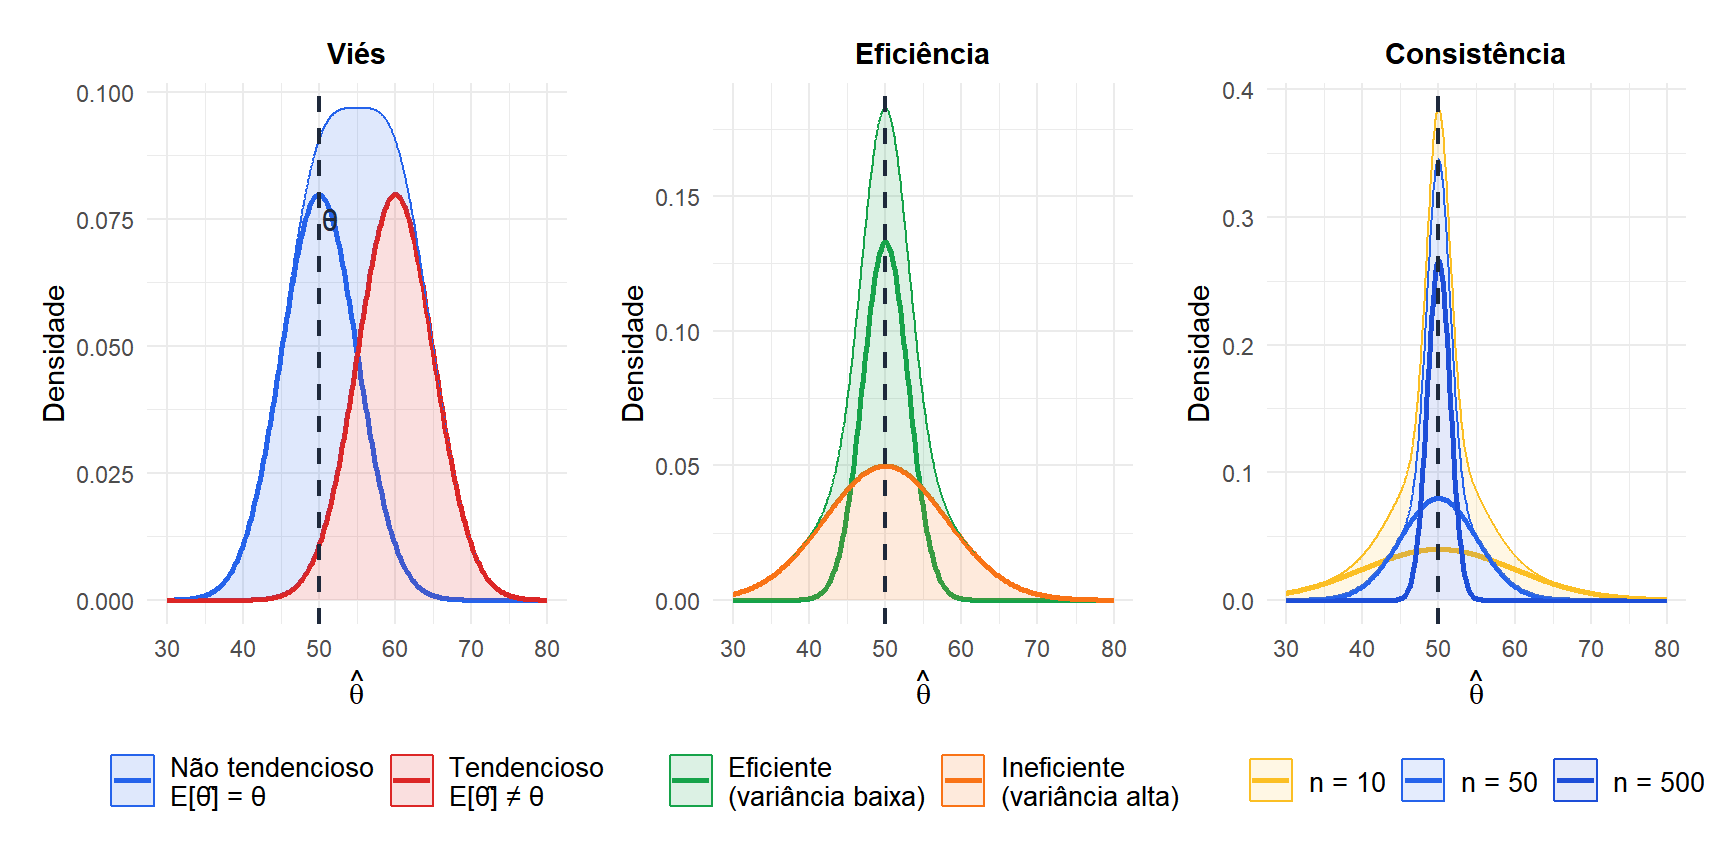
Um estimador \(\hat{\theta}\) é não tendencioso (ou não viesado) se seu valor esperado é igual ao verdadeiro parâmetro:
\[E[\hat{\theta}] = \theta\]
A média amostral \(\bar{X}\) é um estimador não tendencioso de \(\mu\): em média, considerando todas as amostras possíveis, ela acerta o alvo. A variância amostral \(S^2 = \frac{1}{n-1}\sum(X_i - \bar{X})^2\) é um estimador não tendencioso de \(\sigma^2\): observe o \(n-1\) no denominador (correção de Bessel). Usar \(n\) em vez disso dá um estimador tendencioso.
- Consistência
Um estimador é consistente se converge para o valor verdadeiro conforme o tamanho da amostra cresce:
\[\lim_{n \to \infty} P(|\hat{\theta} - \theta| > \varepsilon) = 0 \quad \text{para qualquer } \varepsilon > 0\]
Um estimador consistente se torna mais preciso com mais dados. A média amostral é consistente para \(\mu\); a mediana amostral também é consistente para \(\mu\) em distribuições simétricas.
- Eficiência
Entre todos os estimadores não tendenciosos, o estimador eficiente tem a menor variância. O limite teórico inferior é dado pelo limite de Cramér-Rao:
\[\text{Var}(\hat{\theta}) \geq \frac{1}{I(\theta)}\]
em que \(I(\theta)\) é a informação de Fisher. Um estimador que atinge esse limite é chamado de estimador não tendencioso de variância mínima (MVUE). Para dados normalmente distribuídos, \(\bar{X}\) é o MVUE para \(\mu\).
- Suficiência
Um estimador é suficiente se captura toda a informação da amostra relevante para \(\theta\). Uma vez que você conhece uma estatística suficiente, o resto dos dados não acrescenta nada. A média amostral é suficiente para \(\mu\) em populações normais.
- Robustez
Um estimador robusto tem bom desempenho mesmo quando as suposições são violadas, particularmente na presença de outliers. A mediana é mais robusta do que a média: uma única observação extrema pode deslocar bastante a média, mas quase não move a mediana.
Erro quadrático médio
Na prática, a não tendenciosidade e a eficiência frequentemente estão em tensão: um estimador ligeiramente tendencioso, mas com variância muito menor, pode ser mais útil do que um estimador não tendencioso com variância alta. O erro quadrático médio (EQM) unifica os dois:
\[\text{EQM}(\hat{\theta}) = E[(\hat{\theta} - \theta)^2] = \text{Var}(\hat{\theta}) + \text{Viés}(\hat{\theta})^2\]
Um bom estimador minimiza o EQM, não necessariamente apenas o viés. Essa é a base do compromisso entre viés e variância, central tanto na estatística clássica quanto no machine learning.
Dois estimadores para a variância populacional \(\sigma^2\):
- \(S^2 = \frac{1}{n-1}\sum(X_i - \bar{X})^2\): não tendencioso, \(E[S^2] = \sigma^2\).
- \(\hat{\sigma}^2 = \frac{1}{n}\sum(X_i - \bar{X})^2\): tendencioso, \(E[\hat{\sigma}^2] = \frac{n-1}{n}\sigma^2\).
O estimador tendencioso tem variância ligeiramente menor. Para \(n\) grande, a diferença é desprezível, mas para amostras pequenas a versão não tendenciosa é preferida. Na estimação por máxima verossimilhança, \(\hat{\sigma}^2\) (com \(n\) no denominador) costuma ser usado, aceitando um pequeno viés em troca de outras propriedades favoráveis.

Estimadores comuns
| Parâmetro | Estimador | Não tendencioso? | Observações |
|---|---|---|---|
| Média \(\mu\) | \(\bar{X} = \frac{1}{n}\sum X_i\) | Sim | MVUE para dados normais |
| Variância \(\sigma^2\) | \(S^2 = \frac{1}{n-1}\sum(X_i-\bar{X})^2\) | Sim | Correção de Bessel |
| Proporção \(p\) | \(\hat{p} = X/n\) | Sim | \(X\) = número de sucessos |
| Mediana | Mediana amostral | Sim (dist. simétricas) | Mais robusta do que a média |
| Máximo de Uniforme\((0,\theta)\) | \(\frac{n+1}{n}X_{(n)}\) | Sim | O MLE \(X_{(n)}\) é tendencioso |
💡 Como escolher entre estimadores
Nenhum critério único domina em todas as situações:
- Se as suposições forem válidas (normalidade, sem outliers): prefira o MVUE, geralmente a média amostral.
- Se os dados tiverem caudas pesadas ou outliers: prefira estimadores robustos (mediana, média truncada).
- Se o tamanho da amostra for pequeno: a não tendenciosidade importa mais; prefira \(S^2\) em vez de \(\hat{\sigma}^2\).
- Se a precisão da previsão importa mais do que a interpretabilidade: minimize o EQM, aceitando algum viés.
Na prática, ajuda examinar os dados, verificar as suposições e comparar estimadores usando simulação quando a melhor escolha não for clara.

