Algoritmos gulosos
Um algoritmo guloso faz a escolha localmente ótima a cada passo, nunca reconsiderando decisões passadas. Quando o problema tem a propriedade da escolha gulosa, essa estratégia simples produz uma solução globalmente ótima. Algoritmos gulosos são mais rápidos do que a programação dinâmica, mas aplicáveis a uma classe mais estreita de problemas.
A propriedade da escolha gulosa
Um problema tem a propriedade da escolha gulosa se uma solução globalmente ótima pode ser construída fazendo escolhas localmente ótimas: a cada passo, a melhor opção disponível leva a uma solução ótima sem precisar reconsiderar escolhas anteriores.
Isso é mais forte do que apenas a subestrutura ótima (que a PD exige). A PD também precisa de subproblemas sobrepostos. O guloso funciona quando:
- Subestrutura ótima: a solução ótima do problema inteiro contém soluções ótimas de subproblemas.
- Propriedade da escolha gulosa: a escolha localmente ótima a cada passo é sempre parte de alguma solução globalmente ótima.
Quando ambas valem, o guloso é preferível à PD: é mais simples, mais rápido, e usa menos memória. Quando apenas a subestrutura ótima vale, mas não a propriedade da escolha gulosa, a PD é necessária.
Provar que um algoritmo guloso é correto sempre segue a mesma estrutura: assuma uma solução ótima que difere da solução gulosa, troque a escolha gulosa, e mostre que o resultado não é pior. Esse argumento de troca é a técnica de prova padrão.
Exemplo 1: seleção de atividades
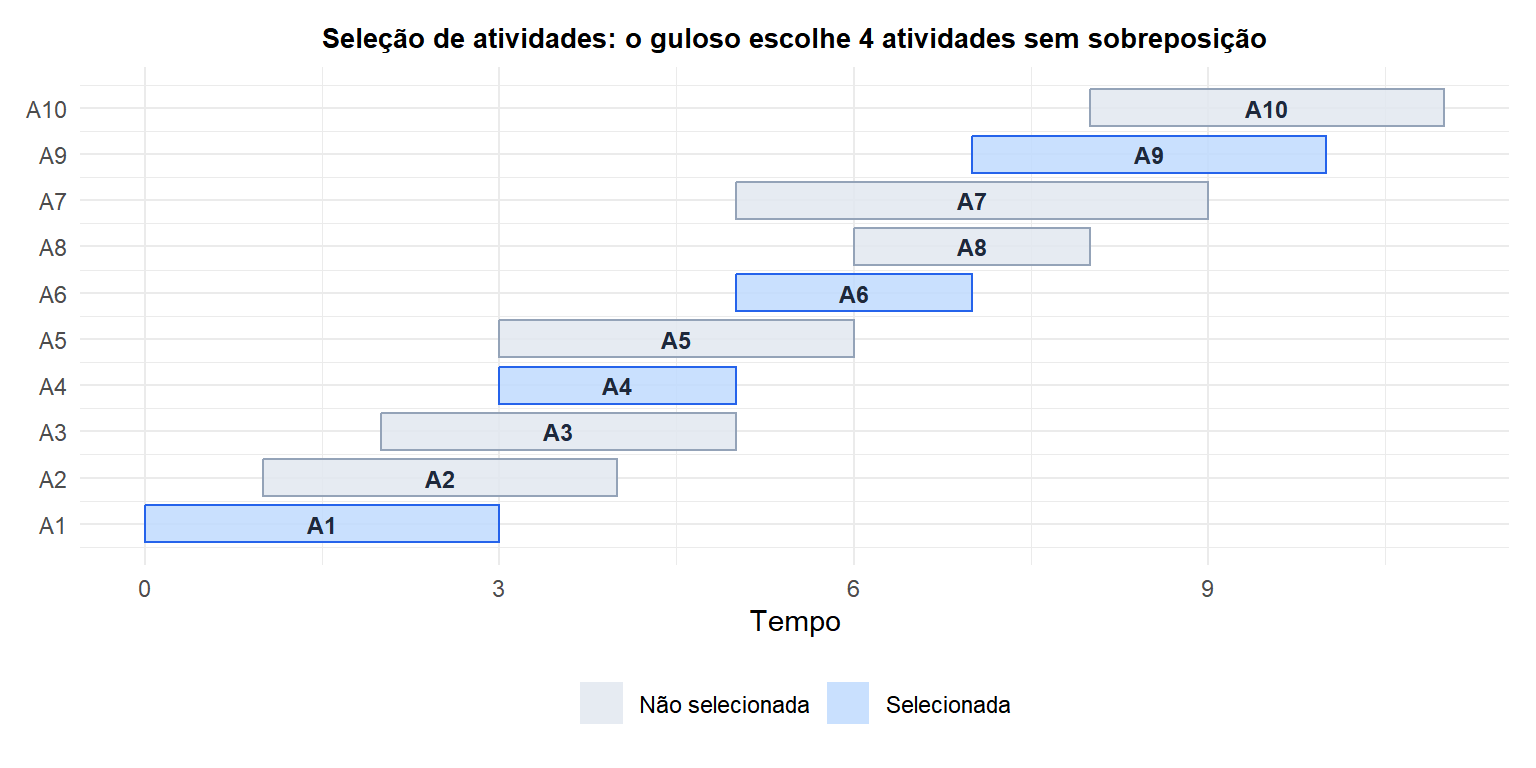
\(n\) atividades com horários de início \(s_i\) e término \(f_i\). Selecione o número máximo de atividades que não se sobrepõem.
Estratégia gulosa: sempre selecione a atividade que termina mais cedo entre as compatíveis com a seleção atual.
Por que funciona: escolher a atividade que termina primeiro deixa o maior tempo restante para outras atividades. Qualquer solução que pula a atividade compatível de término mais cedo pode ser melhorada trocando essa atividade (argumento de troca).
Algoritmo: ordene as atividades por horário de término. Percorra da esquerda para a direita; adicione cada atividade se ela não se sobrepuser à última selecionada.
Complexidade de tempo: \(O(n \log n)\) para a ordenação, \(O(n)\) para a varredura.
Exemplo 2: codificação de Huffman
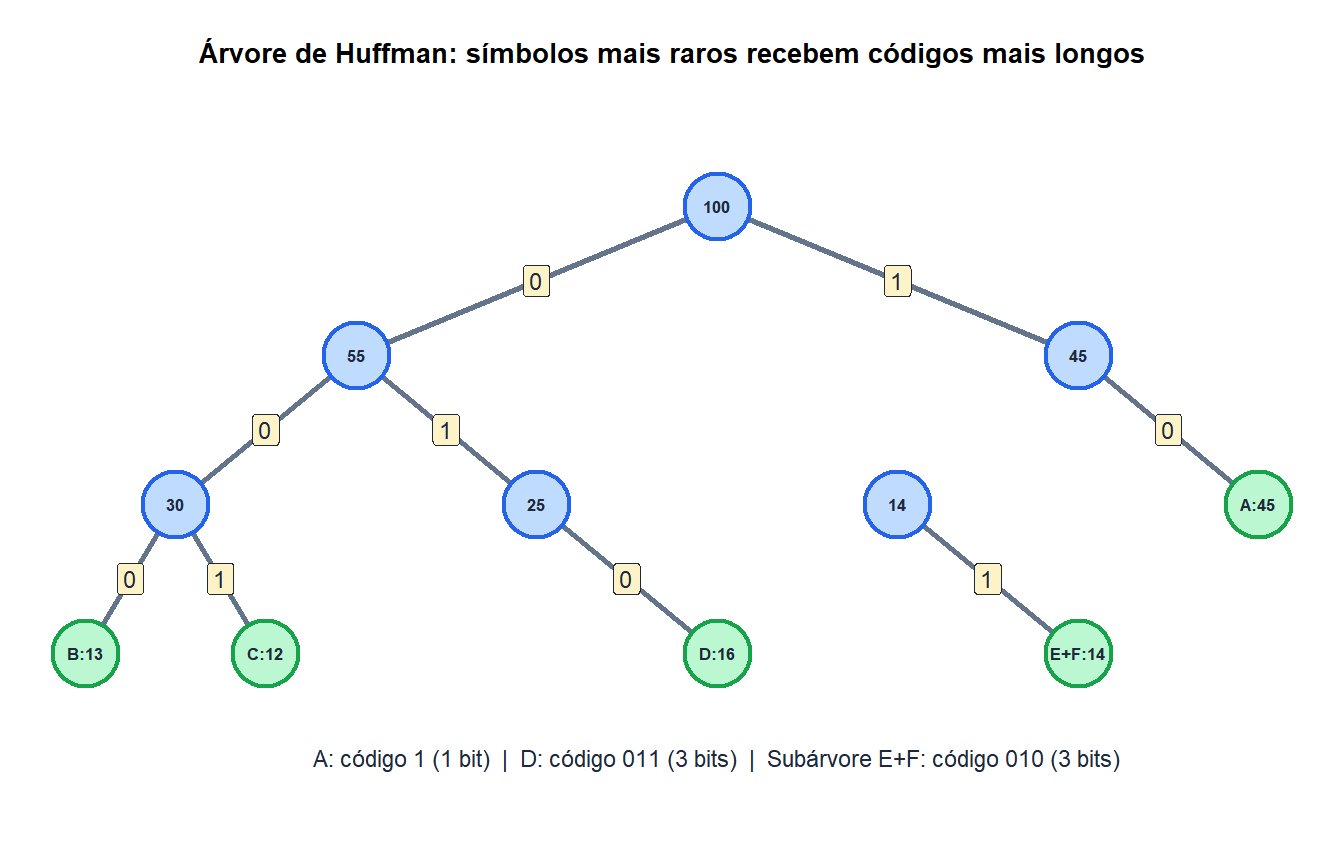
Atribua códigos binários a \(n\) símbolos com frequências \(f_i\) para minimizar o comprimento total codificado \(\sum_i f_i \cdot \text{profundidade}(i)\), em que profundidade é o comprimento do código.
Estratégia gulosa: mescle repetidamente os dois símbolos (ou subárvores) com as frequências mais baixas em uma nova subárvore. A frequência do nó mesclado é a soma dos dois filhos.
Por que funciona: os dois símbolos mais raros devem estar mais profundos na árvore (códigos mais longos), já que sua contribuição \(f_i \cdot \text{profundidade}(i)\) para o comprimento total é minimizada dando a eles os códigos mais longos. O argumento de troca mostra que qualquer outra atribuição não é melhor.
Resultado: a codificação de Huffman é comprovadamente ótima entre todos os códigos livres de prefixo. Ela fundamenta a compressão DEFLATE (ZIP, PNG, HTTP/2).
Exemplo 3: árvore geradora mínima (algoritmo de Kruskal)
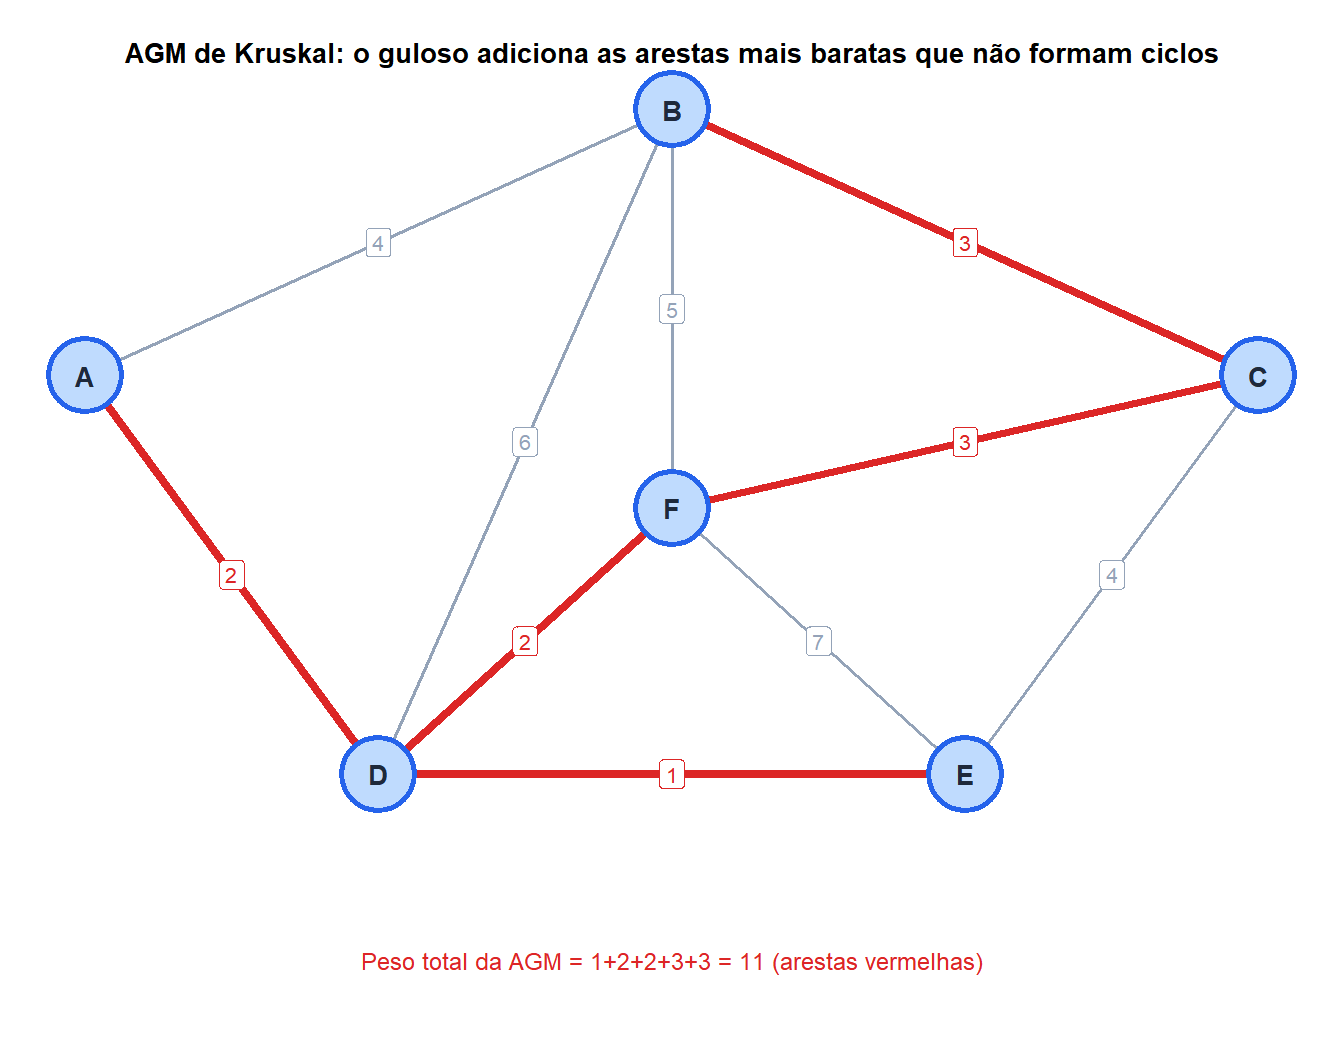
Dado um grafo ponderado conexo, encontre a árvore geradora (subgrafo conectando todos os vértices sem ciclos) de peso total mínimo.
Estratégia gulosa de Kruskal: ordene todas as arestas por peso. Adicione cada aresta à árvore geradora se ela não criar um ciclo.
Por que funciona: a propriedade de corte das árvores geradoras garante que a aresta de menor peso cruzando qualquer corte (partição de vértices em dois conjuntos) é segura para incluir. Cada seleção gulosa de aresta satisfaz essa propriedade.
Complexidade de tempo: \(O(E \log E)\) para a ordenação, quase \(O(E \alpha(V))\) para detecção de ciclos com uma estrutura de dados Union-Find (\(\alpha\) é a função de Ackermann inversa, efetivamente constante).
Quando o guloso falha
A propriedade da escolha gulosa nem sempre vale. A falha clássica: o problema do troco com denominações não padronizadas.
Com moedas \(\{1, 5, 6\}\) e valor-alvo 10:
- Guloso (moeda maior primeiro): \(6 + 1 + 1 + 1 + 1 = 5\) moedas.
- Ótimo (PD): \(5 + 5 = 2\) moedas.
A escolha gulosa (pegar 6) é localmente ótima, mas globalmente subótima. A PD encontra a resposta correta.
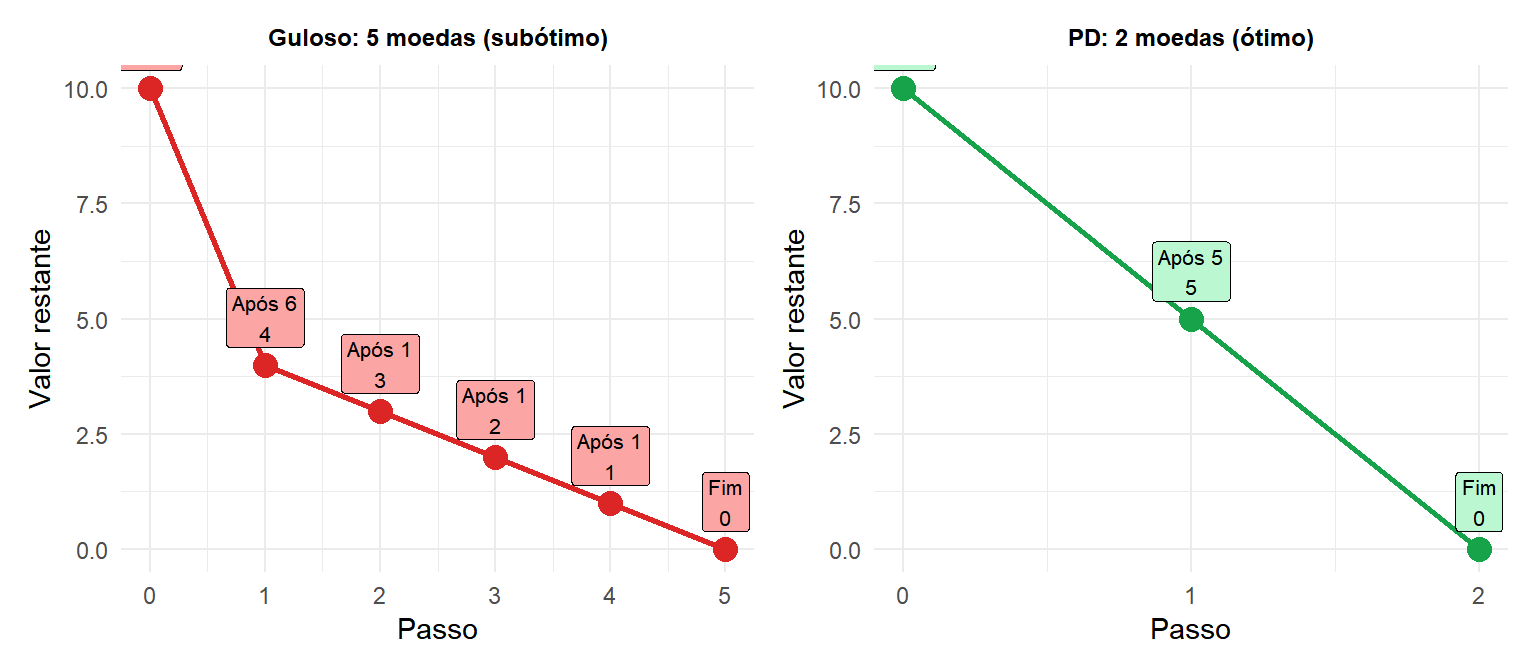
Com moedas \(\{1, 5, 6\}\) e alvo 10, o guloso usa 5 moedas, enquanto a PD encontra o ótimo de 2.
Guloso vs programação dinâmica
| Guloso | Programação dinâmica | |
|---|---|---|
| Abordagem | Escolha ótima local a cada passo | Resolve todos os subproblemas, combina |
| Reconsideração | Nunca | Não (mas considera todas as opções) |
| Correção | Apenas quando a propriedade da escolha gulosa vale | Sempre que a subestrutura ótima vale |
| Complexidade de tempo | Geralmente \(O(n \log n)\) ou \(O(n)\) | Geralmente \(O(n^k)\) para algum \(k\) |
| Complexidade de espaço | \(O(1)\) ou \(O(n)\) | Tabela \(O(n^k)\) |
| Exemplos | Seleção de atividades, Huffman, Kruskal, Dijkstra | Mochila, LCS, distância de edição, TSP |
O guloso é sempre preferível quando funciona: mais simples e mais rápido. Use PD quando o guloso falha devido à falta da propriedade da escolha gulosa.
⚠️ Provar a correção do guloso exige um argumento de troca
Algoritmos gulosos são fáceis de projetar, mas difíceis de provar corretos. Nunca assuma que uma estratégia gulosa funciona só porque parece intuitiva. Para todo algoritmo guloso, você deve provar a propriedade da escolha gulosa: mostrar que incluir a escolha gulosa na solução não impede encontrar uma conclusão ótima.
O modelo de prova padrão: assuma uma solução ótima \(OPT\) que não faz a escolha gulosa no passo \(k\). Construa \(OPT'\) trocando pela escolha gulosa. Mostre que \(OPT'\) é viável e não é pior do que \(OPT\). Portanto, existe uma solução ótima que faz a escolha gulosa, e o algoritmo guloso está correto.
Sem essa prova, uma estratégia gulosa plausível pode falhar em entradas específicas, como mostra o exemplo do troco.
💡 Algoritmos gulosos em R
# Activity selection
activity_selection <- function(start, finish) {
  n    <- length(start)
  idx  <- order(finish)           # sort by finish time
  sel  <- idx[1]                  # always select first
  last <- finish[idx[1]]
  for (i in 2:n) {
    j <- idx[i]
    if (start[j] >= last) {
      sel  <- c(sel, j)
      last <- finish[j]
    }
  }
  sel
}

# Kruskal MST via igraph
library(igraph)
g <- graph_from_data_frame(
  data.frame(from=c("A","A","B","B","B","C","C","D","D","E"),
             to  =c("B","D","C","D","F","E","F","E","F","F"),
             weight=c(4,2,3,6,5,4,3,1,2,7)),
  directed=FALSE
)
mst_g <- mst(g, weights=E(g)$weight)  # Kruskal internally
sum(E(mst_g)$weight)  # 11
