Descida do gradiente
A descida do gradiente minimiza uma função diferenciável \(f(x)\) movendo-se repetidamente na direção oposta ao gradiente, que é a direção de maior crescimento. É o algoritmo fundamental por trás do treinamento de redes neurais, da regressão logística, e de praticamente todo modelo de machine learning em larga escala.
Intuição
Imagine estar em uma paisagem montanhosa em meio a uma neblina espessa. Você não consegue ver o vale, mas consegue sentir a inclinação sob seus pés. A estratégia de maior descida: a cada passo, mova-se na direção em que o terreno desce mais abruptamente. Repita até alcançar um ponto plano.
O gradiente \(\nabla f(x)\) aponta na direção de maior crescimento. Mover-se no sentido oposto, \(-\nabla f(x)\), dá a direção de maior descida. O tamanho do passo (quanto se mover) é controlado pela taxa de aprendizado \(\alpha > 0\).
A regra de atualização
Transformar essa intuição da neblina e da encosta em um algoritmo resulta em uma única atualização repetida:
\[x_{k+1} = x_k - \alpha \nabla f(x_k)\]
Partindo de um ponto inicial \(x_0\), isso é aplicado iterativamente até que um critério de parada seja atingido: \(\|\nabla f(x_k)\| < \varepsilon\), o número máximo de iterações é alcançado, ou a melhora em \(f\) cai abaixo de um limiar.
Para uma função de uma variável: \(x_{k+1} = x_k - \alpha f'(x_k)\). A atualização subtrai a inclinação escalada por \(\alpha\).
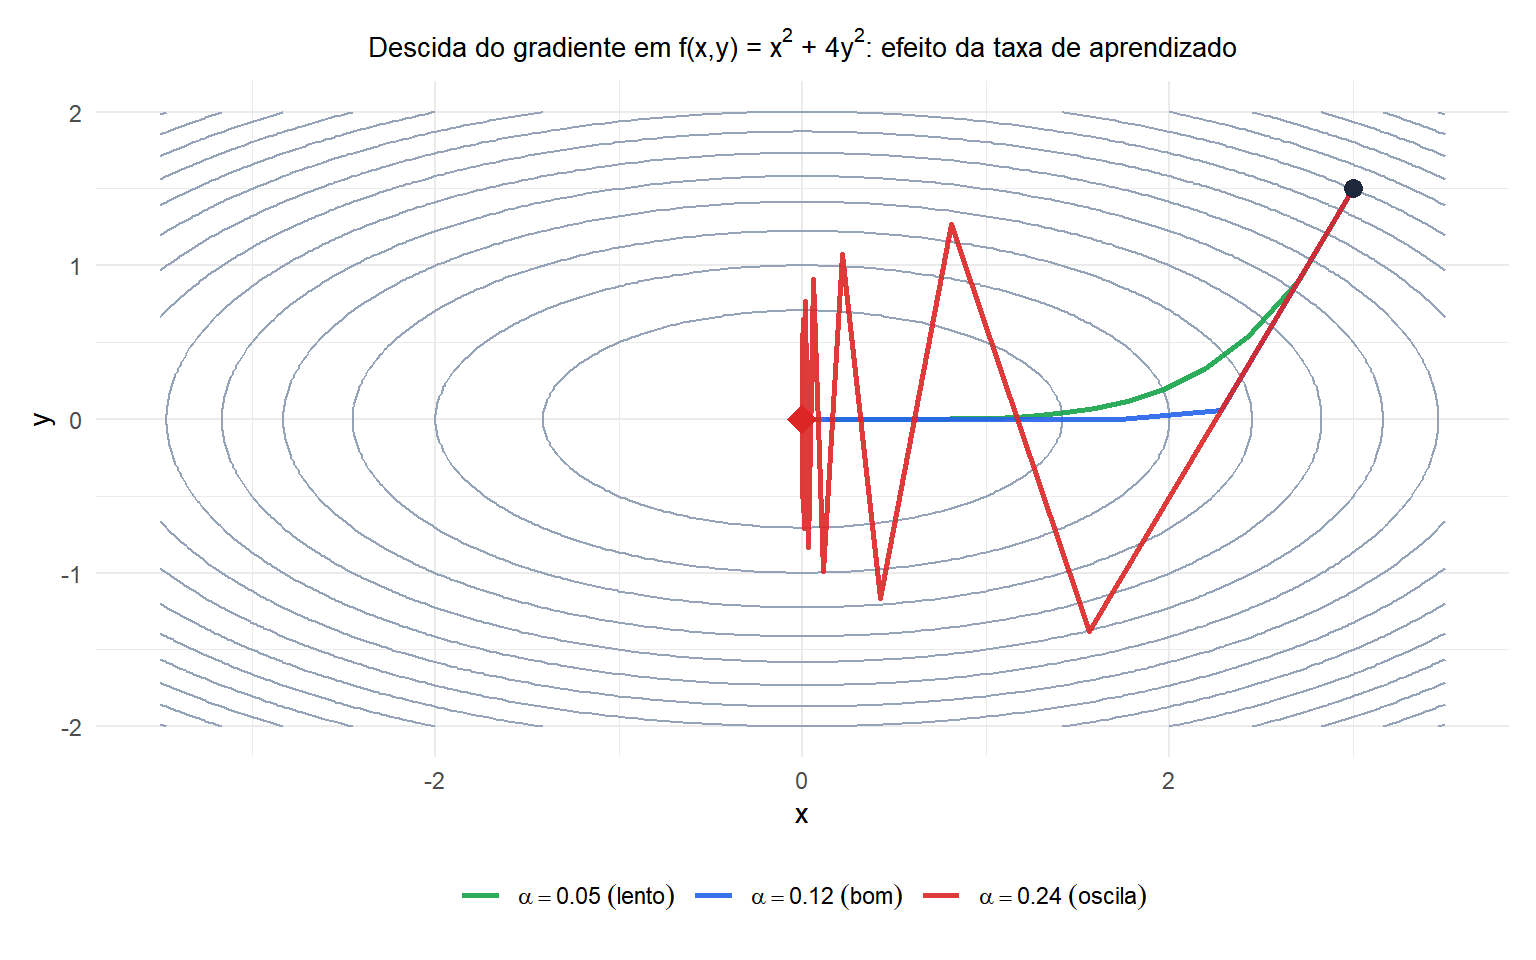
Taxa de aprendizado baixa (verde) converge com segurança, mas lentamente. Taxa boa (azul) converge em poucas iterações. Taxa alta (vermelho) oscila através do vale: a forma elíptica significa que a direção \(y\) tem curvatura muito mais acentuada, e passos grandes ultrapassam o alvo.
A taxa de aprendizado
A taxa de aprendizado \(\alpha\) é o hiperparâmetro mais importante na descida do gradiente. Para uma função com gradiente Lipschitz-contínuo (o gradiente não muda rápido demais), a taxa de aprendizado fixa ótima satisfaz:
\[\alpha \leq \frac{1}{L}\]
em que \(L\) é a constante de Lipschitz do gradiente: \(\|\nabla f(x) - \nabla f(y)\| \leq L\|x-y\|\) para todo \(x, y\). Para a quadrática \(f(x) = \frac{1}{2}x^T H x\), \(L\) é igual ao maior autovalor de \(H\).
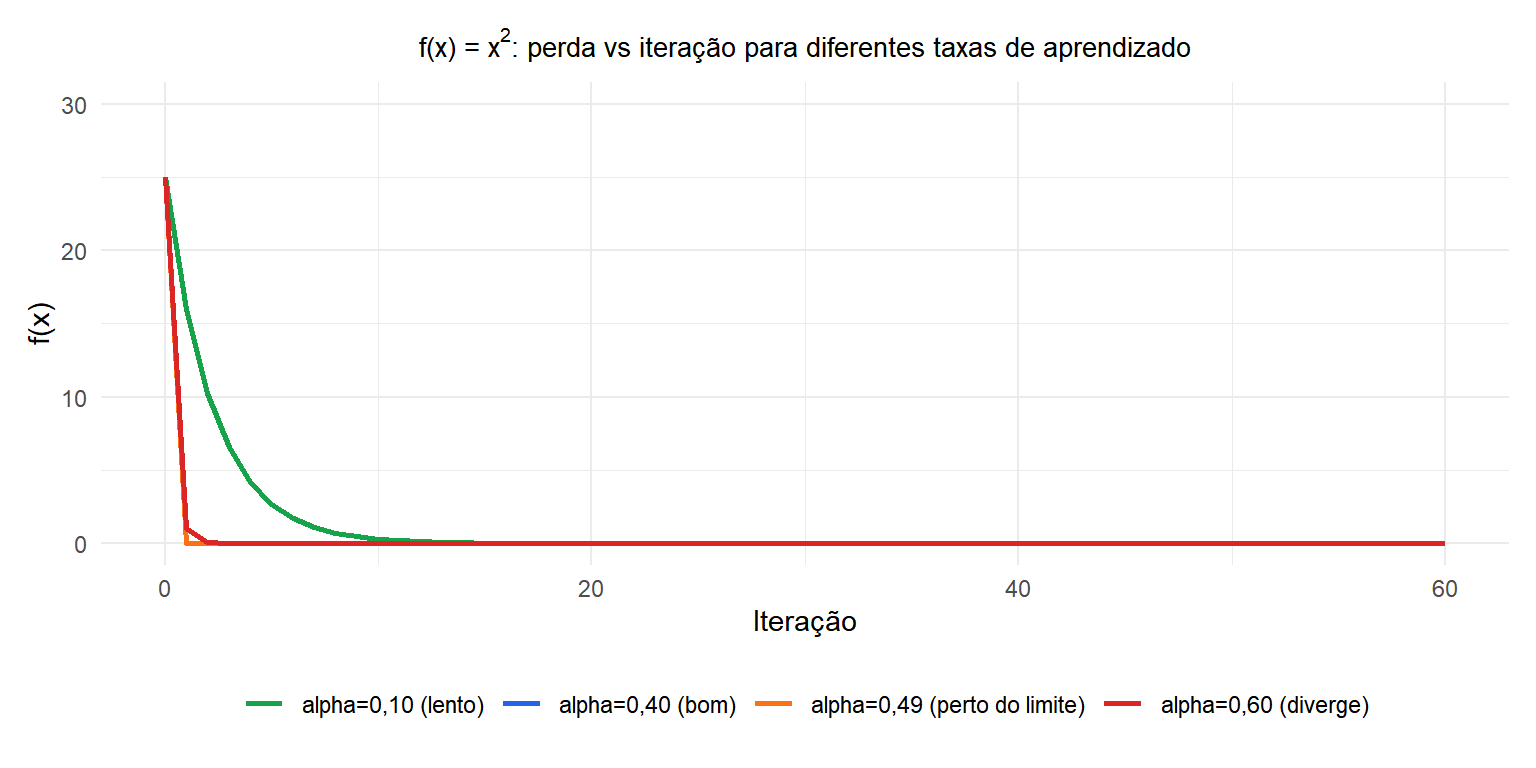
Para \(f(x)=x^2\), a constante de Lipschitz é \(L=2\) e o limiar seguro é \(\alpha \leq 0{,}5\). Em \(\alpha=0{,}49\) (laranja), a convergência é muito lenta perto do limite; em \(\alpha=0{,}6\) (vermelho), os iterados divergem.
Teoria de convergência
Para uma função convexa com gradiente \(L\)-Lipschitz, a descida do gradiente com passo constante \(\alpha = 1/L\) alcança:
\[f(x_k) - f(x^*) \leq \frac{L \|x_0 - x^*\|^2}{2k}\]
Isso é convergência sublinear: \(O(1/k)\). Para reduzir o erro pela metade, você precisa de quatro vezes mais iterações.
Para funções fortemente convexas (autovalores da Hessiana limitados inferiormente por \(\mu > 0\)), a convergência é linear (geométrica):
\[f(x_k) - f(x^*) \leq \left(1 - \frac{\mu}{L}\right)^k (f(x_0) - f(x^*))\]
A razão \(\kappa = L/\mu\) é o número de condição. Problemas mal condicionados (\(\kappa \gg 1\), contornos alongados como a elipse acima) convergem muito lentamente. É por isso que o pré-condicionamento e os métodos adaptativos (Adam, RMSProp) importam.
Batch, estocástico, e mini-batch
Em machine learning, \(f(\theta) = \frac{1}{n}\sum_{i=1}^n \ell(\theta; x_i, y_i)\) é uma soma sobre \(n\) exemplos de treinamento. Calcular o gradiente completo exige avaliar todos os \(n\) termos, o que é caro para grandes conjuntos de dados.
Descida do gradiente em batch
Usa o conjunto de dados completo para calcular o gradiente em cada passo. Gradiente exato, convergência estável, mas lenta por iteração para \(n\) grande.
Descida do gradiente estocástica (SGD)
Usa um único exemplo \(i\) escolhido aleatoriamente a cada passo:
\[x_{k+1} = x_k - \alpha \nabla \ell(\theta; x_{i_k}, y_{i_k})\]
Muito mais rápida por iteração. O gradiente é uma estimativa ruidosa: \(E[\nabla \ell_i] = \nabla f\). Esse ruído impede a convergência exata, mas ajuda a escapar de mínimos locais rasos. Exige taxa de aprendizado decrescente (\(\alpha_k \to 0\)) para garantias teóricas de convergência.
Descida do gradiente mini-batch
Usa um pequeno lote de \(B\) exemplos (tipicamente \(B = 32\) a \(512\)):
\[x_{k+1} = x_k - \frac{\alpha}{B} \sum_{i \in \mathcal{B}_k} \nabla \ell(\theta; x_i, y_i)\]
É o padrão em deep learning. Equilibra a redução de variância do batch com a velocidade do SGD. O paralelismo em GPU torna o cálculo em lote quase gratuito para valores razoáveis de \(B\).
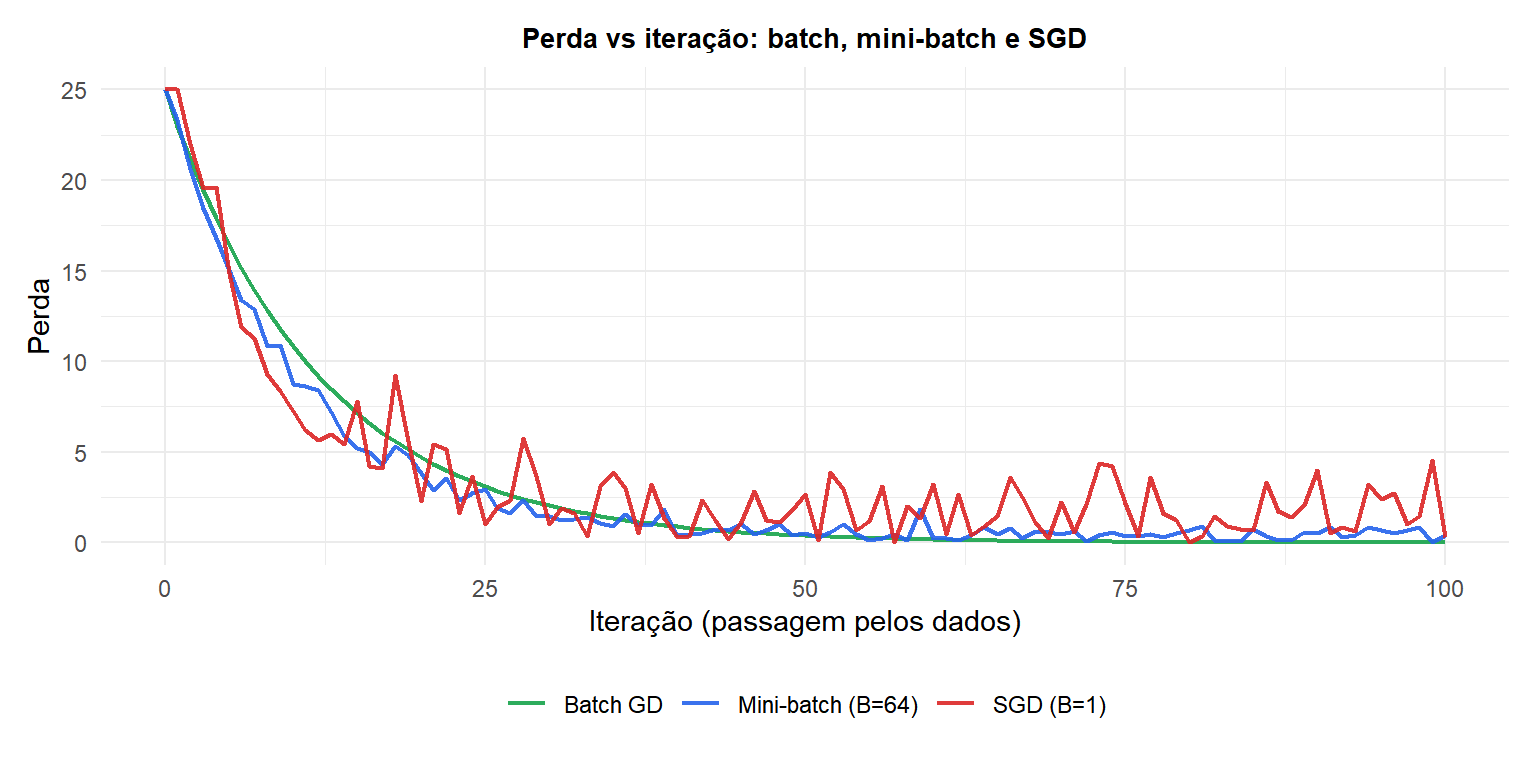
O GD em batch (verde) desce suavemente, mas devagar. O SGD (vermelho) desce mais rápido inicialmente, mas oscila. O mini-batch (azul) equilibra os dois: descida rápida com ruído moderado.
Escolhendo a taxa de aprendizado: busca em linha
Em vez de um \(\alpha\) fixo, a busca em linha (line search) encontra o melhor tamanho de passo em cada iteração:
\[\alpha_k = \arg\min_{\alpha > 0} f(x_k - \alpha \nabla f(x_k))\]
A busca em linha exata resolve essa minimização exatamente (viável para funções simples). A busca em linha com retrocesso (backtracking) é prática: comece com um \(\alpha\) grande e reduza-o pela metade até que a condição de Armijo seja satisfeita:
\[f(x_k - \alpha \nabla f(x_k)) \leq f(x_k) - c \alpha \|\nabla f(x_k)\|^2\]
para alguma constante pequena \(c \in (0,1)\) (tipicamente \(c = 10^{-4}\)). Isso garante redução suficiente sem exigir minimização exata.
⚠️ A descida do gradiente falha para funções não suaves e não convexas
Três situações em que a descida do gradiente padrão não é confiável:
Funções não suaves: se \(f\) não é diferenciável em \(x_k\) (por exemplo, regularização L1, ReLU), o gradiente não existe. Use métodos de subgradiente ou algoritmos proximais em vez disso.
Funções não convexas: a descida do gradiente converge para um ponto estacionário, não necessariamente um mínimo global. Em deep learning, isso é aceito na prática (a maioria dos mínimos locais é empiricamente boa), mas não há garantia teórica.
Pontos de sela: em altas dimensões, pontos estacionários costumam ser pontos de sela (gradiente zero, mas não um mínimo). A descida do gradiente padrão pode ficar presa perto de pontos de sela por um tempo exponencialmente longo. O ruído do SGD e métodos com momentum (Adam) ajudam a escapar deles mais rápido.
Extensões: momentum e métodos adaptativos
A descida do gradiente padrão raramente é usada em deep learning. Duas extensões importantes:
Momentum: acumula um vetor de velocidade \(v\) na direção de gradientes consistentes, amortecendo oscilações e acelerando a convergência em direções de baixa curvatura:
\[v_{k+1} = \beta v_k + \nabla f(x_k), \qquad x_{k+1} = x_k - \alpha v_{k+1}\]
Adam (Adaptive Moment Estimation): mantém taxas de aprendizado por parâmetro baseadas em estimativas do primeiro e segundo momento do gradiente. Na prática, adapta \(\alpha\) individualmente para cada dimensão. É o otimizador padrão em deep learning.
Gradiente acelerado de Nesterov (NAG): avalia o gradiente em um ponto “de antecipação” \(x_k - \beta v_k\) em vez de em \(x_k\), dando melhor convergência teórica para funções convexas (\(O(1/k^2)\) em vez de \(O(1/k)\)).
💡 Descida do gradiente em R
# Manual gradient descent for any differentiable f
gradient_descent <- function(f, grad_f, x0, alpha=0.01,
                              max_iter=1000, tol=1e-6) {
  x    <- x0
  path <- matrix(NA, max_iter+1, length(x0))
  path[1,] <- x
  for (k in 1:max_iter) {
    g <- grad_f(x)
    x <- x - alpha * g
    path[k+1,] <- x
    if (sqrt(sum(g^2)) < tol) break
  }
  list(x=x, value=f(x), path=path[1:(k+1),])
}

# Example: minimize f(x,y) = x^2 + 4y^2
f     <- function(x) x[1]^2 + 4*x[2]^2
grad_f <- function(x) c(2*x[1], 8*x[2])
result <- gradient_descent(f, grad_f, x0=c(3,1.5), alpha=0.1)

# For machine learning with automatic differentiation: use torch or tensorflow
# For convex optimization: use CVXR which calls interior point solvers
