Método Simplex
O método Simplex, desenvolvido por George Dantzig em 1947, resolve programas lineares explorando o fato de que a solução ótima sempre está em um vértice do politopo viável. Ele se move de vértice em vértice ao longo das arestas, sempre melhorando a função objetivo, até que não exista mais nenhum vizinho que melhore o resultado.
Ideia-chave
Um programa linear com \(n\) variáveis e \(m\) restrições (em forma padrão, após adicionar \(m\) variáveis de folga) tem no máximo \(\binom{n+m}{m}\) vértices. O método Simplex nunca avalia todos eles: ele começa em um vértice e se move para um vértice adjacente melhor a cada iteração. Na prática, ele termina em \(O(m)\) a \(O(2m)\) pivôs para a maioria dos problemas reais.
Cada vértice corresponde a uma solução viável básica (SVB): uma solução em que exatamente \(m\) variáveis são diferentes de zero (as variáveis básicas) e as \(n\) restantes são zero (as variáveis não básicas). A ideia de restringir a atenção aos vértices reduz um espaço de busca infinito a um finito.
Forma padrão e o tableau inicial
Qualquer PL com restrições de desigualdade é primeiro convertido para forma padrão adicionando variáveis de folga. Para um problema de maximização \(\max z = \mathbf{c}^T x\) sujeito a \(\mathbf{A}x \leq \mathbf{b}\), \(x \geq 0\):
\[\mathbf{A}x + s = \mathbf{b}, \qquad x \geq 0,\; s \geq 0\]
As variáveis de folga \(s_i\) absorvem a folga em cada desigualdade. A SVB inicial é \(x = 0\), \(s = \mathbf{b}\), \(z = 0\): começamos na origem com todas as folgas na base.
O tableau do Simplex organiza o sistema:
\[\begin{array}{c|ccccc|c} \text{Base} & x_1 & x_2 & \cdots & s_1 & s_2 & \text{LD} \\\hline s_1 & a_{11} & a_{12} & \cdots & 1 & 0 & b_1 \\ s_2 & a_{21} & a_{22} & \cdots & 0 & 1 & b_2 \\\hline -z & -c_1 & -c_2 & \cdots & 0 & 0 & 0 \end{array}\]
A linha do objetivo armazena \(-\mathbf{c}^T\) (negativo porque escrevemos \(-z + \mathbf{c}^T x = 0\) e acompanhamos as melhorias levando \(-z\) em direção ao seu valor mais negativo, ou seja, maximizando \(z\)).
O algoritmo: três regras
Regra 1: variável que entra (coeficiente mais negativo)
Percorra a linha do objetivo. A variável não básica com o coeficiente mais negativo entra na base: trazê-la de zero para um valor positivo aumentará \(z\) o mais rápido possível. Se todos os coeficientes forem \(\geq 0\), a SVB atual é ótima.
Regra 2: variável que sai (teste da razão mínima)
Para a coluna de entrada, calcule a razão \(b_i / a_{i,\text{entr}}\) para cada linha \(i\) em que \(a_{i,\text{entr}} > 0\). A variável básica na linha com a menor razão sai da base. Essa razão é o quanto a variável de entrada pode aumentar antes que a variável básica atual naquela linha chegue a zero (seu limite inferior). Tomar o mínimo garante que permanecemos viáveis.
Se nenhuma razão for positiva (todos os \(a_{i,\text{entr}} \leq 0\)), a PL é ilimitada: a variável de entrada pode crescer sem limite.
Regra 3: operação de pivô
O elemento na interseção da coluna de entrada e da linha de saída é o elemento pivô. Divida a linha pivô pelo elemento pivô para torná-lo igual a 1. Em seguida, use operações de linha para eliminar a variável de entrada de todas as outras linhas, incluindo a linha do objetivo. Atualize o rótulo da base.
Repita até que a condição de otimalidade seja atendida.
Exemplo completo: duas iterações
Maximizar \(z = 5x_1 + 4x_2\) sujeito a:
\[x_1 + 2x_2 \leq 8, \qquad 2x_1 + x_2 \leq 10, \qquad x_1, x_2 \geq 0\]
Tableau inicial (SVB: \(x_1=x_2=0\), \(s_1=8\), \(s_2=10\), \(z=0\)):
\[\begin{array}{c|cccc|c} \text{Base} & x_1 & x_2 & s_1 & s_2 & \text{LD} \\\hline s_1 & 1 & 2 & 1 & 0 & 8 \\ s_2 & \mathbf{2} & 1 & 0 & 1 & 10 \\\hline -z & -5 & -4 & 0 & 0 & 0 \end{array}\]
Iteração 1:
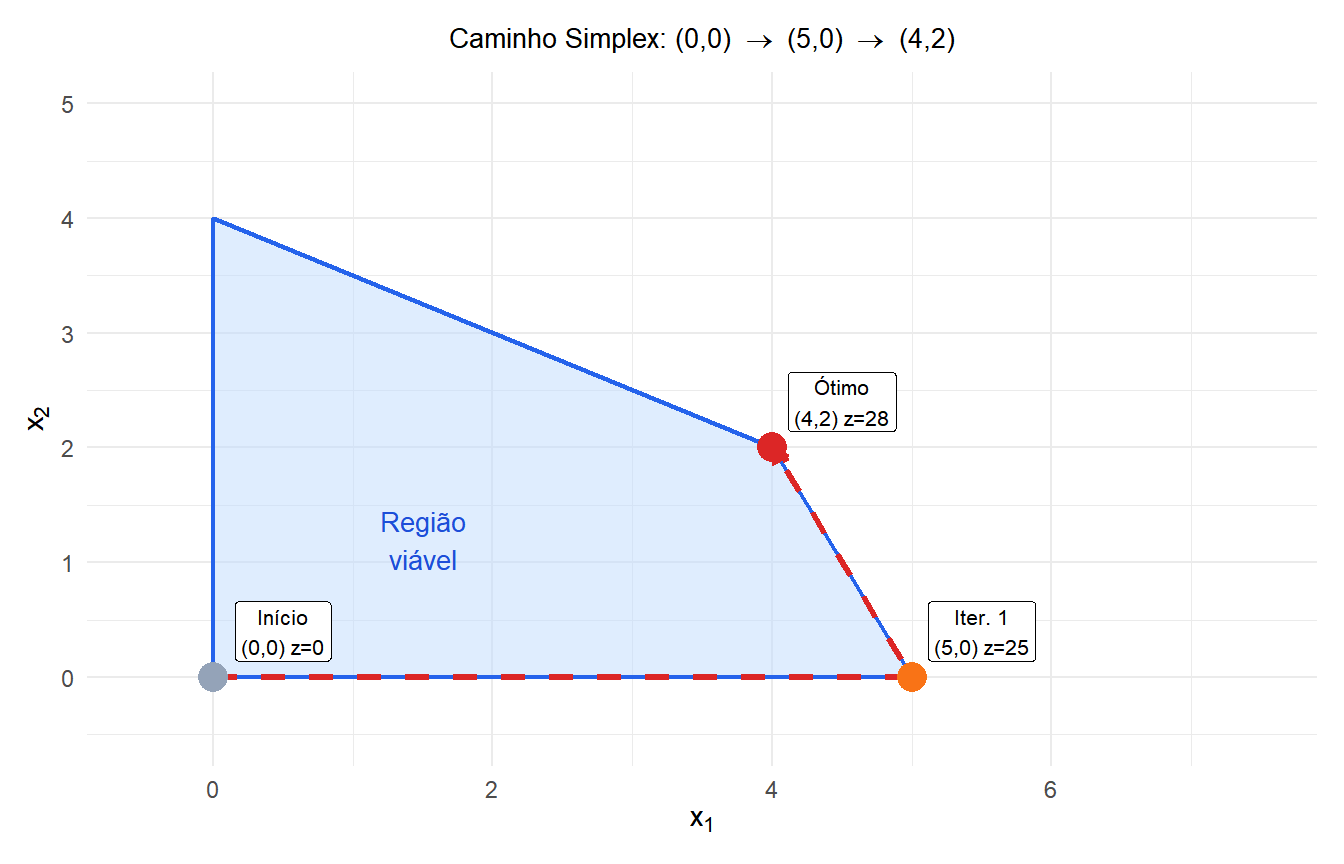
Entra: \(x_1\) (mais negativo: \(-5\)). Razões: \(8/1 = 8\), \(10/2 = 5\). O mínimo é 5, então \(s_2\) sai. Elemento pivô: 2 (linha 2, coluna \(x_1\)).
Divida a linha 2 por 2. Elimine \(x_1\) da linha 1 (subtraindo \(1 \times\) a nova linha 2) e da linha do objetivo (somando \(5 \times\) a nova linha 2):
\[\begin{array}{c|cccc|c} \text{Base} & x_1 & x_2 & s_1 & s_2 & \text{LD} \\\hline s_1 & 0 & \mathbf{1,5} & 1 & -0,5 & 3 \\ x_1 & 1 & 0,5 & 0 & 0,5 & 5 \\\hline -z & 0 & -1,5 & 0 & 2,5 & 25 \end{array}\]
SVB: \(x_1=5\), \(x_2=0\), \(s_1=3\), \(z=25\). Coeficiente do objetivo \(-1,5 < 0\): ainda não é ótimo.
Iteração 2:
Entra: \(x_2\) (único negativo: \(-1,5\)). Razões: \(3/1,5 = 2\), \(5/0,5 = 10\). O mínimo é 2, então \(s_1\) sai. Elemento pivô: 1,5.
Divida a linha 1 por 1,5. Elimine \(x_2\) da linha 2 e da linha do objetivo:
\[\begin{array}{c|cccc|c} \text{Base} & x_1 & x_2 & s_1 & s_2 & \text{LD} \\\hline x_2 & 0 & 1 & 2/3 & -1/3 & 2 \\ x_1 & 1 & 0 & -1/3 & 2/3 & 4 \\\hline -z & 0 & 0 & 1 & 2 & 28 \end{array}\]
Todos os coeficientes do objetivo \(\geq 0\). Solução ótima: \(x_1 = 4\), \(x_2 = 2\), \(z = 28\).
Encontrando uma SVB inicial: o método Big M
A origem (\(x = 0\), \(s = \mathbf{b}\)) é uma SVB inicial válida apenas quando todos os \(b_i \geq 0\). Se algumas restrições forem do tipo \(\geq\) ou \(=\), apenas as variáveis de folga não dão uma SVB. O método Big M adiciona variáveis artificiais \(a_i \geq 0\) a essas linhas e as penaliza fortemente no objetivo:
\[\max z = \mathbf{c}^T x - M \sum_i a_i\]
em que \(M\) é um número muito grande. A SVB inicial usa as variáveis artificiais como base. Se a PL é viável, o Simplex levará todos os \(a_i\) a zero. Se algum \(a_i > 0\) na otimalidade, a PL original é inviável.
Maximizar \(z = 3x_1 + 2x_2\) sujeito a \(x_1 + x_2 = 4\), \(x_1, x_2 \geq 0\).
A restrição de igualdade não tem variável de folga. Adicione a variável artificial \(a_1\):
\[\max z = 3x_1 + 2x_2 - M a_1 \qquad x_1 + x_2 + a_1 = 4, \quad a_1 \geq 0\]
SVB inicial: \(x_1 = x_2 = 0\), \(a_1 = 4\). O Simplex vai pivotear \(a_1\) para fora e encontrar o ótimo \(x_1 = 4\), \(x_2 = 0\), \(z = 12\).

Uma alternativa é o método das Duas Fases: a Fase I minimiza \(\sum a_i\) para encontrar uma SVB viável (ignorando o objetivo original); a Fase II então otimiza o objetivo original a partir dessa SVB.
Preços sombra e análise de sensibilidade
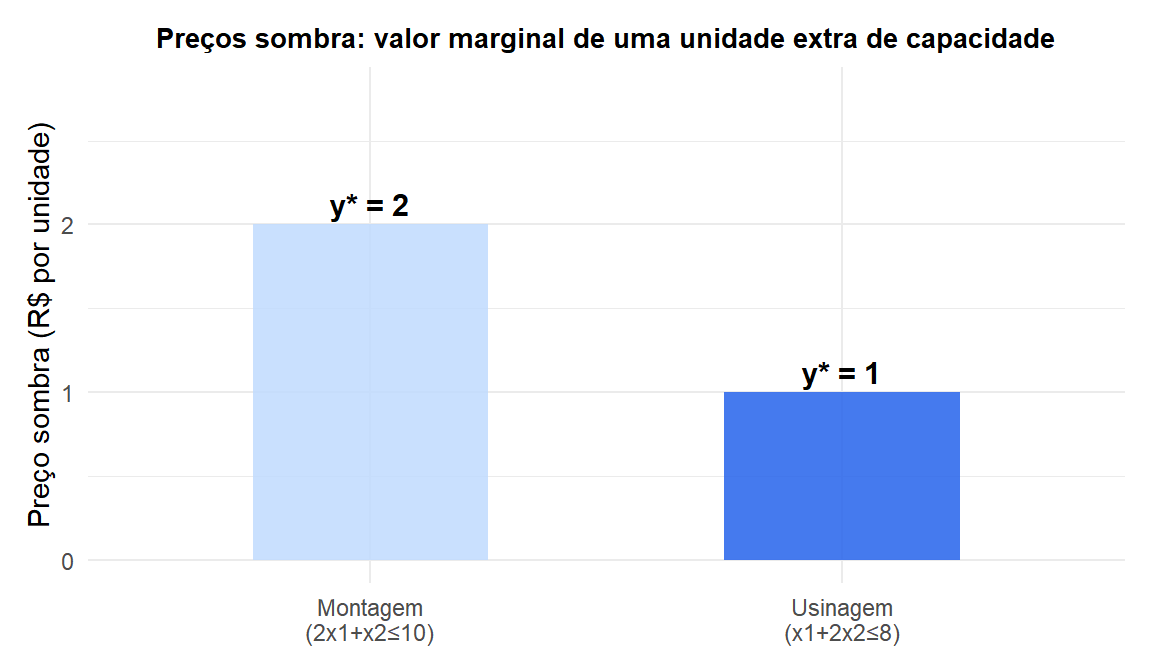
O tableau final contém mais informação do que apenas a solução ótima. Os coeficientes da linha do objetivo para as variáveis de folga são os preços sombra (variáveis duais) \(y_i^*\): eles medem o quanto \(z\) aumenta por unidade de aumento no lado direito \(b_i\).
A partir do tableau final acima: o coeficiente de \(s_1\) é 1 e o coeficiente de \(s_2\) é 2. Então:
- Relaxar a restrição 1 (\(x_1 + 2x_2 \leq 8\)) em 1 unidade aumenta o \(z\) ótimo em R$1.
- Relaxar a restrição 2 (\(2x_1 + x_2 \leq 10\)) em 1 unidade aumenta o \(z\) ótimo em R$2.
A restrição 2 (montagem) é mais valiosa: adicionar uma hora de capacidade de montagem vale o dobro de adicionar uma hora de capacidade de usinagem.
Preços sombra são válidos apenas dentro de uma faixa de mudanças em \(b_i\) (a análise de faixa do lado direito). Além dessa faixa, a base ótima muda e uma nova execução do Simplex é necessária.
Degenerescência e ciclagem
Uma SVB é degenerada se uma ou mais variáveis básicas forem iguais a zero. Em um vértice degenerado, um pivô pode deixar o valor do objetivo inalterado (um pivô degenerado). Em casos raros, isso causa ciclagem: o algoritmo revisita a mesma SVB repetidamente sem terminar.
A regra de Bland evita a ciclagem: entre todas as variáveis de entrada elegíveis, escolha a de menor índice; entre todas as variáveis de saída elegíveis, escolha a de menor índice. Isso garante o término ao custo de uma convergência possivelmente mais lenta. Na prática, a ciclagem é extremamente rara e a maioria das implementações usa métodos de perturbação em vez disso.
Simplex vs métodos de ponto interior
| Simplex | Ponto interior (Karmarkar) | |
|---|---|---|
| Caminho | Ao longo de vértices e arestas | Através do interior da região viável |
| Complexidade no pior caso | Exponencial | Polinomial |
| Desempenho prático | Muito rápido (geralmente \(O(m)\) pivôs) | Competitivo para PLs muito grandes |
| Warm starting | Fácil (reutilizar base) | Mais difícil |
| Análise de sensibilidade | Direta a partir do tableau final | Exige cálculo extra |
| Melhor para | PLs médias, reotimização, branch-and-bound em MIP | PLs muito grandes (\(> 10^6\) variáveis) |
Solvers modernos (Gurobi, CPLEX, HiGHS) implementam ambos e alternam automaticamente com base no tamanho e na estrutura do problema.
⚠️ O Simplex pode ser exponencialmente lento em entradas adversariais
Klee e Minty (1972) construíram uma família de PLs com \(n\) variáveis em que o Simplex padrão visita todos os \(2^n\) vértices. O problema se parece com um hipercubo distorcido. No entanto, essas entradas adversariais nunca surgem em aplicações do mundo real. Para problemas práticos, o Simplex é notavelmente rápido apesar da garantia de pior caso. Se você encontrar uma execução do Simplex que não termina rapidamente, suspeite de degenerescência ou escalonamento ruim, em vez de estrutura adversarial.
💡 Simplex em R
library(lpSolve)

obj <- c(5, 4)
mat <- matrix(c(1, 2, 2, 1), nrow=2, byrow=TRUE)
rhs <- c(8, 10)
dir <- c("<=", "<=")

sol <- lp("max", obj, mat, dir, rhs, compute.sens=TRUE)
sol$solution        # x1=4, x2=2
sol$objval          # 28
sol$duals           # shadow prices: c(1, 2, 0, 0)
sol$sens.coef.from  # lower range for obj coefficients
sol$sens.coef.to    # upper range for obj coefficients
Para problemas maiores, o solver HiGHS (via o pacote highs) é mais rápido e robusto do que o lpSolve.

