Método de Newton e BFGS
O método de Newton usa informação de segunda ordem (a matriz Hessiana) para dar passos curvos em direção ao ótimo, alcançando convergência quadrática: o número de dígitos corretos aproximadamente dobra a cada iteração. O BFGS aproxima a Hessiana apenas a partir de informação de gradiente, obtendo convergência próxima à de Newton sem o custo \(O(n^3)\) de inverter uma matriz densa.
O método de Newton
A descida do gradiente usa apenas o gradiente: ela se move na direção de maior descida com um tamanho de passo fixo. Isso ignora a curvatura de \(f\): em direções onde a função se curva acentuadamente, o passo é grande demais e o algoritmo oscila; em direções planas, ele é pequeno demais.
O método de Newton ajusta uma aproximação quadrática local de \(f\) em \(x_k\) usando a expansão de Taylor de segunda ordem:
\[f(x) \approx f(x_k) + \nabla f(x_k)^T(x - x_k) + \frac{1}{2}(x-x_k)^T \nabla^2 f(x_k)(x-x_k)\]
Minimizar essa quadrática em \(x\) dá o passo de Newton:
\[x_{k+1} = x_k - \left[\nabla^2 f(x_k)\right]^{-1} \nabla f(x_k)\]
\[p_k = -H_k^{-1} g_k \qquad \text{em que } H_k = \nabla^2 f(x_k),\; g_k = \nabla f(x_k)\]
A Hessiana \(H_k\) escala o gradiente pela curvatura local: em direções acentuadas (autovalores grandes de \(H_k\)), o passo é pequeno; em direções planas (autovalores pequenos), o passo é grande. Isso adapta automaticamente o tamanho do passo à geometria de \(f\).
Convergência quadrática
Perto de um mínimo local não degenerado \(x^*\) em que \(H^* = \nabla^2 f(x^*)\) é positiva definida, o método de Newton converge quadraticamente:
\[\|x_{k+1} - x^*\| \leq C \|x_k - x^*\|^2\]
para alguma constante \(C > 0\). Se o erro no passo \(k\) é \(\varepsilon\), o erro no passo \(k+1\) é aproximadamente \(C\varepsilon^2\). Isso significa que o número de dígitos decimais corretos dobra a cada iteração: se você tem 2 dígitos corretos, o próximo passo dá 4, depois 8, depois 16.
Compare com a convergência linear da descida do gradiente, \(\|x_{k+1} - x^*\| \leq \rho \|x_k - x^*\|\) para algum \(\rho < 1\): os erros diminuem por um fator constante, não ao quadrado.
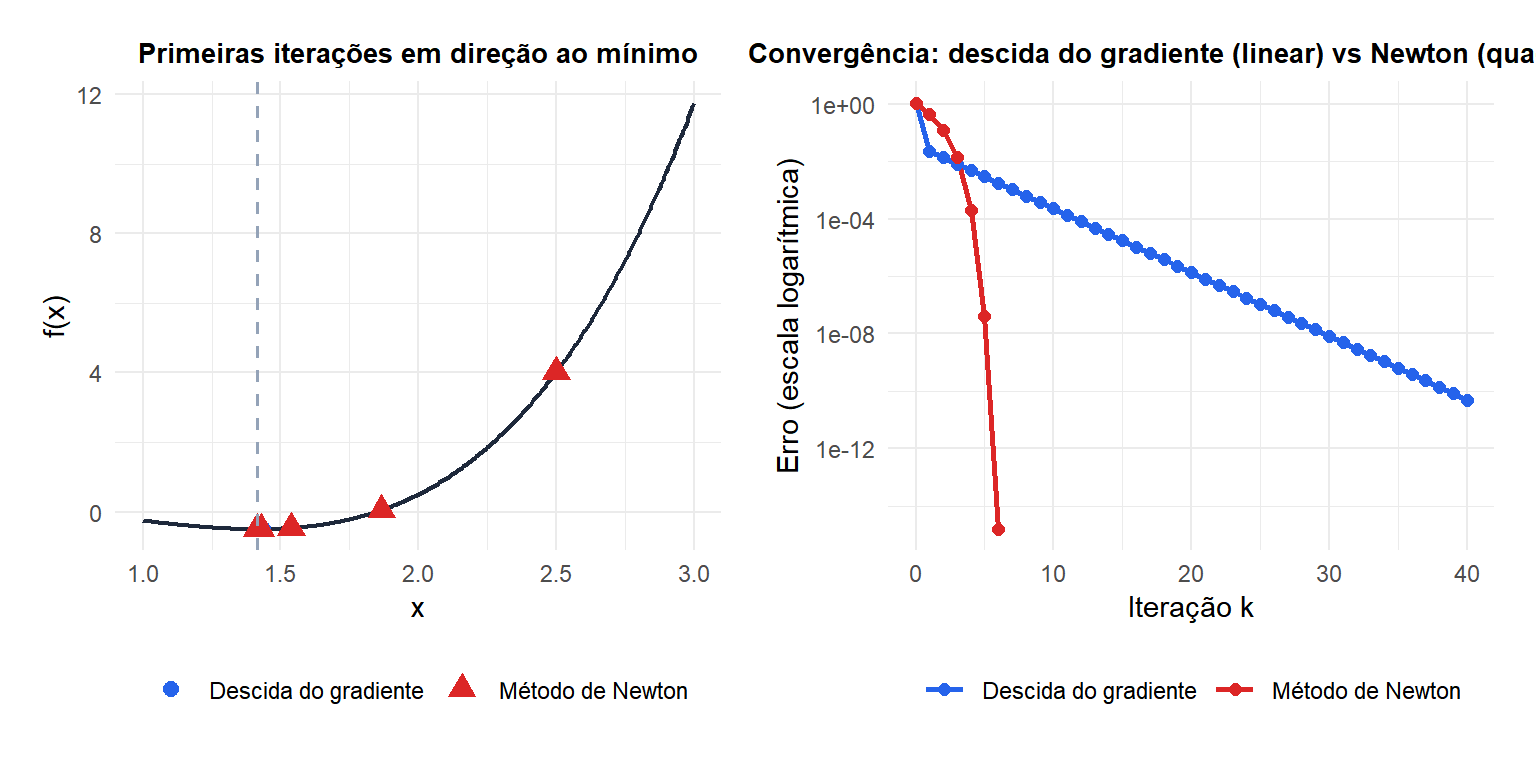
O método de Newton (vermelho) alcança a precisão da máquina em 6 iterações. A descida do gradiente (azul) ainda tem erro perceptível após 40 iterações.
Limitações do método de Newton
Apesar da convergência quadrática, o método de Newton tem três limitações práticas sérias:
Custo por iteração: calcular \(H_k\) exige \(O(n^2)\) entradas; resolver \(H_k p_k = -g_k\) exige \(O(n^3)\) operações (fatoração LU ou Cholesky). Para \(n = 10^4\) parâmetros (uma rede neural pequena), isso é \(10^{12}\) operações por passo: completamente impraticável.
Indefinição da Hessiana: longe do ótimo, \(H_k\) pode não ser positiva definida. O passo de Newton \(p_k = -H_k^{-1}g_k\) pode então apontar morro acima. Métodos de Newton modificados adicionam um termo de regularização: \(p_k = -(H_k + \lambda_k I)^{-1}g_k\) com \(\lambda_k\) escolhido para garantir positividade definida (estratégia de Levenberg-Marquardt).
Convergência é apenas local: a convergência quadrática é garantida apenas perto de \(x^*\). Partindo de longe, o método de Newton pode divergir ou ciclar. Sempre combine com uma busca em linha ou região de confiança para garantir convergência global.
⚠️ Passos de Newton podem divergir sem salvaguardas
Um passo de Newton puro sem busca em linha pode ultrapassar o mínimo e divergir, especialmente quando a Hessiana é quase singular ou indefinida. Na prática, o método de Newton é sempre implementado com uma busca em linha com retrocesso (reduzir o tamanho do passo até que uma redução suficiente seja alcançada) ou uma região de confiança (restringir a norma do passo a uma bola onde a aproximação quadrática é confiável).
Métodos quase-Newton
Métodos quase-Newton aproximam a Hessiana (ou sua inversa) a partir de diferenças de gradiente, evitando o cálculo explícito de derivadas de segunda ordem. Eles alcançam convergência superlinear: mais lenta do que a quadrática de Newton, mas muito mais rápida do que a convergência linear da descida do gradiente.
A ideia-chave: usar a mudança no gradiente entre iterados sucessivos para atualizar a aproximação da Hessiana. Se \(s_k = x_{k+1} - x_k\) e \(y_k = g_{k+1} - g_k\), a aproximação atualizada da Hessiana \(B_{k+1}\) deve satisfazer a condição secante:
\[B_{k+1} s_k = y_k\]
Isso garante que a aproximação seja consistente com a curvatura observada na direção do último passo.
Atualização BFGS
A atualização Broyden-Fletcher-Goldfarb-Shanno (BFGS) é o método quase-Newton mais bem-sucedido. Ela atualiza a aproximação da Hessiana inversa \(H_k^{-1} \approx B_k^{-1}\) diretamente:
\[B_{k+1}^{-1} = \left(I - \rho_k s_k y_k^T\right) B_k^{-1} \left(I - \rho_k y_k s_k^T\right) + \rho_k s_k s_k^T\]
\[\rho_k = \frac{1}{y_k^T s_k}\]
A atualização BFGS é uma atualização de posto 2 (rank-2) da Hessiana inversa: ela adiciona informação do passo atual e da mudança no gradiente. Propriedades-chave:
- Preserva a simetria: \(B_{k+1}^{-1}\) é simétrica se \(B_k^{-1}\) for.
- Preserva a positividade definida (quando \(y_k^T s_k > 0\), garantido por uma busca em linha de Wolfe).
- Exige apenas \(O(n^2)\) de armazenamento e \(O(n^2)\) operações por atualização.
- Converge superlinearmente: \(\|x_{k+1} - x^*\| = o(\|x_k - x^*\|)\), significando que a própria taxa de convergência melhora a cada passo.
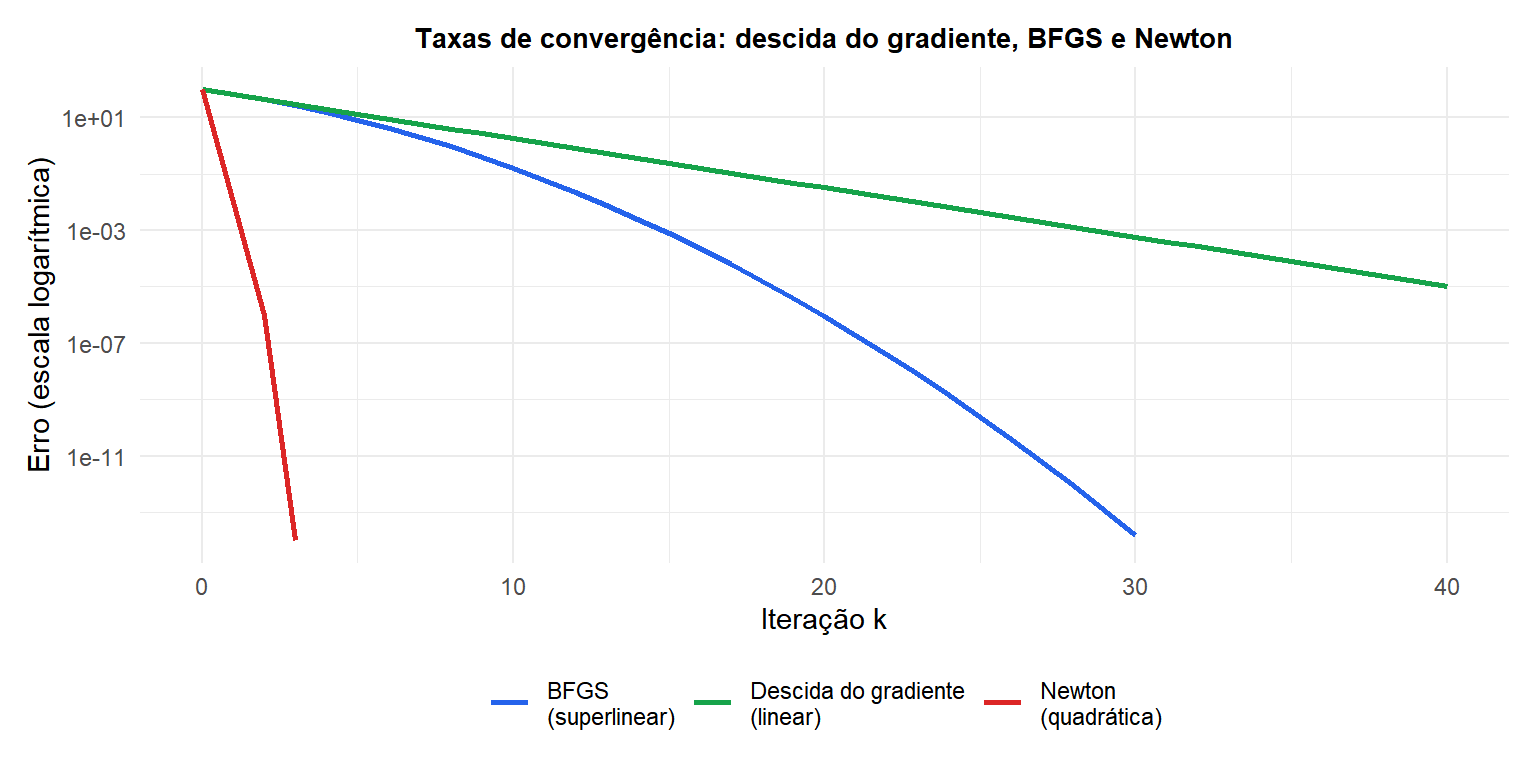
O BFGS (azul) fica entre a descida do gradiente (verde, linear lenta) e Newton (vermelho, quadrática): ele converge muito mais rápido do que a descida do gradiente sem o custo \(O(n^3)\) de Newton.
L-BFGS: quase-Newton em larga escala
O BFGS armazena a aproximação completa \(n \times n\) da Hessiana inversa, exigindo \(O(n^2)\) de memória. Para \(n = 10^6\) parâmetros (um modelo típico de deep learning), isso é completamente inviável.
O BFGS de memória limitada (L-BFGS) armazena apenas os últimos \(m\) pares de curvatura \(\{(s_k, y_k)\}_{k=t-m}^{t-1}\) (tipicamente \(m = 5\) a 20) e representa implicitamente a aproximação da Hessiana através desses pares. O produto matriz-vetor \(B_k^{-1} g_k\) é calculado por meio de uma recursão de dois laços em tempo \(O(mn)\) e memória \(O(mn)\).
O L-BFGS é o algoritmo padrão para otimização suave irrestrita em larga escala. Ele é usado em regressão logística, ajuste de processos gaussianos, e muitas aplicações de machine learning em que a Hessiana é grande demais para armazenar.
| Método | Convergência | Custo/iteração | Memória | Melhor para |
|---|---|---|---|---|
| Descida do gradiente | Linear | \(O(n)\) | \(O(n)\) | \(n\) muito grande, não suave |
| BFGS | Superlinear | \(O(n^2)\) | \(O(n^2)\) | \(n\) médio (\(\leq 10^4\)) |
| L-BFGS | Superlinear | \(O(mn)\) | \(O(mn)\) | \(n\) grande (\(> 10^4\)) |
| Newton | Quadrática | \(O(n^3)\) | \(O(n^2)\) | \(n\) pequeno (\(\leq 10^3\)), Hessiana exata disponível |
Busca em linha e as condições de Wolfe
Todos os métodos quase-Newton exigem uma busca em linha a cada passo para escolher o tamanho do passo \(\alpha_k\). As condições de Wolfe são o padrão:
Redução suficiente (Armijo): \(f(x_k + \alpha_k p_k) \leq f(x_k) + c_1 \alpha_k g_k^T p_k\)
Condição de curvatura: \(g(x_k + \alpha_k p_k)^T p_k \geq c_2 g_k^T p_k\)
com \(0 < c_1 < c_2 < 1\) (tipicamente \(c_1 = 10^{-4}\), \(c_2 = 0,9\)). A condição de curvatura garante \(y_k^T s_k > 0\), exigido para que o BFGS mantenha a positividade definida da aproximação da Hessiana.
💡 Newton e BFGS em R
# optim() implements BFGS and L-BFGS-B
f      <- function(x) x[1]^4/4 - x[1]^2 + x[2]^2
grad_f <- function(x) c(x[1]^3 - 2*x[1], 2*x[2])

# BFGS
optim(c(2, 1), f, grad_f, method="BFGS")

# L-BFGS-B (with box constraints)
optim(c(2, 1), f, grad_f, method="L-BFGS-B",
      lower=c(-Inf,-Inf), upper=c(Inf,Inf))

# Newton's method via nlm()
nlm(f, c(2, 1), hessian=TRUE)

# For constrained problems: nloptr with BFGS
library(nloptr)
nloptr(x0=c(2,1), eval_f=f, eval_grad_f=grad_f,
       opts=list(algorithm="NLOPT_LD_LBFGS"))
Na prática, sempre forneça o gradiente analiticamente quando disponível: a diferenciação numérica é mais lenta e menos precisa.

