Programação dinâmica
A programação dinâmica (PD) resolve problemas de otimização dividindo-os em subproblemas sobrepostos, resolvendo cada subproblema uma vez, e armazenando o resultado. Ela converte algoritmos recursivos de tempo exponencial em algoritmos de tempo polinomial. O insight-chave: se a solução ótima geral pode ser construída a partir de soluções ótimas de subproblemas, a PD se aplica.
Duas condições para a programação dinâmica
A PD funciona quando um problema tem duas propriedades:
1. Subestrutura ótima
A solução ótima do problema contém soluções ótimas de seus subproblemas. Esse é o princípio da otimalidade de Bellman: uma política ótima tem a propriedade de que, quaisquer que sejam o estado inicial e a decisão, as decisões restantes devem constituir uma política ótima em relação ao estado resultante da primeira decisão.
Se você pode construir a solução ótima do problema inteiro a partir de soluções ótimas de instâncias menores, o problema tem subestrutura ótima.
2. Subproblemas sobrepostos
A solução recursiva resolve os mesmos subproblemas repetidamente. Isso é o que distingue a PD de dividir para conquistar (que também usa subestrutura ótima, mas tem subproblemas não sobrepostos, por exemplo, merge sort).
Se os mesmos subproblemas aparecem muitas vezes, armazenar suas soluções (memoização ou tabulação) evita cálculo redundante e reduz o tempo exponencial a polinomial.
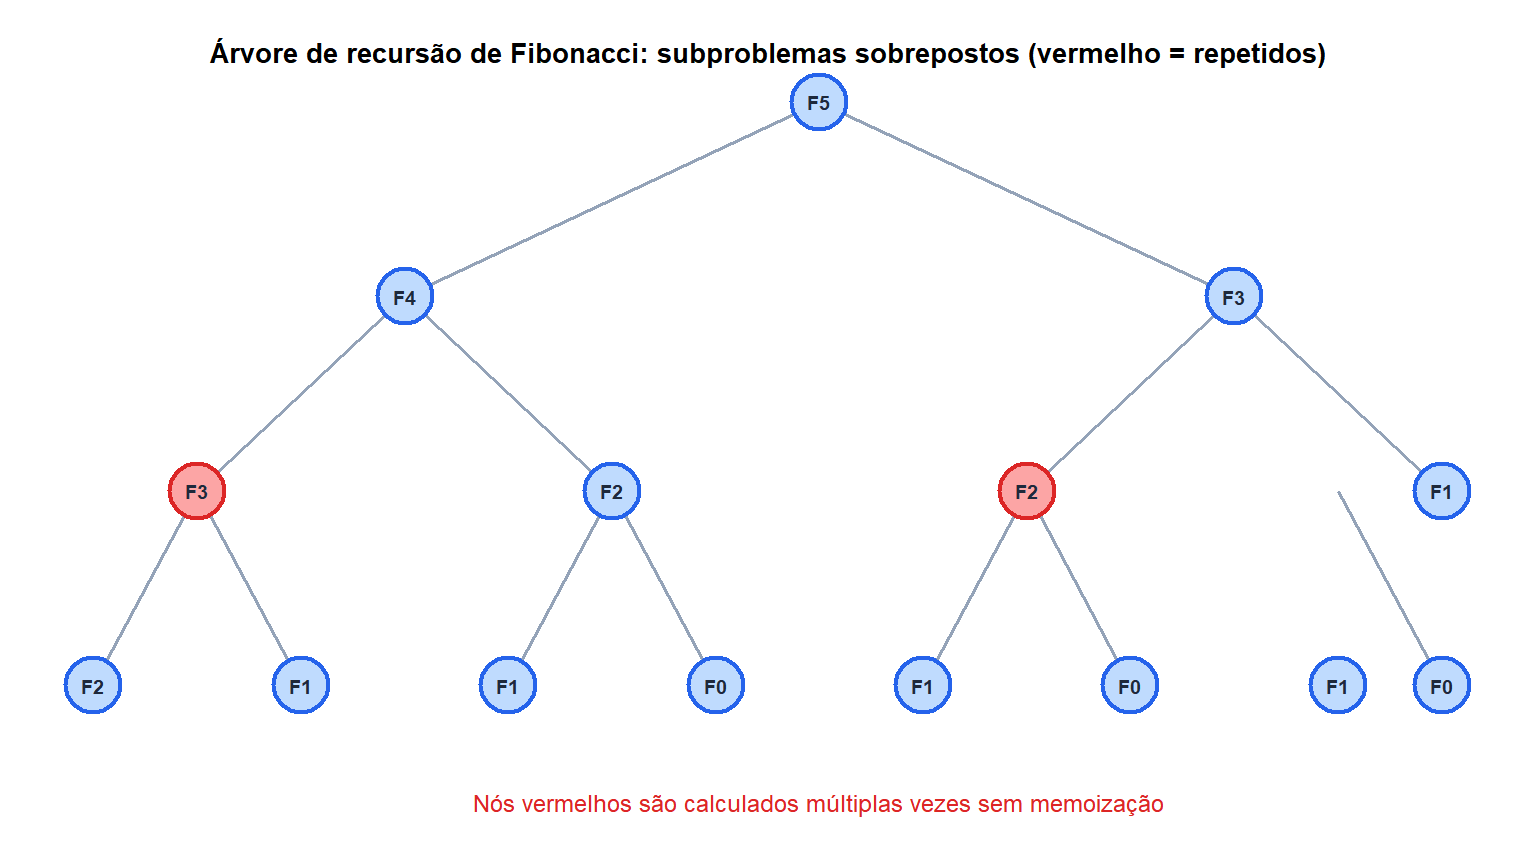
Sem memoização, calcular \(F_n\) leva \(O(2^n)\) tempo. Com memoização, cada um dos \(n\) subproblemas distintos é resolvido uma vez: \(O(n)\) tempo.
Top-down vs bottom-up
Existem duas formas equivalentes de implementar PD:
Top-down (memoização)
Escreva a solução recursiva naturalmente. Adicione um cache (tabela hash ou array) para armazenar resultados de subproblemas conforme são calculados. Antes de resolver um subproblema, verifique se seu resultado já está no cache.
memo <- c()
fib <- function(n) {
  if (n <= 1) return(n)
  if (!is.na(memo[n])) return(memo[n])
  result <- fib(n-1) + fib(n-2)
  memo[n] <<- result
  result
}
Vantagem: calcula apenas os subproblemas que são realmente necessários. Desvantagem: sobrecarga da pilha de chamadas recursivas; pode atingir limites de pilha para \(n\) grande.
Bottom-up (tabulação)
Preencha uma tabela de soluções de subproblemas em ordem do menor para o maior. Cada entrada é calculada usando entradas já preenchidas.
fib_dp <- function(n) {
  if (n <= 1) return(n)
  dp <- numeric(n+1)
  dp[1] <- 0; dp[2] <- 1
  for (i in 3:(n+1)) dp[i] <- dp[i-1] + dp[i-2]
  dp[n+1]
}
Vantagem: sem sobrecarga de recursão; naturalmente iterativa; mais fácil de analisar a complexidade de espaço. Desvantagem: calcula todos os subproblemas mesmo que alguns não sejam necessários.
Na prática, o bottom-up costuma ser preferido por sua simplicidade e eficiência.
Exemplo 1: mochila 0/1
\(n\) itens com valores \(v_i\) e pesos \(w_i\). Capacidade da mochila \(W\). Maximizar o valor total sujeito ao limite de peso. Cada item é levado (1) ou não (0).
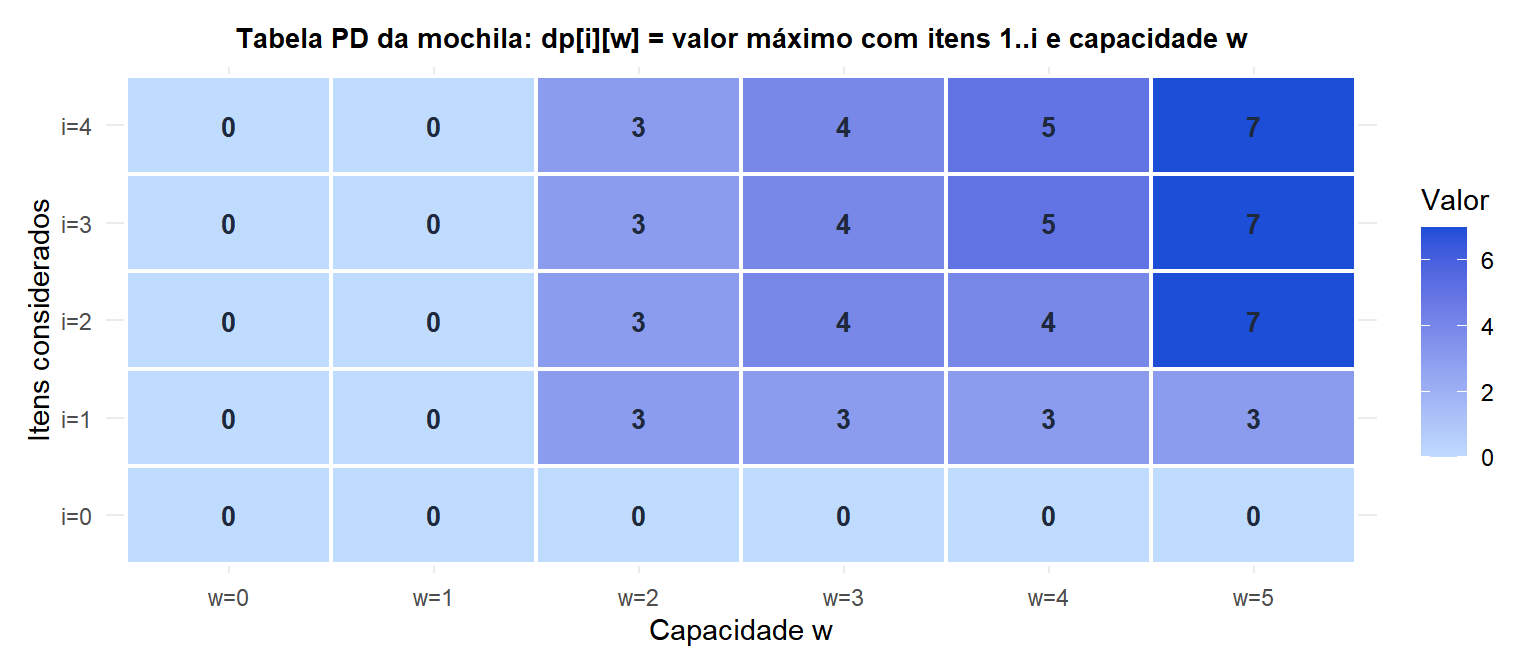
Subestrutura: defina \(dp[i][w]\) = valor máximo usando os itens \(1,\ldots,i\) com capacidade \(w\).
Recorrência:
\[dp[i][w] = \begin{cases} dp[i-1][w] & \text{se } w_i > w \text{ (o item } i \text{ não cabe)} \\ \max(dp[i-1][w],\; v_i + dp[i-1][w-w_i]) & \text{caso contrário} \end{cases}\]
Caso base: \(dp[0][w] = 0\) para todo \(w\) (nenhum item, nenhum valor).
Complexidade de tempo: \(O(nW)\) (pseudopolinomial: polinomial em \(n\) e \(W\), mas exponencial no número de bits de \(W\)).
| Item | Valor | Peso |
|---|---|---|
| 1 | 3 | 2 |
| 2 | 4 | 3 |
| 3 | 5 | 4 |
| 4 | 6 | 5 |
Tabela PD \(dp[i][w]\):
| w=0 | w=1 | w=2 | w=3 | w=4 | w=5 | |
|---|---|---|---|---|---|---|
| i=0 | 0 | 0 | 0 | 0 | 0 | 0 |
| i=1 | 0 | 0 | 3 | 3 | 3 | 3 |
| i=2 | 0 | 0 | 3 | 4 | 4 | 7 |
| i=3 | 0 | 0 | 3 | 4 | 5 | 7 |
| i=4 | 0 | 0 | 3 | 4 | 5 | 7 |
Valor ótimo: \(dp[4][5] = 7\) (levar os itens 1 e 2: \(3+4=7\), \(2+3=5 \leq W\)).

Exemplo 2: Maior Subsequência Comum (LCS)
Dadas duas strings \(X = x_1\ldots x_m\) e \(Y = y_1\ldots y_n\), encontre a maior subsequência comum a ambas (não necessariamente contígua).
Subestrutura: defina \(dp[i][j]\) = comprimento da LCS de \(X[1..i]\) e \(Y[1..j]\).
Recorrência:
\[dp[i][j] = \begin{cases} 0 & i=0 \text{ ou } j=0 \\ dp[i-1][j-1] + 1 & x_i = y_j \\ \max(dp[i-1][j],\; dp[i][j-1]) & x_i \neq y_j \end{cases}\]
Tempo e espaço: \(O(mn)\) para ambos. A LCS em si é recuperada retrocedendo pela tabela.
Comprimento da LCS = 4 (por exemplo, BCAB ou BDAB). A tabela PD preenche \(O(7 \times 5) = 35\) células em vez de verificar todas as \(2^7 = 128\) subsequências de \(X\).
Conexão com Dijkstra
O algoritmo de Dijkstra é um caso especial de programação dinâmica. O caminho mais curto de \(s\) a \(v\) satisfaz:
\[d[v] = \min_{u: (u,v) \in E} \{d[u] + w(u,v)\}\]
Essa é uma recorrência de PD: o caminho mais curto até \(v\) é construído a partir do caminho mais curto até seu predecessor \(u\). A propriedade de subestrutura ótima vale porque qualquer subcaminho de um caminho mais curto é, ele próprio, um caminho mais curto.
A diferença em relação à PD genérica: Dijkstra explora a não negatividade dos pesos para processar subproblemas em ordem crescente de distância, evitando a necessidade de preencher uma tabela completa \(|V| \times |V|\).
De forma mais geral, caminhos mais curtos em DAGs (grafos acíclicos direcionados) podem ser resolvidos com uma PD simples em ordem topológica: \(O(V+E)\), mais rápido do que o \(O((V+E)\log V)\) de Dijkstra.
Quando a PD não se aplica
A programação dinâmica só funciona quando a propriedade de subestrutura ótima genuinamente vale, e é fácil assumir que ela vale quando não vale.
⚠️ A PD exige subestrutura ótima: nem todo problema a tem
O contraexemplo clássico: o caminho simples mais longo em um grafo geral. Diferentemente dos caminhos mais curtos, os caminhos mais longos não têm subestrutura ótima. Conhecer o caminho mais longo de \(s\) até um vértice intermediário \(u\) não ajuda a encontrar o caminho mais longo de \(s\) até \(v\) passando por \(u\): combinar dois caminhos longos pode criar um ciclo (visitando um vértice duas vezes), violando o requisito de caminho simples.
O caminho simples mais longo é NP-difícil em grafos gerais, enquanto o caminho mais curto é solucionável em tempo polinomial precisamente por causa da subestrutura ótima.
Antes de aplicar PD, verifique que a solução ótima do problema inteiro realmente depende apenas de soluções ótimas de subproblemas, sem interferência entre as soluções dos subproblemas.
Complexidade e a maldição da dimensionalidade
A PD troca tempo por espaço: ela armazena soluções de todos os subproblemas. O espaço de estados determina tanto a complexidade de tempo quanto a de espaço. Para uma PD com \(k\) variáveis de estado, cada uma assumindo \(O(n)\) valores, a tabela tem \(O(n^k)\) entradas: exponencial no número de variáveis de estado.
Essa é a maldição da dimensionalidade em PD: adicionar uma variável de estado multiplica o tamanho da tabela por \(n\). Para espaços de estado contínuos (controle estocástico, aprendizado por reforço), a tabela é infinita e aproximações são necessárias.
Estratégias práticas para gerenciar o espaço de estados: arrays rolantes (manter apenas a última linha da tabela PD), compensações espaço-tempo, compressão de estado para PD com máscara de bits.
💡 Programação dinâmica em R
# 0/1 Knapsack
knapsack_dp <- function(values, weights, W) {
  n  <- length(values)
  dp <- matrix(0, nrow=n+1, ncol=W+1)
  for (i in 1:n) {
    for (w in 1:W) {
      dp[i+1, w+1] <- dp[i, w+1]
      if (weights[i] <= w)
        dp[i+1, w+1] <- max(dp[i+1, w+1],
                            values[i] + dp[i, w-weights[i]+1])
    }
  }
  list(value=dp[n+1, W+1], table=dp)
}

knapsack_dp(c(3,4,5,6), c(2,3,4,5), W=5)$value  # 7

# LCS length
lcs_length <- function(X, Y) {
  m <- nchar(X); n <- nchar(Y)
  X <- strsplit(X,"")[[1]]; Y <- strsplit(Y,"")[[1]]
  dp <- matrix(0, m+1, n+1)
  for (i in 1:m) for (j in 1:n)
    dp[i+1,j+1] <- if(X[i]==Y[j]) dp[i,j]+1 else max(dp[i,j+1],dp[i+1,j])
  dp[m+1,n+1]
}

lcs_length("ABCBDAB", "BDCAB")  # 4
