Filtro de Kalman
O filtro de Kalman é um algoritmo recursivo que estima o estado oculto de um sistema dinâmico a partir de observações ruidosas. Ele é ótimo sob suposições gaussianas: nenhum outro estimador linear tem erro quadrático médio menor. Originalmente desenvolvido para navegação aeroespacial, hoje é central em econometria, processamento de sinais, robótica e análise de séries temporais.
O modelo em espaço de estados
O filtro de Kalman opera sobre sistemas descritos por duas equações:
\[\alpha_{t+1} = T_t \alpha_t + R_t \eta_t \qquad \text{(equação de transição)}\]
\[y_t = Z_t \alpha_t + \varepsilon_t \qquad \text{(equação de observação)}\]
em que:
- \(\alpha_t\): o vetor de estado (não observado). Contém as quantidades que queremos estimar: posição, nível, tendência, componentes sazonais.
- \(y_t\): a observação (medida ruidosa de \(\alpha_t\)).
- \(T_t\): matriz de transição que governa como o estado evolui ao longo do tempo.
- \(Z_t\): matriz de observação que vincula o estado à observação.
- \(\eta_t \sim N(0, Q_t)\): ruído de estado (ruído de processo).
- \(\varepsilon_t \sim N(0, H_t)\): ruído de observação (ruído de medição).
- \(\eta_t\) e \(\varepsilon_t\) são mutuamente independentes.
A razão \(Q/H\) controla o equilíbrio entre confiar na dinâmica do modelo (\(Q\) grande) e confiar nas observações (\(H\) grande).
O algoritmo de previsão-atualização
O filtro de Kalman é executado recursivamente em cada instante \(t\):
Previsão (propagar o estado para frente usando a equação de transição):
\[\hat{\alpha}_{t|t-1} = T_t \hat{\alpha}_{t-1|t-1}\]
\[P_{t|t-1} = T_t P_{t-1|t-1} T_t' + R_t Q_t R_t'\]
Atualização (incorporar a nova observação \(y_t\)):
\[v_t = y_t - Z_t \hat{\alpha}_{t|t-1} \qquad \text{(inovação)}\]
\[F_t = Z_t P_{t|t-1} Z_t' + H_t \qquad \text{(variância da inovação)}\]
\[K_t = P_{t|t-1} Z_t' F_t^{-1} \qquad \text{(ganho de Kalman)}\]
\[\hat{\alpha}_{t|t} = \hat{\alpha}_{t|t-1} + K_t v_t\]
\[P_{t|t} = (I - K_t Z_t) P_{t|t-1}\]
O ganho de Kalman \(K_t\) controla quanto peso dar à nova observação em relação à previsão:
- \(K_t \to 0\) (\(H_t\) pequeno, \(Q_t\) grande): confia no modelo; ignora a nova observação.
- \(K_t \to 1\) (\(H_t\) grande, \(Q_t\) pequeno): confia na observação; atualiza fortemente o estado.
A inovação \(v_t = y_t - Z_t\hat{\alpha}_{t|t-1}\) é o erro de previsão de um passo. Sob o modelo correto, as inovações são ruído branco com variância \(F_t\).
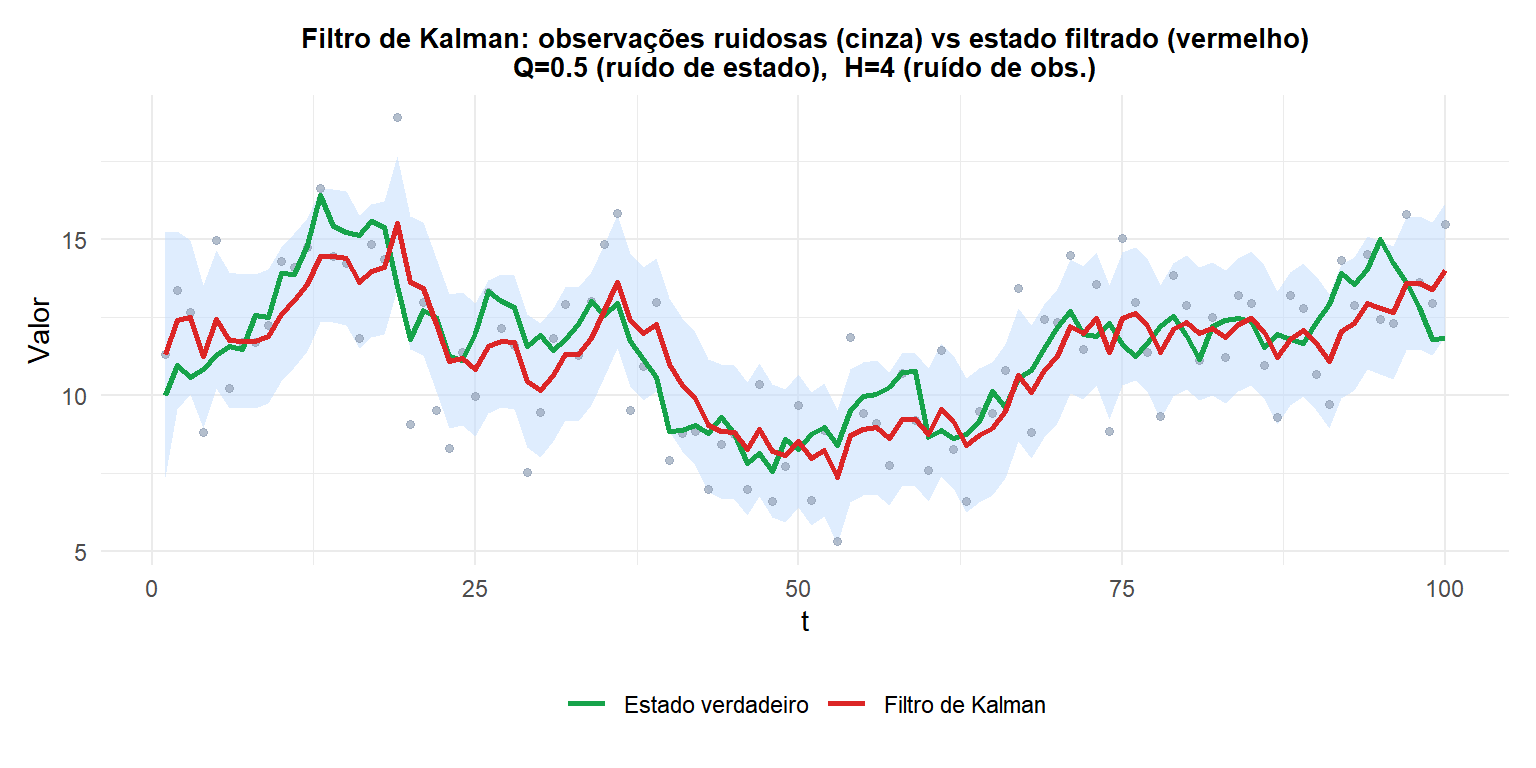
Pontos cinzas: observações ruidosas. Verde: estado subjacente verdadeiro (passeio aleatório). Vermelho: estimativa do filtro de Kalman com faixa de incerteza de 95%. O filtro acompanha de perto o estado verdadeiro, mesmo com ruído de observação elevado.
A compensação Q/H
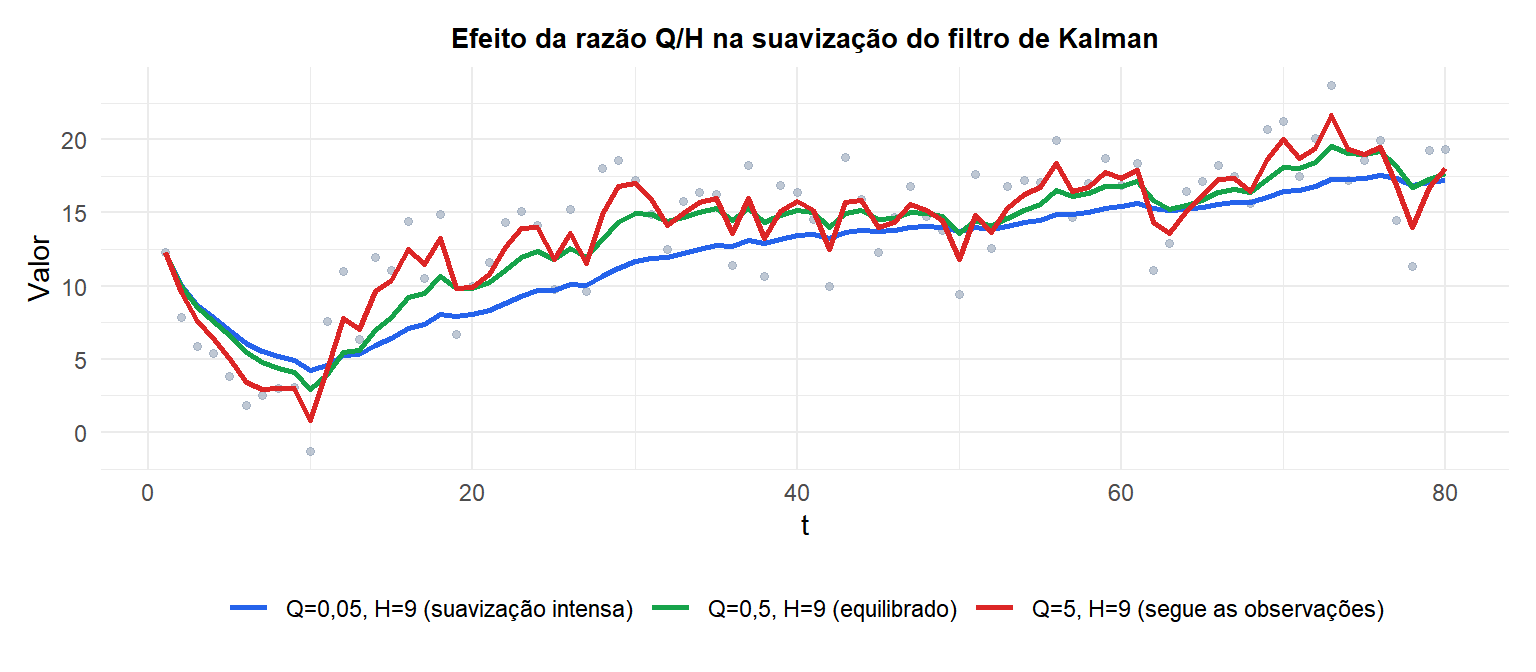
Q/H baixo (azul) produz suavização intensa: o filtro é lento para reagir a mudanças. Q/H alto (vermelho) acompanha de perto as observações. Os valores ótimos de Q e H são estimados a partir dos dados por máxima verossimilhança.
Conexão com o ARIMA
Todo modelo ARIMA tem uma representação exata em espaço de estados. Por exemplo, ARIMA(1,1,1):
\[\alpha_t = \begin{pmatrix}\mu_t \\ b_t\end{pmatrix}, \quad T = \begin{pmatrix}1 & 1 \\ 0 & 1\end{pmatrix}, \quad Z = \begin{pmatrix}1 & 0\end{pmatrix}\]
Isso permite ajustar modelos ARIMA usando o filtro de Kalman, que lida com:
- Dados faltantes: a etapa de atualização é simplesmente pulada quando \(y_t\) está faltando.
- Cálculo exato da verossimilhança: as inovações \(v_t\) e suas variâncias \(F_t\) dão diretamente a log-verossimilhança gaussiana: \(\ell = -\frac{1}{2}\sum_t (\log F_t + v_t^2/F_t)\).
- Inicialização não estacionária: priores difusos lidam com componentes \(I(1)\) ou \(I(2)\) sem a necessidade de pré-diferenciação.
As funções stats::arima() e forecast::Arima() do R usam o filtro de Kalman internamente.
Filtragem, suavização e previsão
O filtro de Kalman produz três tipos de estimativas de estado:
- Estimativa filtrada \(\hat{\alpha}_{t|t}\): usa todos os dados até \(t\). Estimativa em tempo real.
- Estimativa suavizada \(\hat{\alpha}_{t|T}\): usa todos os dados até \(T > t\). Retrospectiva; sempre mais precisa do que a filtrada.
- Previsão \(\hat{\alpha}_{t+h|t}\): projeta para frente a partir de \(t\) usando apenas a equação de transição.
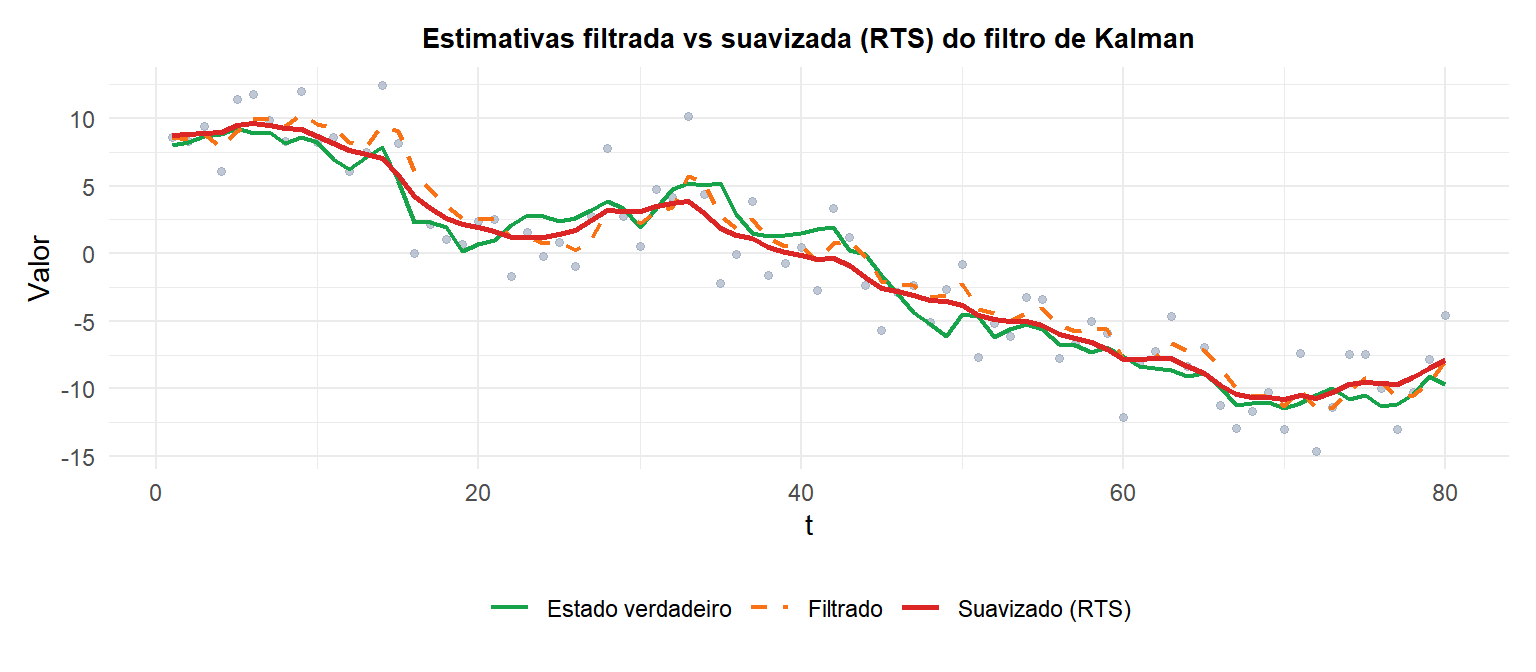
A estimativa suavizada (vermelho) está sempre mais próxima do estado verdadeiro do que a estimativa filtrada (laranja), porque ela usa todas as \(T\) observações, não apenas as disponíveis até \(t\).
⚠️ Q e H mal especificados levam a uma filtragem ruim
O filtro de Kalman é ótimo apenas quando \(Q\) e \(H\) estão corretamente especificados. Problemas comuns:
- Q muito pequeno: o filtro fica excessivamente confiante em suas previsões e lento para acompanhar mudanças reais no estado.
- H muito pequeno: o filtro confia demais nas observações, produzindo estimativas ruidosas que seguem cada flutuação de medição.
- Ambos mal especificados: a sequência de inovações \(v_t\) não será ruído branco. Sempre verifique a ACF das inovações após o ajuste.
Estime \(Q\) e \(H\) por máxima verossimilhança (maximizando \(\ell = -\frac{1}{2}\sum_t (\log F_t + v_t^2/F_t)\)) usando otimização numérica. No R, dlm::dlmMLE() ou KFAS::fitSSM() fazem isso automaticamente.
💡 Filtro de Kalman em R
# Via ARIMA (Kalman filter used internally)
arima(y, order = c(1,1,1))

# Explicit state space with dlm package
library(dlm)
model <- dlmModPoly(order = 1, dV = H, dW = Q)  # local level model
filtered  <- dlmFilter(y, model)
smoothed  <- dlmSmooth(filtered)

# KFAS package (more flexible)
library(KFAS)
model <- SSModel(y ~ SSMtrend(1, Q = Q), H = H)
out   <- KFS(model)   # filtering + smoothing in one call
