Modelo autorregressivo (AR)
Um modelo autorregressivo de ordem \(p\), AR(\(p\)), expressa o valor atual de uma série temporal como uma combinação linear de seus \(p\) valores mais recentes mais ruído branco. É o modelo mais simples para capturar dependência temporal e o bloco de construção do ARMA e do ARIMA.
Definição
O modelo regride \(y_t\) sobre seus próprios \(p\) valores mais recentes, cada um com seu próprio coeficiente \(\phi_i\):
\[y_t = \phi_1 y_{t-1} + \phi_2 y_{t-2} + \cdots + \phi_p y_{t-p} + \varepsilon_t\]
em que \(\varepsilon_t \sim \text{RB}(0, \sigma^2)\) é ruído branco (média zero, variância constante, não correlacionado). Usando o operador de defasagem \(L\):
\[(1 - \phi_1 L - \phi_2 L^2 - \cdots - \phi_p L^p) y_t = \varepsilon_t\]
\[\Phi(L)\, y_t = \varepsilon_t\]
em que \(\Phi(L) = 1 - \phi_1 L - \cdots - \phi_p L^p\) é o polinômio AR.
Condição de estacionariedade
Um processo AR(\(p\)) é estacionário se e somente se todas as raízes do polinômio característico \(\Phi(z) = 0\) estiverem fora do círculo unitário \(|z| > 1\).
Para AR(1): \(y_t = \phi_1 y_{t-1} + \varepsilon_t\) é estacionário sse \(|\phi_1| < 1\). Quando \(\phi_1 = 1\), o processo é um passeio aleatório (não estacionário).
Para AR(2): \(y_t = \phi_1 y_{t-1} + \phi_2 y_{t-2} + \varepsilon_t\) é estacionário quando as raízes de \(1 - \phi_1 z - \phi_2 z^2 = 0\) têm módulo maior do que 1. Isso exige:
\[|\phi_2| < 1, \qquad \phi_1 + \phi_2 < 1, \qquad \phi_2 - \phi_1 < 1\]
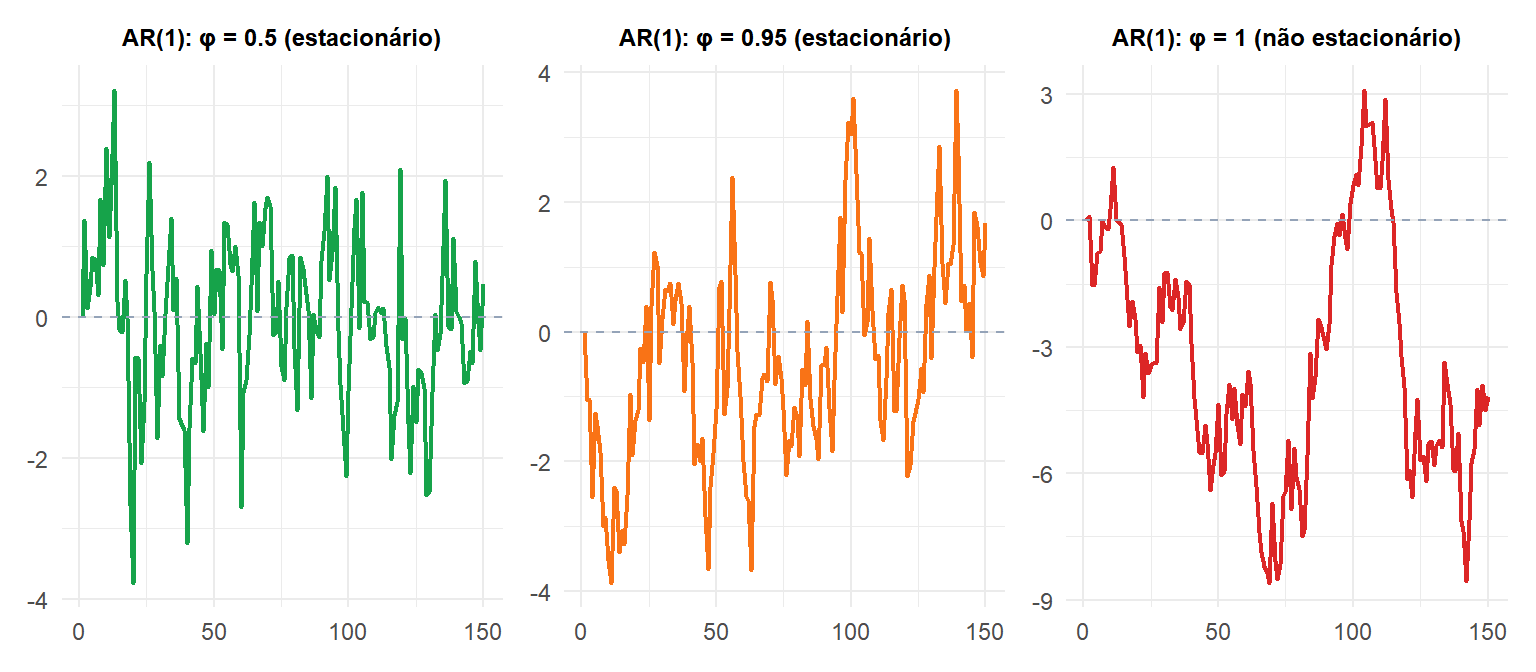
Com \(\phi = 0{,}5\) (verde), a série reverte rapidamente a zero. Com \(\phi = 0{,}95\) (laranja), a reversão é lenta e a série tem memória longa. Com \(\phi = 1\) (vermelho), o passeio aleatório deriva sem limite.
ACF e PACF de processos AR
A ACF teórica de um AR(\(p\)) estacionário satisfaz as equações de Yule-Walker:
\[\rho_k = \phi_1 \rho_{k-1} + \phi_2 \rho_{k-2} + \cdots + \phi_p \rho_{k-p}, \quad k \geq 1\]
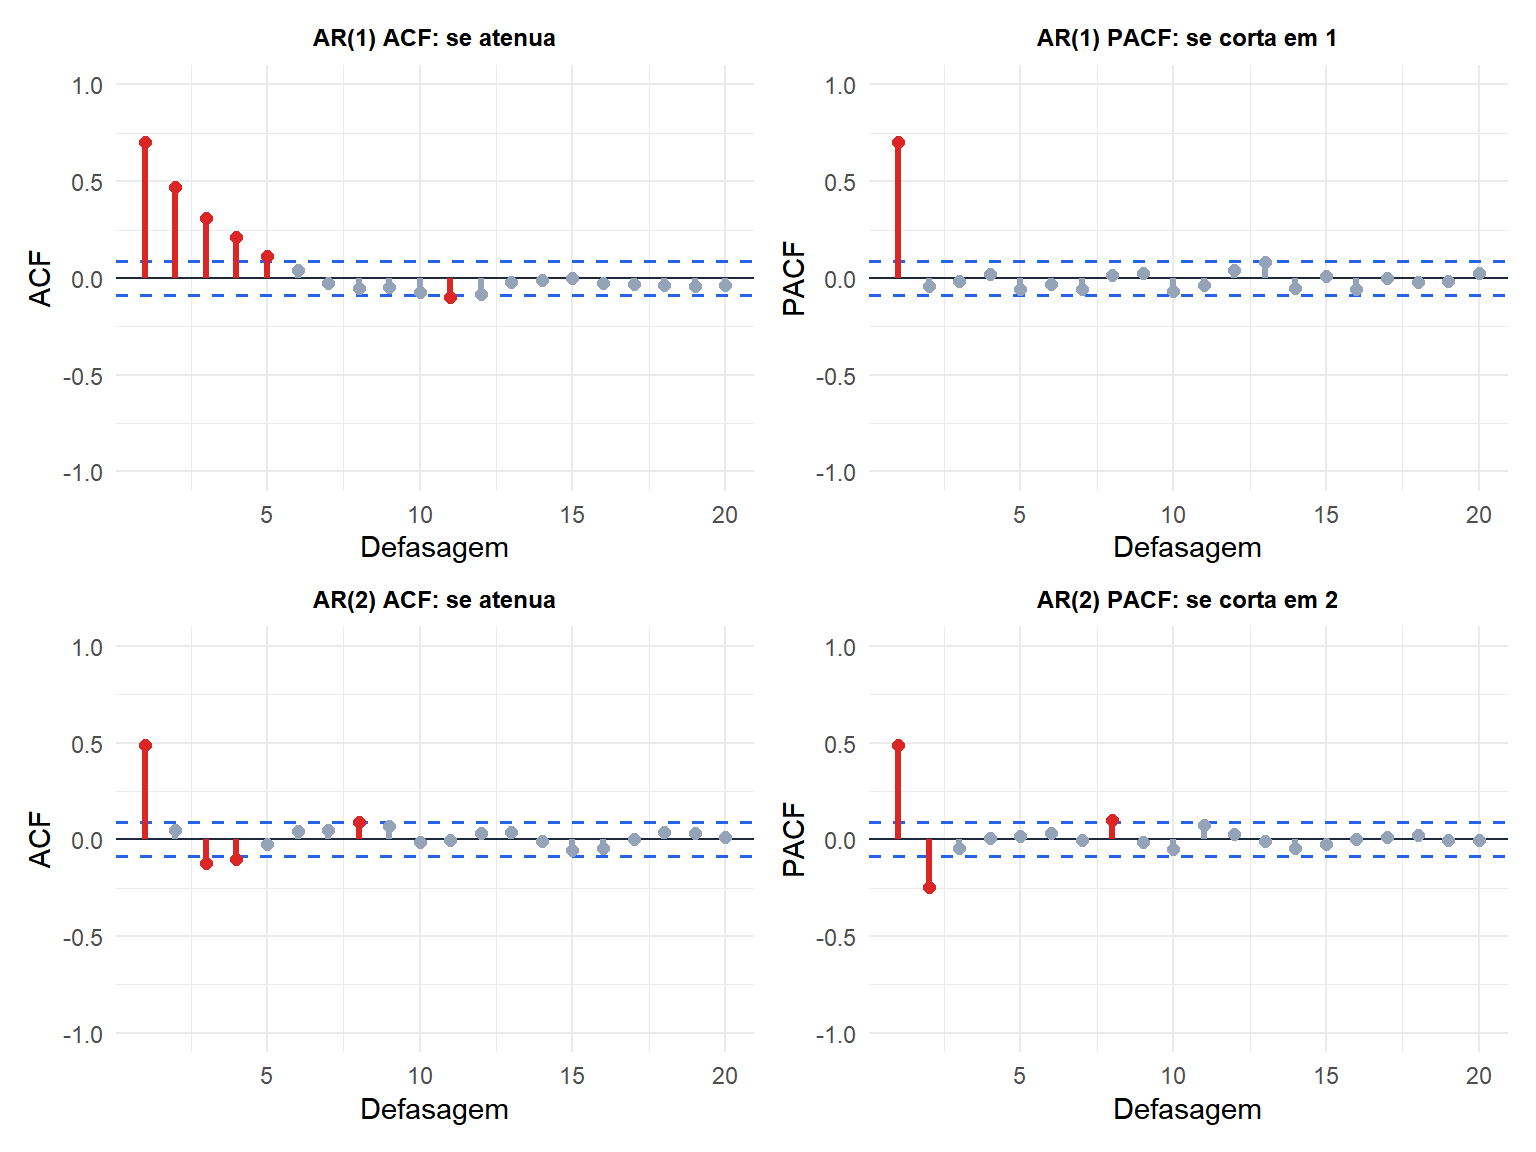
Isso dá uma ACF que se atenua geometricamente (ou com oscilações amortecidas se as raízes forem complexas). A PACF se corta abruptamente após a defasagem \(p\): \(\phi_{kk} = 0\) para \(k > p\).
Esse corte na PACF é o identificador-chave dos modelos AR(\(p\)).
Estimação
Mínimos Quadrados Ordinários (MQO)
Escreva o AR(\(p\)) como uma regressão: \(y_t = \phi_1 y_{t-1} + \cdots + \phi_p y_{t-p} + \varepsilon_t\). O MQO minimiza \(\sum_{t=p+1}^T \varepsilon_t^2\) e fornece estimativas consistentes e assintoticamente eficientes quando o processo é estacionário.
Equações de Yule-Walker
Expresse a ACF em função dos parâmetros usando as equações de Yule-Walker em forma matricial:
\[\begin{pmatrix}\rho_1 \\ \rho_2 \\ \vdots \\ \rho_p\end{pmatrix} = \begin{pmatrix}1 & \rho_1 & \cdots & \rho_{p-1} \\ \rho_1 & 1 & \cdots & \rho_{p-2} \\ \vdots & & \ddots & \vdots \\ \rho_{p-1} & \rho_{p-2} & \cdots & 1\end{pmatrix} \begin{pmatrix}\phi_1 \\ \phi_2 \\ \vdots \\ \phi_p\end{pmatrix}\]
Substituindo a ACF amostral \(\hat{\rho}_k\), obtêm-se as estimativas de Yule-Walker. Elas são menos eficientes do que a MV, mas garantidamente produzem estimativas estacionárias (todas as raízes fora do círculo unitário).
Estimação por Máxima Verossimilhança (MV)
Assume erros gaussianos e maximiza a verossimilhança conjunta. Mais eficiente do que o MQO ou Yule-Walker em amostras pequenas. É o método usado por arima() no R por padrão.
Exemplo: temperatura diária com AR(1)
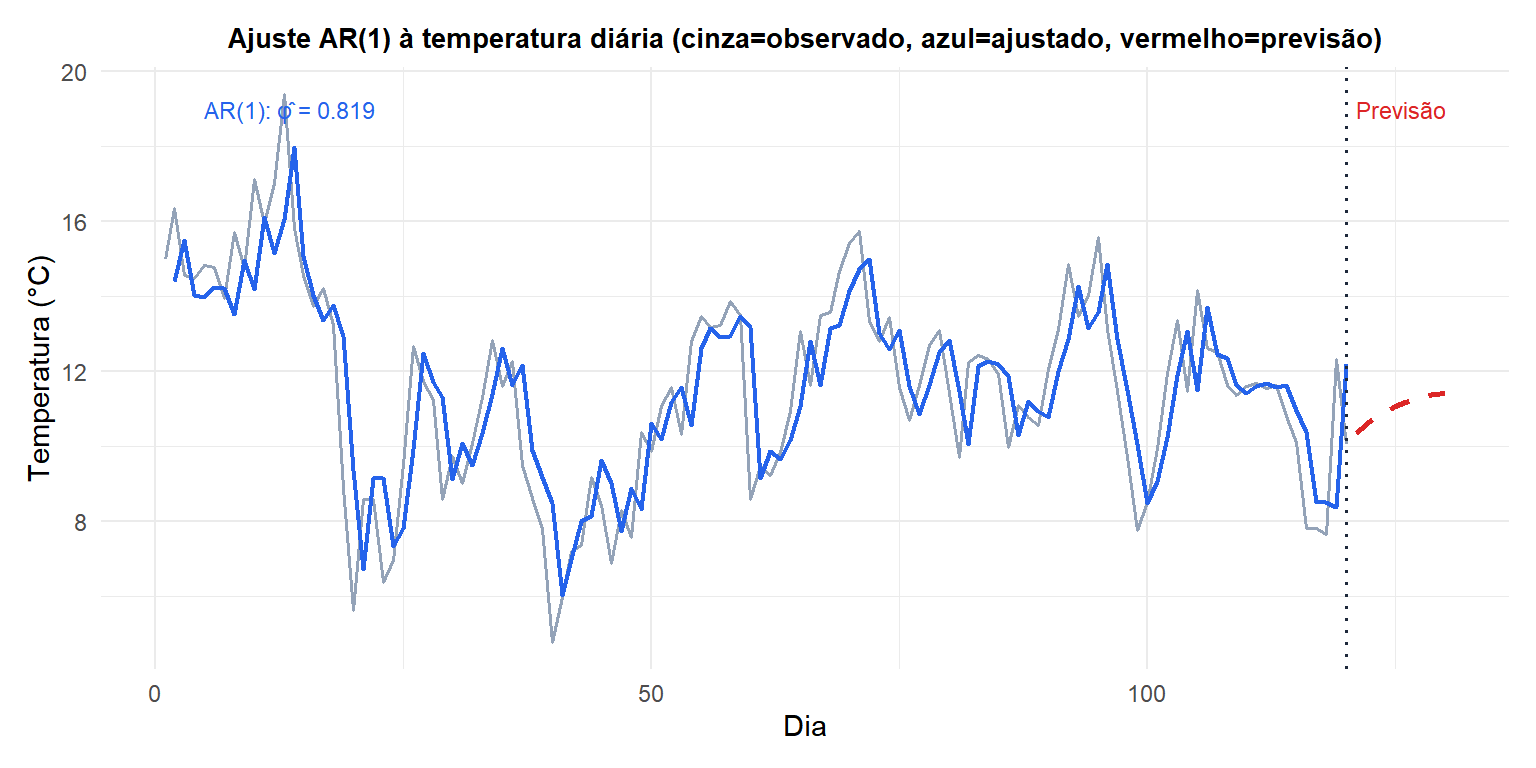
A previsão do AR(1) (vermelho) reverte em direção à média incondicional \(\mu = \phi_0/(1-\phi_1)\) conforme o horizonte aumenta. Previsões multi-passo de processos AR são cada vez mais incertas e convergem para a média de longo prazo quando \(h \to \infty\).
Seleção da ordem
A PACF se corta na ordem verdadeira \(p\), fornecendo uma estimativa inicial. A seleção formal usa critérios de informação:
\[\text{AIC} = -2\log\hat{L} + 2(p+1), \qquad \text{BIC} = -2\log\hat{L} + \log(T)(p+1)\]
O BIC penaliza a complexidade com mais força e tende a selecionar modelos menores. Ambos devem ser comparados em uma faixa de ordens candidatas.
⚠️ Sobreajuste: escolher p muito grande
Incluir defasagens demais ajusta bem os dados de treinamento, mas produz previsões ruidosas e instáveis. Sinais de sobreajuste:
- Coeficientes em defasagens altas estão próximos de zero, mas têm erros padrão grandes.
- O AIC melhora ligeiramente, mas o BIC aumenta (o BIC penaliza parâmetros extras com mais força).
- Os intervalos de previsão se ampliam rapidamente.
Uma regra prática: considere defasagens até \(p_\text{max} = \min(10, T/5)\) e use o BIC para a seleção em séries curtas.
💡 Ajustando modelos AR em R
# Fit AR(1) by MLE
arima(y, order = c(1, 0, 0))

# Automatic order selection by AIC
ar(y, method = "mle")

# With AIC/BIC comparison across orders
library(forecast)
auto.arima(y, max.p = 5, max.q = 0, d = 0)  # AR only

# Yule-Walker estimation
ar(y, method = "yule-walker")
