Teste de Kolmogorov-Smirnov (Lilliefors)
O teste de Kolmogorov-Smirnov mede a maior distância vertical entre a função de distribuição acumulada empírica de uma amostra e uma CDF de referência. A variante de Lilliefors ajusta os valores críticos para o caso em que os parâmetros da distribuição são estimados a partir dos dados, o que é sempre o caso ao testar normalidade.
Teste KS vs. teste de Lilliefors
Os dois testes compartilham a mesma estatística, mas diferem em como a distribuição de referência é especificada:
- Teste KS: a distribuição de referência é totalmente especificada (parâmetros conhecidos). Por exemplo, testar se os dados seguem uma \(N(10, 4)\) com \(\mu=10\) e \(\sigma=2\) fixados de antemão.
- Teste de Lilliefors: os parâmetros são estimados a partir dos dados (\(\hat{\mu} = \bar{x}\), \(\hat{\sigma} = S\)). É isso que você faz ao testar normalidade sem conhecer \(\mu\) e \(\sigma\). Estimar parâmetros a partir dos dados torna a estatística do teste estocasticamente menor, então os valores críticos do KS são excessivamente conservadores: Lilliefors os recalculou via simulação.
Na prática, quando se diz “teste KS de normalidade”, quase sempre se quer dizer o teste de Lilliefors.
Estatística do teste
Tanto o teste KS quanto o de Lilliefors reduzem toda a comparação a um único número, a maior distância entre as duas curvas de distribuição acumulada:
\[D = \max_x \left| F_n(x) - F_0(x) \right|\]
em que \(F_n(x)\) é a CDF empírica da amostra e \(F_0(x)\) é a CDF de referência (normal com parâmetros estimados no caso de Lilliefors). Quanto maior \(D\), mais a amostra se desvia da distribuição de referência.
Hipóteses: \(H_0\): os dados seguem a distribuição especificada. \(H_1\): não seguem.
O valor-p é calculado comparando \(D\) com a distribuição de Lilliefors (via simulação ou tabelas dedicadas), não a distribuição KS padrão.
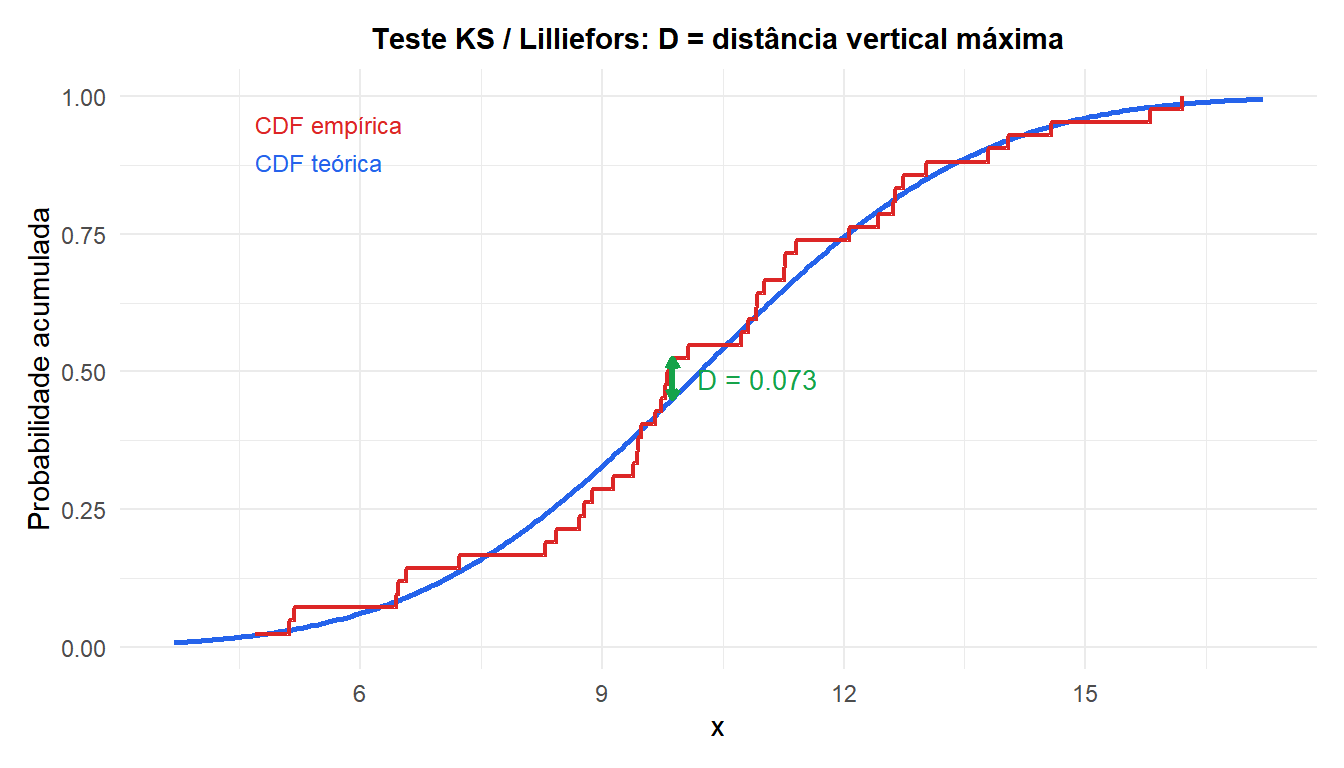
A função escalonada vermelha é a CDF empírica; a curva azul é a CDF normal teórica com parâmetros estimados. O segmento verde marca a distância máxima \(D\).
Exemplo passo a passo
Um laboratório mede a viscosidade de 30 amostras. Antes de aplicar um teste \(t\), o analista verifica a normalidade. Os dados dão \(\bar{x} = 12{,}4\) cP, \(S = 1{,}8\) cP.
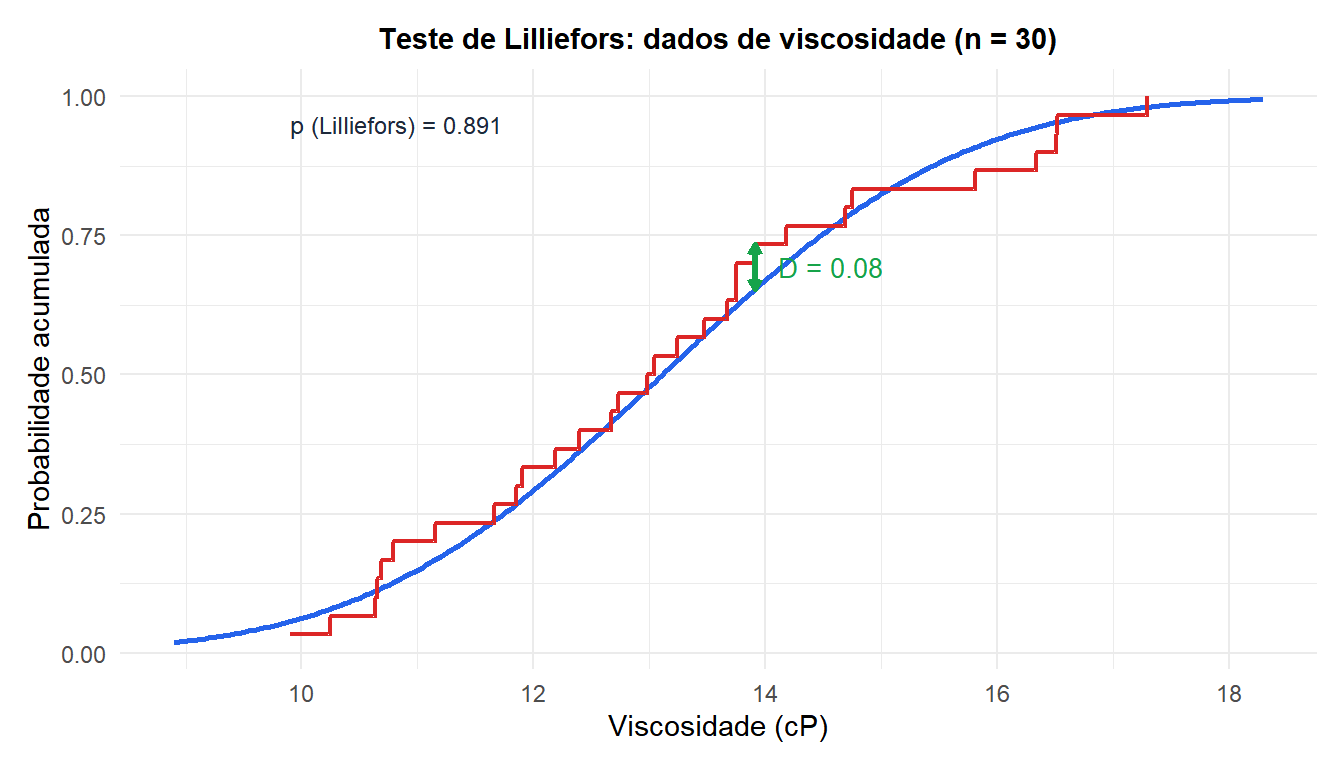
Se \(p > 0{,}05\), a normalidade não é rejeitada e o teste \(t\) pode ser aplicado. Em R:
library(nortest)
lillie.test(x)   # Lilliefors test
ks.test(x, "pnorm", mean(x), sd(x))  # KS test (wrong for normality: use lillie.test)
Comparação com outros testes de normalidade
O teste KS/Lilliefors é uma das várias opções para testar normalidade. Cada um tem pontos fortes diferentes:
| Teste | Melhor para | Poder | Observações |
|---|---|---|---|
| Lilliefors | Normalidade geral | Moderado | Parâmetros estimados dos dados |
| Shapiro-Wilk | Amostras pequenas a médias (\(n \leq 50\)) | Alto | O mais poderoso para normalidade |
| Anderson-Darling | Sensibilidade nas caudas | Alto | Dá mais peso às caudas do que ao centro |
| KS (original) | Parâmetros conhecidos | Moderado | Excessivamente conservador quando os parâmetros são estimados |
⚠️ Shapiro-Wilk é quase sempre preferível a Lilliefors para testar normalidade
Para testar normalidade, Shapiro-Wilk tem maior poder do que o teste de Lilliefors em quase todos os tamanhos de amostra e desvios de normalidade. A menos que você tenha um motivo específico para usar Lilliefors (por exemplo, restrições de software), use Shapiro-Wilk em R: shapiro.test(x).
O teste KS original (com parâmetros conhecidos) nunca deve ser usado para testar normalidade quando a média e a variância são estimadas a partir dos dados: os valores-p serão demasiadamente grandes (demasiadamente conservadores) porque os valores críticos do KS assumem distribuições totalmente especificadas.
⚠️ Todos os testes de normalidade têm pouco poder para amostras pequenas e muito poder para amostras grandes
Para \(n < 20\), os testes de normalidade raramente rejeitam \(H_0\) mesmo para dados claramente não normais: o teste tem pouco poder. Para \(n > 100\), eles frequentemente rejeitam \(H_0\) por desvios triviais de normalidade que não têm consequência prática. Um gráfico Q-Q é sempre um complemento útil ao teste formal: ele mostra onde e como os dados se desviam da normalidade, o que o valor-p isoladamente não revela.
💡 Fluxo de trabalho prático para verificar normalidade
Uma abordagem robusta para verificar normalidade antes de testes paramétricos:
- Plote um gráfico Q-Q:
qqnorm(x); qqline(x). - Execute Shapiro-Wilk:
shapiro.test(x). - Se \(n > 50\), complemente com Anderson-Darling:
nortest::ad.test(x). - Considere a robustez do teste subsequente: o teste \(t\) é bastante robusto a desvios leves de normalidade para \(n \geq 30\), então um pequeno desvio pode não importar.
Rejeite o teste paramétrico apenas quando o gráfico Q-Q mostrar um desvio sistemático claro e o teste de normalidade confirmá-lo.

