Teste z de uma amostra para a média
O teste z de uma amostra para uma média é usado quando o desvio padrão populacional \(\sigma\) é conhecido. Na prática, isso é raro: \(\sigma\) quase nunca é realmente conhecido, e o teste \(t\) deve ser usado em seu lugar. O teste z continua útil como ferramenta pedagógica e em alguns contextos aplicados específicos.
Quando usar o teste z vs. o teste t
Ambos os testes avaliam \(H_0: \mu = \mu_0\), mas diferem no que assumem sobre \(\sigma\):
| Teste Z | Teste T | |
|---|---|---|
| \(\sigma\) | Conhecido | Desconhecido (estimado por \(S\)) |
| Distribuição de referência | \(N(0,1)\) | \(t(n-1)\) |
| Quando usar | \(\sigma\) realmente conhecido por dados prévios ou teoria | Quase sempre |
Para \(n\) grande, a distribuição \(t\) converge para a normal padrão e os dois testes dão resultados praticamente idênticos. Para \(n\) pequeno, o teste \(t\) é mais conservador (região crítica mais ampla) e correto.
⚠️ Usar S no lugar de σ e chamar isso de teste z está errado
Um erro comum: calcular \(Z = (\bar{X} - \mu_0)/(S/\sqrt{n})\) e comparar com \(z_{\alpha/2} = 1{,}96\). Isso é incorreto. Quando \(\sigma\) é substituído por \(S\), a estatística não segue mais uma normal padrão: ela segue uma distribuição \(t\). Usar valores críticos de \(z\) subestima a incerteza e produz testes anticonservadores.
As únicas situações em que \(\sigma\) pode ser considerado realmente conhecido:
- Dados históricos de controle de processo com amostras de referência muito grandes (por exemplo, um processo de fabricação monitorado por anos).
- Testes padronizados em que o desvio padrão populacional é estabelecido pela entidade avaliadora.
- Distribuições teóricas com parâmetro de desvio padrão conhecido (por exemplo, uma contagem de Poisson em que \(\sigma = \sqrt{\mu}\)).
Em todos os outros casos, use t.test() no R, não um teste z.
Fórmula
Dada uma amostra de tamanho \(n\) com média amostral \(\bar{x}\), e desvio padrão populacional conhecido \(\sigma\):
\[Z = \frac{\bar{x} - \mu_0}{\sigma / \sqrt{n}}\]
Sob \(H_0\), \(Z \sim N(0,1)\). O valor-p é calculado a partir da distribuição normal padrão.
Exemplos
Exemplo 1: controle de qualidade (bilateral)
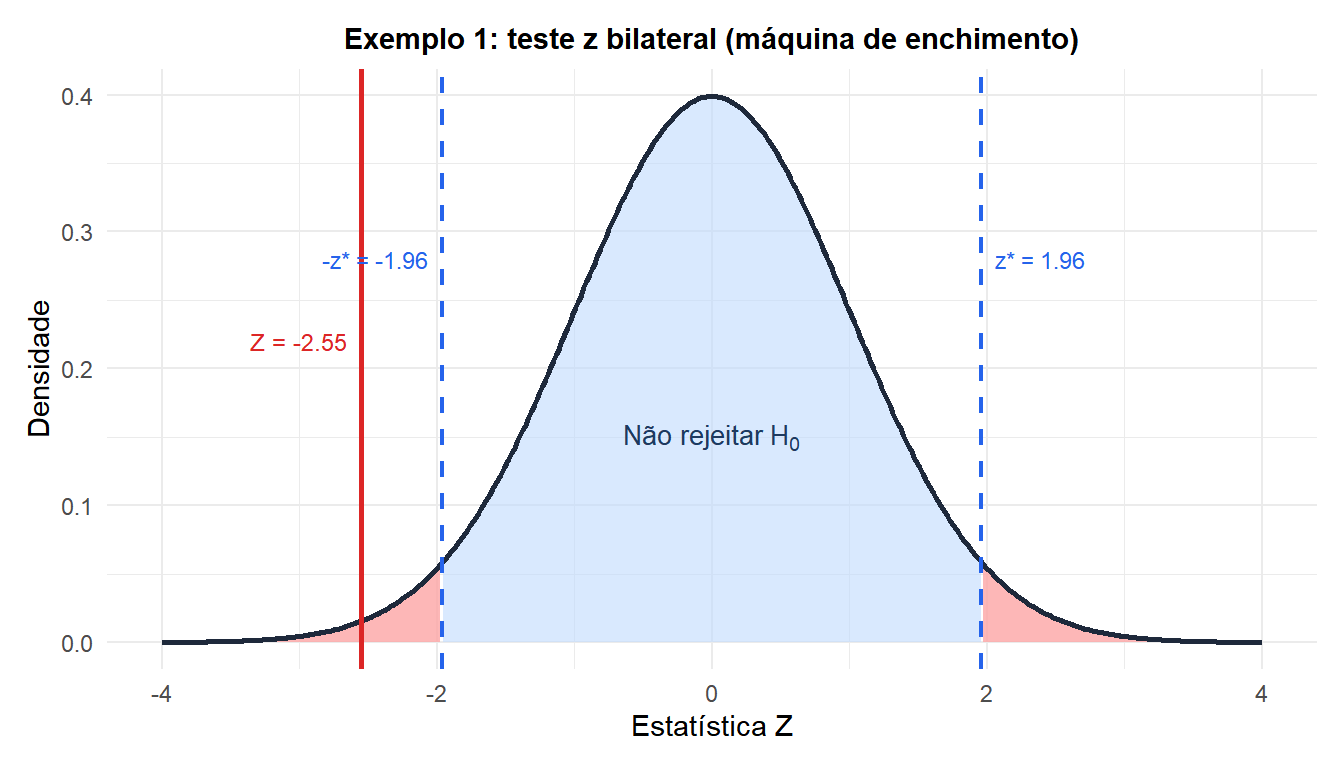
Uma máquina de enchimento é calibrada para dispensar \(\mu_0 = 500\) ml por garrafa. A variabilidade da máquina é bem estabelecida por anos de registros de produção: \(\sigma = 4\) ml. Um engenheiro de qualidade amostra 36 garrafas e encontra \(\bar{x} = 498{,}3\) ml. A calibração desviou?
Hipóteses: \(H_0: \mu = 500\) vs. \(H_1: \mu \neq 500\).
Estatística do teste:
\[Z = \frac{498{,}3 - 500}{4/\sqrt{36}} = \frac{-1{,}7}{0{,}667} \approx -2{,}550\]
Valor-p (bilateral):
\[p = 2 \times P(Z \leq -2{,}550) = 2 \times 0{,}0054 = 0{,}011\]
Decisão: \(p = 0{,}011 < 0{,}05\), rejeitamos \(H_0\).
A produção da máquina desviou significativamente abaixo da meta. A recalibração é necessária.
Exemplo 2: notas de teste padronizado (unilateral à direita)
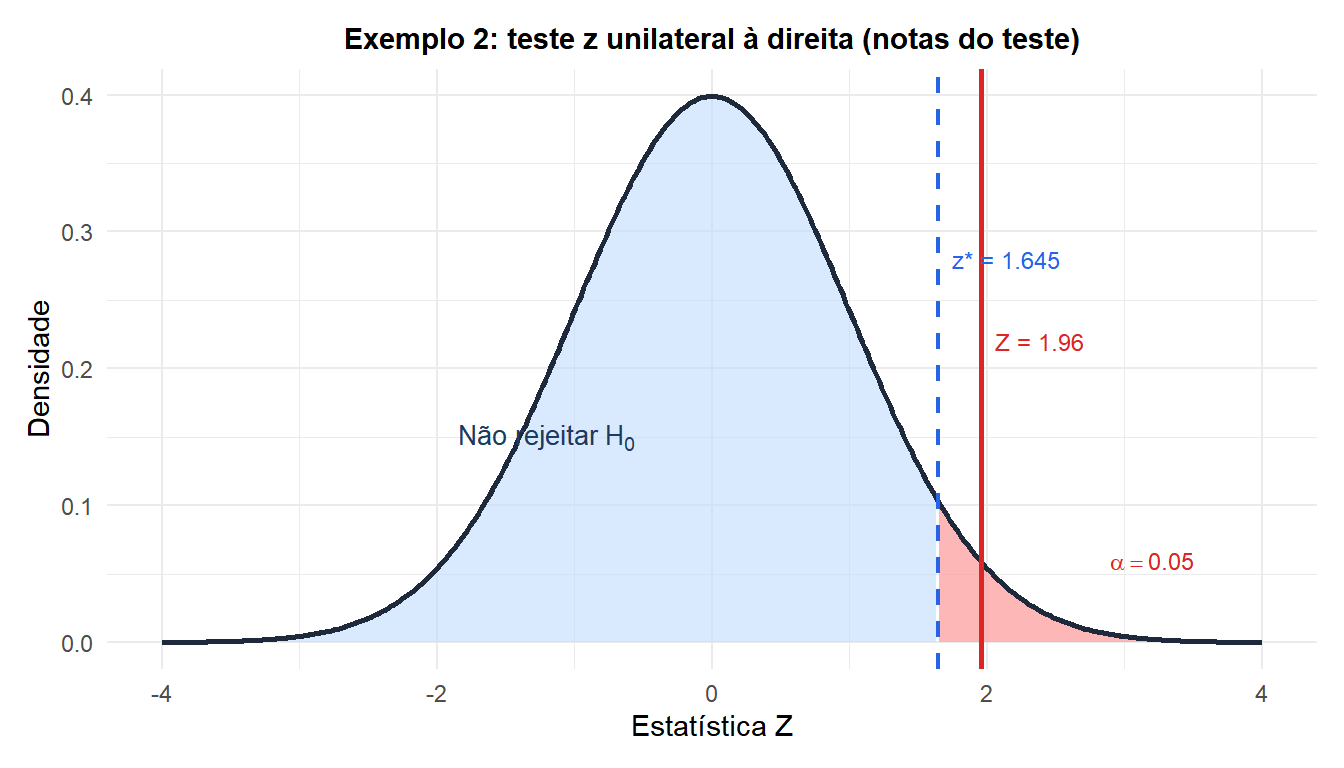
Um teste nacional padronizado tem um desvio padrão populacional conhecido de \(\sigma = 15\) pontos (estabelecido a partir de milhões de aplicações anteriores). Uma rede de ensino testa 49 estudantes após implementar um novo currículo e encontra \(\bar{x} = 104{,}2\). Há evidência de que o currículo melhorou as notas acima da média nacional de \(\mu_0 = 100\)?
Hipóteses: \(H_0: \mu = 100\) vs. \(H_1: \mu > 100\).
Estatística do teste:
\[Z = \frac{104{,}2 - 100}{15/\sqrt{49}} = \frac{4{,}2}{2{,}143} \approx 1{,}960\]
Valor-p (unilateral à direita):
\[p = P(Z \geq 1{,}960) = 0{,}025\]
Decisão: \(p = 0{,}025 < 0{,}05\), rejeitamos \(H_0\).
Há evidência significativa no nível de 5% de que o novo currículo melhorou as notas acima da média nacional.
Conexão com o intervalo de confiança
Quando \(\sigma\) é conhecido, o IC \((1-\alpha)\) para \(\mu\) usa \(z_{\alpha/2}\) em vez de \(t_{\alpha/2,n-1}\):
\[\bar{x} \pm z_{\alpha/2} \cdot \frac{\sigma}{\sqrt{n}}\]
Para o Exemplo 1: \(498{,}3 \pm 1{,}96 \times 4/\sqrt{36} = 498{,}3 \pm 1{,}307 = (496{,}99;\; 499{,}61)\).
Como \(\mu_0 = 500\) cai fora desse intervalo, o teste bilateral rejeita \(H_0\) no nível de 5%, consistente com \(p = 0{,}011\).
Executando o teste em R
O R base não tem uma função z.test() dedicada, já que o teste \(t\) cobre todos os casos práticos. Para as raras situações em que \(\sigma\) é realmente conhecido:
# Manual z-test
x_bar <- 498.3
mu0   <- 500
sigma <- 4
n     <- 36

z_stat <- (x_bar - mu0) / (sigma / sqrt(n))
p_two  <- 2 * pnorm(-abs(z_stat))   # two-sided
p_one  <- pnorm(z_stat)              # one-sided left

# The BSDA package provides z.test()
library(BSDA)
z.test(x, mu = 500, sigma.x = 4, alternative = "two.sided")
💡 Teste z vs. teste t: a regra prática
- \(\sigma\) desconhecido → use sempre
t.test(). Este é o caso em praticamente todas as aplicações reais. - \(\sigma\) conhecido a partir de uma linha de base histórica muito grande (milhares de observações) → o teste z é aceitável.
- \(n\) grande (\(\geq 100\)) e \(\sigma\) desconhecido → o teste \(t\) e o z dão resultados praticamente idênticos, mas o teste \(t\) continua sendo o correto.
O teste z é principalmente útil para ensinar a lógica dos testes de hipóteses: ele usa a distribuição normal padrão, mais simples, e evita a complicação dos graus de liberdade.

