Amostragem sistemática
A amostragem sistemática seleciona cada \(k\)-ésima unidade de uma lista ordenada, partindo de uma posição escolhida aleatoriamente dentro do primeiro intervalo. É mais simples de aplicar do que a amostragem aleatória simples e pode ser mais eficiente quando a lista está bem ordenada, mas é vulnerável à periodicidade oculta na população.
Procedimento
Dada uma população de tamanho \(N\) e uma amostra desejada de tamanho \(n\):
Passo 1: calcule o intervalo de amostragem:
\[k = \left\lfloor \frac{N}{n} \right\rfloor\]
Passo 2: escolha um ponto de partida aleatório \(r\) de forma uniforme entre \(\{1, 2, \ldots, k\}\).
Passo 3: selecione as unidades \(r,\; r+k,\; r+2k,\; \ldots,\; r+(n-1)k\).
Cada unidade tem probabilidade de seleção \(1/k \approx n/N\), portanto a amostragem sistemática é um método probabilístico. No entanto, apenas \(k\) amostras distintas são possíveis (uma para cada ponto de partida), diferentemente da AAS, em que são possíveis \(\binom{N}{n}\) amostras.
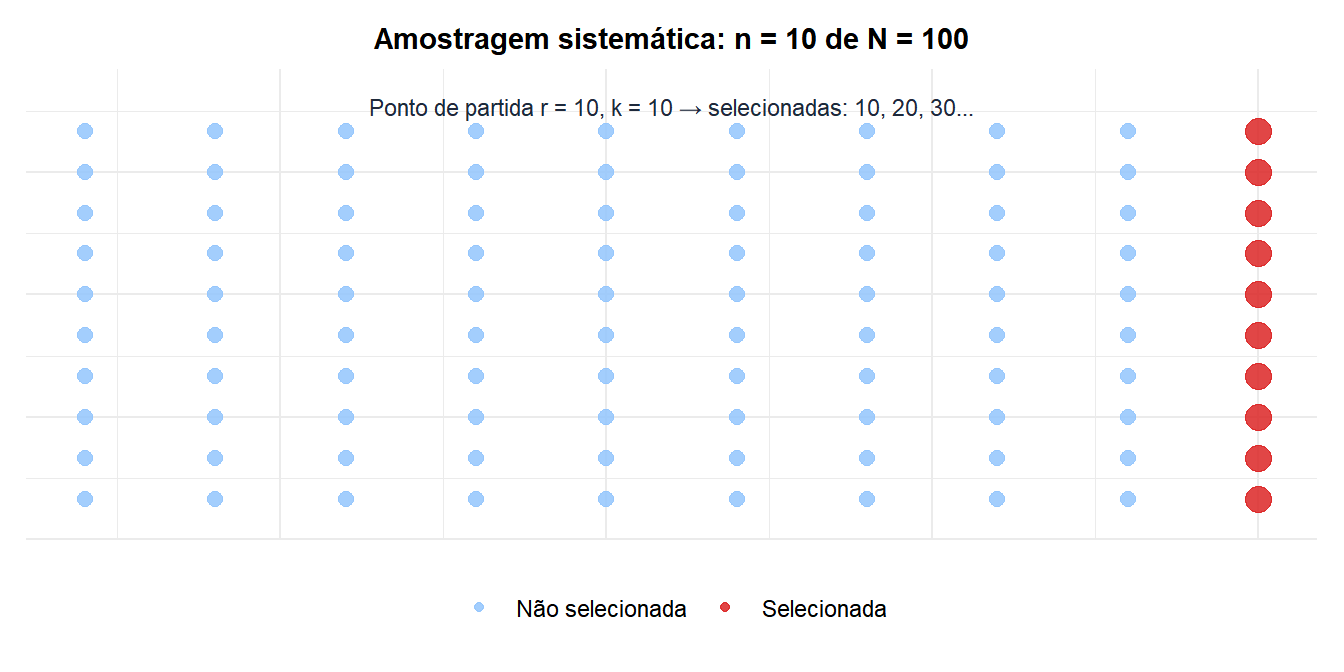
As unidades selecionadas (vermelhas) formam um padrão regular: uma por coluna. O ponto de partida aleatório \(r\) determina qual linha é selecionada em cada coluna.
Eficiência em relação à AAS
A amostragem sistemática é mais eficiente do que a AAS quando a lista está ordenada pela variável de interesse, porque a amostra fica automaticamente estratificada ao longo do ordenamento. Para uma população ordenada por idade, renda ou tamanho, a amostragem sistemática garante que a amostra abranja toda a faixa.
A variância da média da amostra sistemática \(\bar{y}_{sys}\) satisfaz:
\[\text{Var}(\bar{y}_{sys}) \leq \text{Var}(\bar{y}_{AAS})\]
quando a correlação intraclasse dentro dos intervalos é positiva (as unidades dentro do mesmo intervalo são semelhantes). Na prática, qualquer ordenamento razoável da lista (alfabético por nome, cronológico por data, sequencial por ordem de produção) tende a tornar a amostragem sistemática pelo menos tão eficiente quanto a AAS.
Exemplo
Um hospital quer auditar 50 prontuários de pacientes de um banco de dados de 500 casos listados em ordem cronológica de admissão.
\[k = \lfloor 500/50 \rfloor = 10\]
Sorteia-se um número aleatório entre 1 e 10: digamos \(r = 4\). Os registros selecionados são: 4, 14, 24, 34, …, 494. A equipe de auditoria processa cada décimo registro em ordem de admissão, garantindo cobertura ao longo de todo o ano.
Uma fábrica produz 8.000 componentes por turno. A equipe de qualidade precisa inspecionar 80 unidades. Intervalo de amostragem: \(k = 8000/80 = 100\). É sorteado um ponto de partida aleatório \(r = 37\). São inspecionadas as unidades 37, 137, 237, …, 7937.
Isso é prático porque o inspetor simplesmente conta as unidades na linha em vez de gerar 80 números aleatórios e procurar unidades específicas. O resultado é equivalente à AAS em termos de probabilidade de seleção, e o espaçamento regular garante que defeitos ocorridos em qualquer ponto do turno sejam detectáveis.

O problema da periodicidade
O mesmo espaçamento regular que torna a amostragem sistemática conveniente também é sua maior fraqueza.
⚠️ A periodicidade na lista pode enviesar gravemente as amostras sistemáticas
Se a lista tiver uma estrutura periódica com o mesmo período de \(k\), a amostra coincidirá sistematicamente com a mesma fase do ciclo, produzindo uma amostra enviesada e não representativa.
Exemplos clássicos:
- Linha de produção: inspecionar cada 8º componente quando a máquina produz uma unidade defeituosa a cada 8 unidades sempre incluirá ou sempre deixará passar o defeito, dependendo do ponto de partida.
- Programação semanal: se \(k = 7\) e a lista está ordenada por dia, todas as unidades selecionadas caem no mesmo dia da semana. Uma amostra só de segundas-feiras ignora os efeitos de fim de semana.
- Prédios de apartamentos: se \(k = 10\) e os andares têm 10 apartamentos numerados sequencialmente, a amostragem sistemática sempre seleciona a mesma posição em cada andar (por exemplo, sempre o apartamento de canto).
Detecção: represente os valores da lista em função do seu índice antes de amostrar e procure padrões regulares. Se houver suspeita de periodicidade, use AAS ou amostragem estratificada.
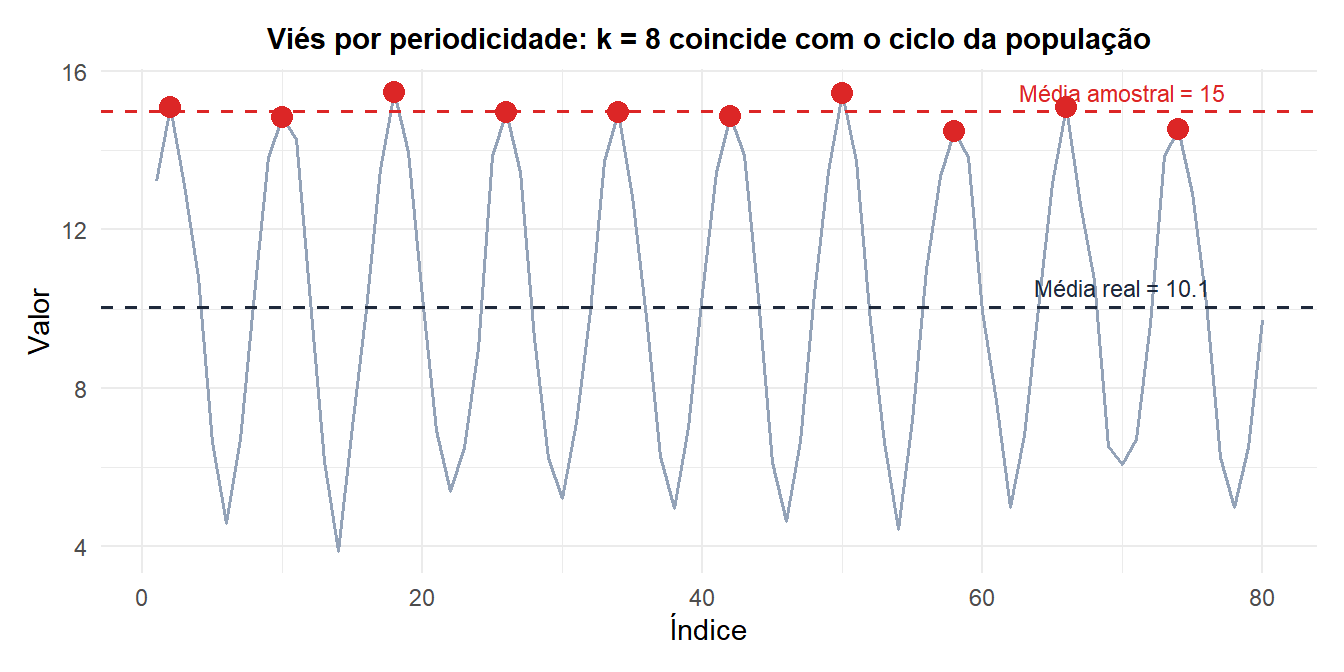
A amostra (pontos vermelhos) coincide sistematicamente com os picos do ciclo, produzindo uma média amostral bem acima da verdadeira média populacional.
Vantagens e limitações
A amostragem sistemática é amplamente usada porque é fácil de implementar e frequentemente tão eficiente quanto a AAS. Suas principais vantagens são práticas: não é preciso gerar muitos números aleatórios, é simples de executar em campo e garante uma distribuição uniforme ao longo da lista. A principal limitação é o risco de periodicidade, fácil de verificar e evitar com uma rápida inspeção visual da lista.
💡 Amostragem sistemática circular para k não inteiro
Quando \(N/n\) não é um número inteiro, \(k = \lfloor N/n \rfloor\) pode resultar em menos de \(n\) unidades. A solução é a amostragem sistemática circular: tratar a lista como circular (voltar ao início após a última unidade), sortear \(r\) de forma uniforme em \(\{1, \ldots, N\}\) e selecionar as unidades \(r, r+k, r+2k, \ldots \pmod{N}\). Isso garante exatamente \(n\) unidades, independentemente de \(k\) dividir \(N\) de forma exata.

