Amostragem aleatória simples
A amostragem aleatória simples (AAS) é o método de amostragem probabilística de referência: cada unidade da população tem a mesma probabilidade de ser selecionada e toda possível amostra de tamanho \(n\) é igualmente provável. É o desenho mais simples e o ponto de comparação em relação ao qual outros métodos são avaliados, veja nosso guia mais amplo sobre o que é a amostragem para o panorama completo.
Definição
Na amostragem aleatória simples, \(n\) unidades são selecionadas de uma população de tamanho \(N\) tal que:
- Cada unidade tem probabilidade de seleção \(n/N\).
- Todo possível subconjunto de tamanho \(n\) é igualmente provável.
Isso exige um marco amostral completo: uma lista de todas as unidades da população a partir da qual a amostra é extraída. Sem um marco, a AAS verdadeira não é possível.
Com vs sem reposição
AAS com reposição
Cada unidade selecionada é devolvida à população antes da próxima extração. Uma unidade pode aparecer mais de uma vez na amostra. Cada extração é independente: a amostra consiste em \(n\) observações independentes e identicamente distribuídas (i.i.d.).
\[P(\text{unidade } i \text{ selecionada em qualquer extração}) = \frac{1}{N}\]
AAS sem reposição
Cada unidade selecionada é removida da população. Nenhuma unidade aparece mais de uma vez. As extrações não são independentes, mas os estimadores são mais eficientes porque a mesma unidade não pode contribuir com informação redundante.
\[P(\text{unidade } i \text{ selecionada}) = \frac{n}{N}\]
Na prática, a amostragem sem reposição é quase sempre usada. A amostragem com reposição é principalmente uma conveniência teórica (simplifica as demonstrações) e é o modelo assumido na reamostragem bootstrap.
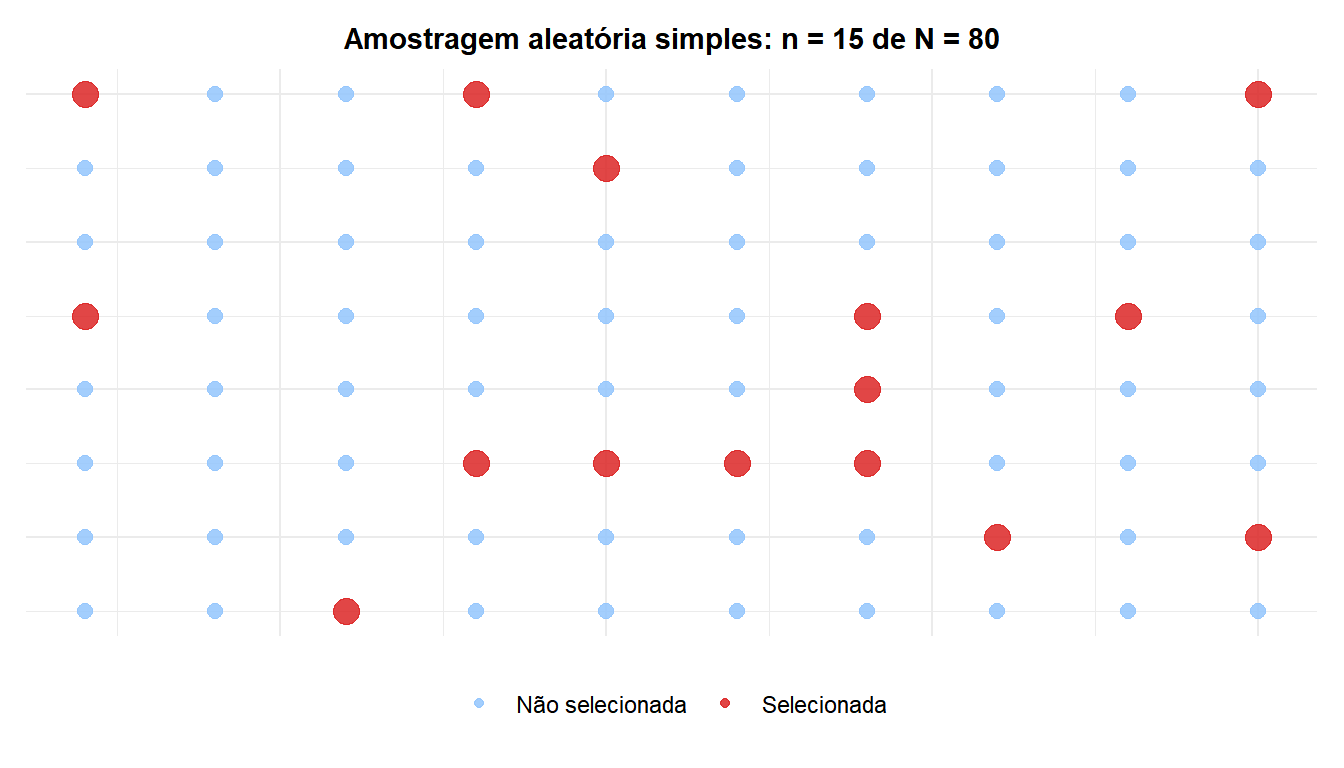
Cada unidade (azul) tem a mesma probabilidade de ser selecionada. As unidades vermelhas são a amostra: suas posições na grade não são sistemáticas nem agrupadas, refletindo a verdadeira aleatoriedade.
Estimadores sob a AAS
Sob a AAS sem reposição, os estimadores padrão para a média e a proporção populacional são:
\[\hat{\mu} = \bar{x} = \frac{1}{n}\sum_{i=1}^n x_i, \qquad \hat{p} = \frac{x}{n}\]
Suas variâncias incluem a correção para população finita (CPF):
\[\text{Var}(\bar{x}) = \frac{\sigma^2}{n}\left(1 - \frac{n}{N}\right) = \frac{\sigma^2}{n} \cdot \text{CPF}\]
O fator CPF \((1 - n/N)\) leva em conta o fato de que a amostragem sem reposição é mais eficiente do que com reposição. Quando \(n/N < 0{,}05\) (a amostra é menos de 5% da população), a CPF fica próxima de 1 e pode ser ignorada. Para populações grandes em relação à amostra, a AAS com e sem reposição dão erros padrão praticamente idênticos.
Tamanho amostral
Para estimar uma proporção \(p\) com margem de erro \(d\) ao nível de confiança \(1-\alpha\), o tamanho amostral necessário de uma população finita de tamanho \(N\) é:
\[n = \frac{N \cdot z_{\alpha/2}^2 \cdot p(1-p)}{(N-1) \cdot d^2 + z_{\alpha/2}^2 \cdot p(1-p)}\]
Quando \(N\) é muito grande (ou desconhecido), a CPF desaparece e a fórmula se simplifica para \(n = z_{\alpha/2}^2 p(1-p)/d^2\).
Uma rede de supermercados quer estimar a proporção de clientes satisfeitos entre seus 50.000 titulares de cartão de fidelidade. Meta: margem de erro \(\pm 5\%\) a 95% de confiança. Usando \(p = 0{,}5\) (caso mais conservador):
\[n = \frac{50000 \times 1{,}96^2 \times 0{,}25}{49999 \times 0{,}05^2 + 1{,}96^2 \times 0{,}25} = \frac{48020}{124{,}998 + 0{,}9604} \approx 381\]
É necessária uma amostra de 381 clientes. Como \(381/50000 = 0{,}76\%\), a CPF quase não tem efeito aqui.

Como selecionar a amostra na prática
Com um marco amostral numerado, extraia a amostra usando um gerador de números aleatórios. Em R:
# Population of N = 1000, sample n = 100 without replacement
set.seed(42)
sample(1:1000, size = 100, replace = FALSE)

# With replacement
sample(1:1000, size = 100, replace = TRUE)
Para amostragem física (listas em papel, unidades físicas), uma tabela de números aleatórios ou um sorteio (papeletas numeradas extraídas de um recipiente) atinge o mesmo resultado.
Vantagens e limitações
A AAS é não viesada e seus erros padrão são fáceis de calcular. É o ponto de partida natural para qualquer desenho de amostragem. No entanto, tem limitações práticas:
⚠️ A AAS é ineficiente para populações heterogêneas e impraticável sem um marco completo
Dois problemas principais:
- Sem marco amostral completo: se você não puder listar todas as unidades da população, não poderá extrair uma amostra verdadeiramente aleatória. Pesquisas on-line, pesquisas por telefone e abordagens de interceptação usam amostras de conveniência, não AAS.
- Populações heterogêneas: se a população tem subgrupos distintos (faixas etárias, regiões, níveis de renda), a AAS pode representar em excesso (ou em falta) alguns deles por acaso. A amostragem estratificada garante a representação de cada subgrupo e é mais eficiente.
Uma amostra de 400 pessoas extraída aleatoriamente de um país de 40 milhões pode, por acaso, incluir muito poucos idosos ou muito poucos residentes rurais. A amostragem estratificada evita isso.
💡 Quando a AAS é a escolha certa
A AAS funciona melhor quando:
- Está disponível um marco amostral completo e atualizado.
- A população é relativamente homogênea (baixa variabilidade entre unidades).
- O tamanho amostral é pequeno em relação à população (\(n/N < 5\%\)).
- A simplicidade de implementação importa mais do que a eficiência máxima.
Para populações heterogêneas ou quando certos subgrupos precisam ser representados, a amostragem estratificada é mais adequada. Para populações geograficamente dispersas sem um marco completo, a amostragem por conglomerados ou polietápica é mais prática.

