Agrupamento hierárquico
O agrupamento hierárquico constrói uma sequência aninhada de clusters sem exigir o número de clusters \(K\) com antecedência. O resultado é um dendrograma: uma árvore em que cada folha é uma observação e cada nó interno registra quando dois clusters se mesclaram. Cortar a árvore em qualquer altura produz um agrupamento plano. O método de ligação, que define a distância entre clusters, tem um impacto maior no resultado do que quase qualquer outra escolha. Para grandes conjuntos de dados em que um dendrograma completo é muito caro, o DBSCAN encontra clusters de forma arbitrária diretamente a partir da densidade de pontos.
Agrupamento aglomerativo
A variante mais comum é a aglomerativa (de baixo para cima):
- Comece com \(n\) clusters, um por observação.
- Calcule a matriz de dissimilaridade \(n \times n\).
- Mescle os dois clusters mais próximos em um.
- Atualize a matriz de dissimilaridade (como as distâncias do novo cluster são calculadas depende da ligação).
- Repita os passos 3-4 até restar um cluster.
O histórico de mesclagens é armazenado no dendrograma. A altura em que duas observações (ou clusters) se mesclam reflete o quão dissimilares elas são: mesclagens baixas = semelhantes, mesclagens altas = dissimilares.
O agrupamento divisivo funciona de cima para baixo: começa com todas as observações em um cluster e o divide recursivamente. Computacionalmente mais pesado e menos usado.
Métodos de ligação
O método de ligação define a distância \(d(A, B)\) entre dois clusters \(A\) e \(B\) com base nas distâncias entre seus pontos constituintes:
| Ligação | Fórmula | Forma dos clusters |
|---|---|---|
| Simples (single) | \(\min_{a \in A, b \in B} d(a,b)\) | Alongados, efeito cadeia |
| Completa (complete) | \(\max_{a \in A, b \in B} d(a,b)\) | Compactos, aproximadamente esféricos |
| Média (UPGMA) | \(\frac{1}{|A||B|}\sum_{a,b} d(a,b)\) | Entre simples e completa |
| Centroide | \(d(\bar{a}, \bar{b})\) | Pode inverter (não monótona) |
| Ward | Aumento na WCSS total ao mesclar \(A\) e \(B\) | Compactos, de tamanho igual |
A ligação de Ward mescla o par de clusters que minimiza o aumento na soma de quadrados intra-cluster total. Ela tende a produzir clusters compactos e de tamanho aproximadamente igual, e é a escolha padrão para a maioria das aplicações com dados contínuos.
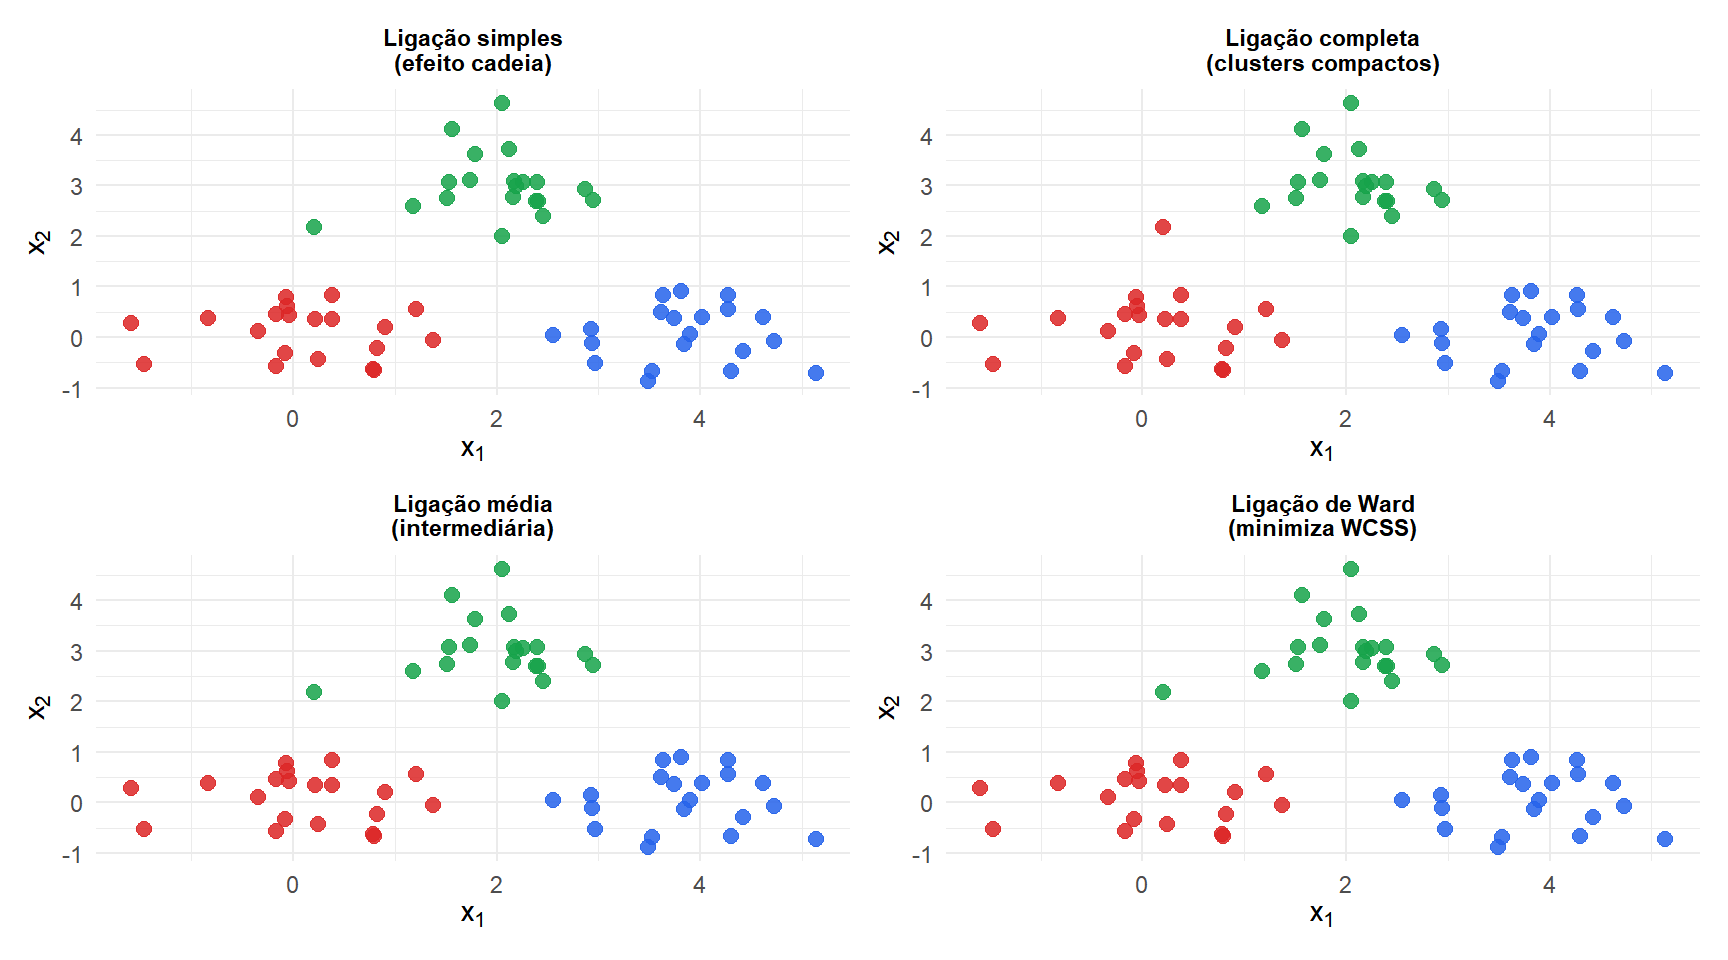
A ligação simples (superior esquerdo) encadeia clusters, frequentemente produzindo grupos alongados. A ligação completa produz clusters compactos. A ligação média é intermediária. A de Ward (inferior direito) produz os clusters mais equilibrados e compactos, e geralmente se ajusta melhor ao agrupamento visual.
Lendo o dendrograma
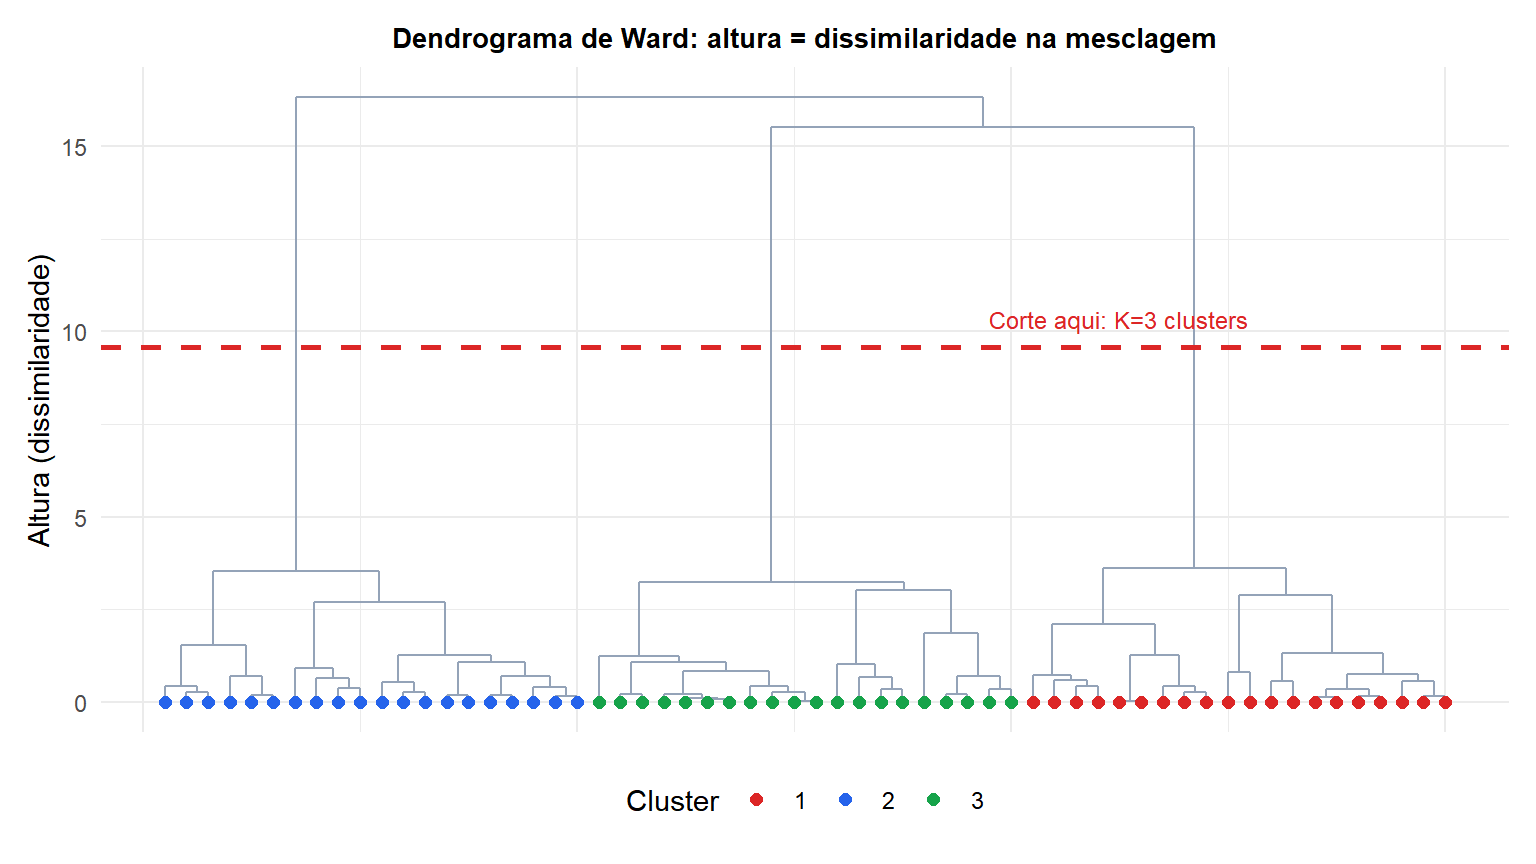
A linha vermelha tracejada corta a árvore em uma altura escolhida. Toda linha vertical que ela cruza se torna um cluster. Aqui, cortar nessa altura dá três clusters (correspondendo à estrutura real). O eixo de altura representa a dissimilaridade: mesclagens baixas na árvore unem observações semelhantes; mesclagens próximas ao topo unem grupos muito diferentes.
Escolhendo a altura de corte: procure a maior lacuna entre alturas de mesclagem consecutivas. Uma lacuna grande significa que os dois níveis da hierarquia são muito diferentes: o corte logo abaixo da lacuna é um número natural de clusters.
Matrizes de distância e dados não euclidianos
O agrupamento hierárquico funciona com qualquer matriz de dissimilaridade, não apenas com a distância euclidiana. Isso o torna aplicável a tipos de dados em que a distância euclidiana não tem sentido:
- Texto: distância de cosseno ou distância de edição entre documentos.
- Dados categóricos: distância de Gower (trata tipos mistos).
- Sequências: distância de edição (Levenshtein) para sequências de DNA ou proteínas.
- Séries temporais: distância de dynamic time warping (DTW).
- Baseada em correlação: \(1 - r_{ij}\), em que \(r_{ij}\) é a correlação de Pearson. Amplamente usada em genômica para agrupar genes com perfis de expressão semelhantes.
O k-médias exige calcular médias (centroides) e, portanto, só funciona com distância euclidiana em dados contínuos. O agrupamento hierárquico funciona com qualquer dissimilaridade personalizada.
Agrupamento hierárquico vs K-médias
| Hierárquico | K-médias | |
|---|---|---|
| Exige K com antecedência | Não | Sim |
| Resultado | Hierarquia completa (dendrograma) | Partição plana |
| Determinístico | Sim | Não (inicialização aleatória) |
| Escalabilidade | \(O(n^2)\) a \(O(n^3)\) | \(O(nKI)\), rápido |
| Dados não euclidianos | Sim (qualquer dissimilaridade) | Não |
| Formas de cluster | Flexíveis (depende da ligação) | Apenas esféricas |
| Sensibilidade a outliers | Alta (especialmente ligação simples) | Moderada |
Use o agrupamento hierárquico quando: você não sabe \(K\), quer explorar a hierarquia, os dados não são euclidianos, ou \(n\) é pequeno o suficiente para a complexidade quadrática (tipicamente \(n < 10.000\)).
Use o k-médias quando: \(K\) é conhecido ou pode ser estimado, os dados são grandes, e os clusters são aproximadamente esféricos.
⚠️ A ligação simples quase nunca é a escolha certa
A ligação simples é notória pelo efeito cadeia: um único ponto-ponte conectando dois clusters faz com que eles se mesclem prematuramente, criando clusters longos e filiformes que não refletem a estrutura real. A menos que os clusters verdadeiros sejam genuinamente filamentosos (raro), sempre comece com a ligação de Ward, completa, ou média, e só considere a ligação simples se houver um motivo específico.
💡 Agrupamento hierárquico em R
# Compute dissimilarity matrix
d <- dist(X, method="euclidean")   # or "manhattan", "maximum"

# Fit hierarchical clustering
hc <- hclust(d, method="ward.D2")  # or "complete", "average", "single"

# Visualize dendrogram
plot(hc, labels=FALSE, hang=-1)
rect.hclust(hc, k=3, border="red")  # draw K clusters

# Cut to K clusters
clusters <- cutree(hc, k=3)
# Or cut at a specific height
clusters <- cutree(hc, h=5)

# Non-Euclidean: Gower distance for mixed data
library(cluster)
d_gower <- daisy(df_mixed, metric="gower")
hc_g    <- hclust(d_gower, method="ward.D2")

# Pretty dendrograms
library(ggdendro)
ggdendrogram(hc, rotate=FALSE, labels=FALSE)
