DBSCAN
O DBSCAN (Density-Based Spatial Clustering of Applications with Noise) define clusters como regiões densas de pontos separadas por regiões esparsas. Ele não exige \(K\) com antecedência, detecta outliers automaticamente como pontos de ruído, e encontra clusters de forma arbitrária. Seus dois parâmetros, \(\varepsilon\) e minPts, definem o que conta como “denso”, diferentemente do k-médias, que exige que o número de clusters \(K\) seja escolhido com antecedência.
Conceitos centrais: densidade e alcançabilidade
\(\varepsilon\)-vizinhança de um ponto \(p\): o conjunto de todos os pontos a uma distância \(\varepsilon\) de \(p\):
\[N_\varepsilon(p) = \{q \in D : d(p,q) \leq \varepsilon\}\]
Tipos de pontos (em relação aos parâmetros \(\varepsilon\) e minPts):
- Ponto central (core): \(|N_\varepsilon(p)| \geq \text{minPts}\). Tem vizinhos suficientes para definir uma região densa.
- Ponto de borda: \(|N_\varepsilon(p)| < \text{minPts}\), mas \(p \in N_\varepsilon(q)\) para algum ponto central \(q\). Na borda de um cluster.
- Ponto de ruído (outlier): nem central nem de borda. Isolado de qualquer região densa.
Alcançabilidade por densidade: o ponto \(q\) é alcançável por densidade a partir do ponto central \(p\) se existe uma cadeia de pontos centrais \(p = p_1, p_2, \ldots, p_k = q\) em que cada \(p_{i+1} \in N_\varepsilon(p_i)\).
Um cluster é um conjunto maximal de pontos conectados por densidade: todo ponto do cluster é alcançável por densidade a partir de todo ponto central do cluster.
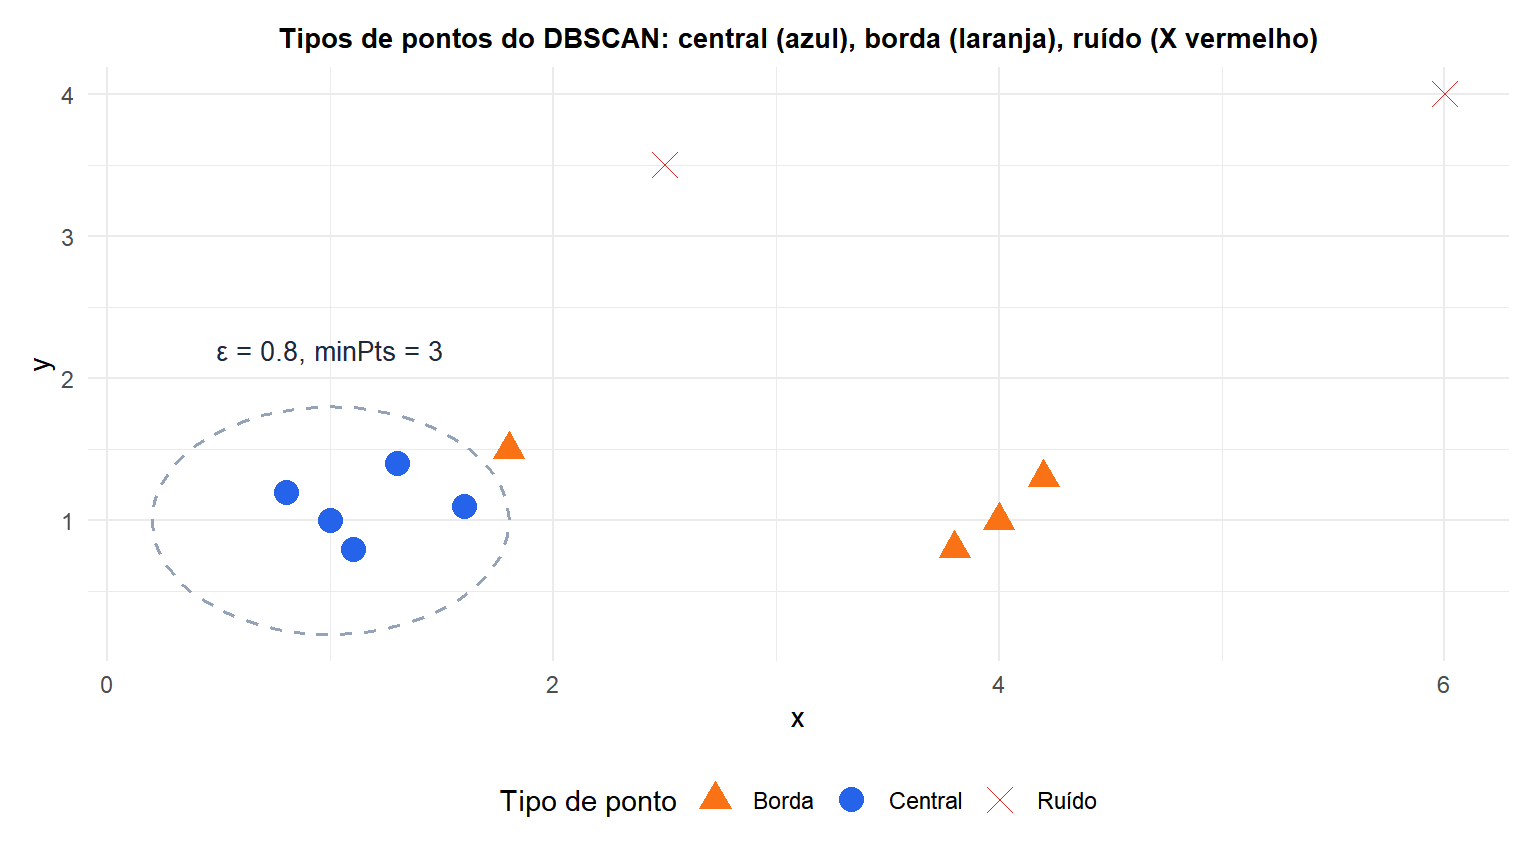
Os círculos tracejados mostram a \(\varepsilon\)-vizinhança de dois pontos centrais. Os pontos centrais azuis têm pelo menos minPts vizinhos dentro de \(\varepsilon\); os pontos de borda laranja estão dentro de \(\varepsilon\) de um ponto central, mas não atendem a minPts por si mesmos; o X vermelho é ruído.
O algoritmo
For each unvisited point p:
  Mark p as visited
  If |N_eps(p)| < minPts:
    Label p as Noise
  Else:
    Create a new cluster C
    Add p to C
    Add all points in N_eps(p) to a seed set S
    For each point q in S:
      If q is unvisited:
        Mark q as visited
        If |N_eps(q)| >= minPts:
          Add N_eps(q) to S
      If q is not yet in a cluster:
        Add q to C
Com um índice espacial (kd-tree ou ball tree), a complexidade é \(O(n \log n)\). Sem um (força bruta): \(O(n^2)\). O algoritmo é determinístico dados \(\varepsilon\) e minPts: sem inicialização aleatória.
DBSCAN vs K-médias em dados não esféricos
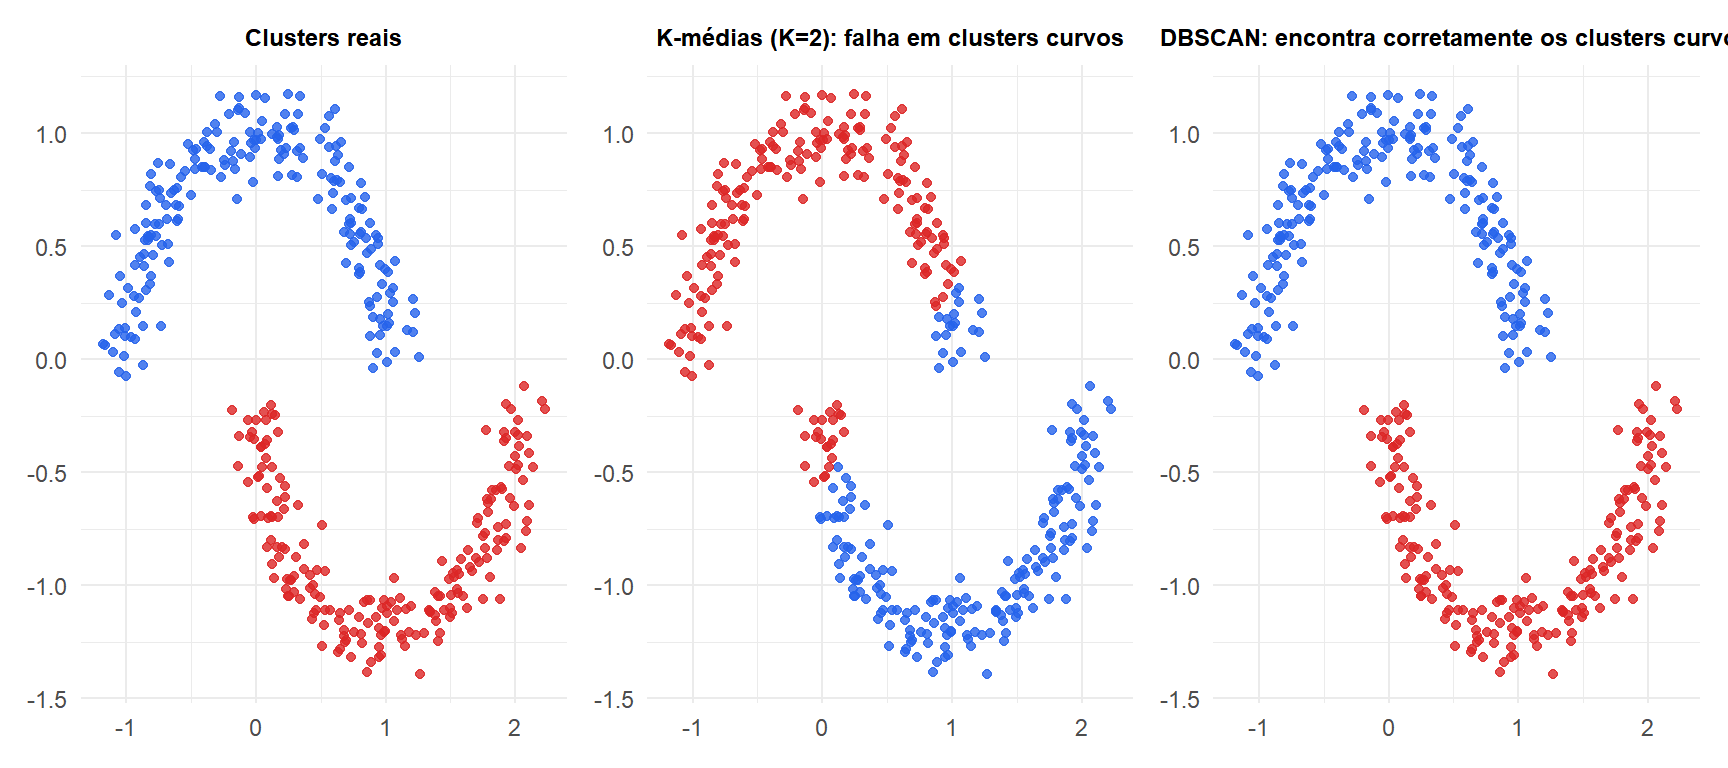
O k-médias força uma partição de Voronoi: ele traça uma fronteira reta entre as duas lunas e classifica mal metade de cada uma. O DBSCAN segue a densidade de cada luna e recupera corretamente ambos os clusters curvos.
Escolhendo \(\varepsilon\) e minPts
minPts
Uma regra prática comum: minPts \(\geq\) dimensionalidade + 1, tipicamente definida como 4 ou 5 para dados 2D, aumentando com a dimensionalidade. Um minPts maior torna o algoritmo mais robusto ao ruído, mas pode deixar passar clusters pequenos.
\(\varepsilon\): o gráfico de distância k
Para cada ponto, calcule a distância ao seu \(k\)-ésimo vizinho mais próximo (\(k\) = minPts - 1). Ordene essas distâncias em ordem decrescente e as plote. O “cotovelo” desse gráfico de distância-k sugere um bom \(\varepsilon\): abaixo do cotovelo, a maioria dos pontos é central; acima, a maioria é ruído.
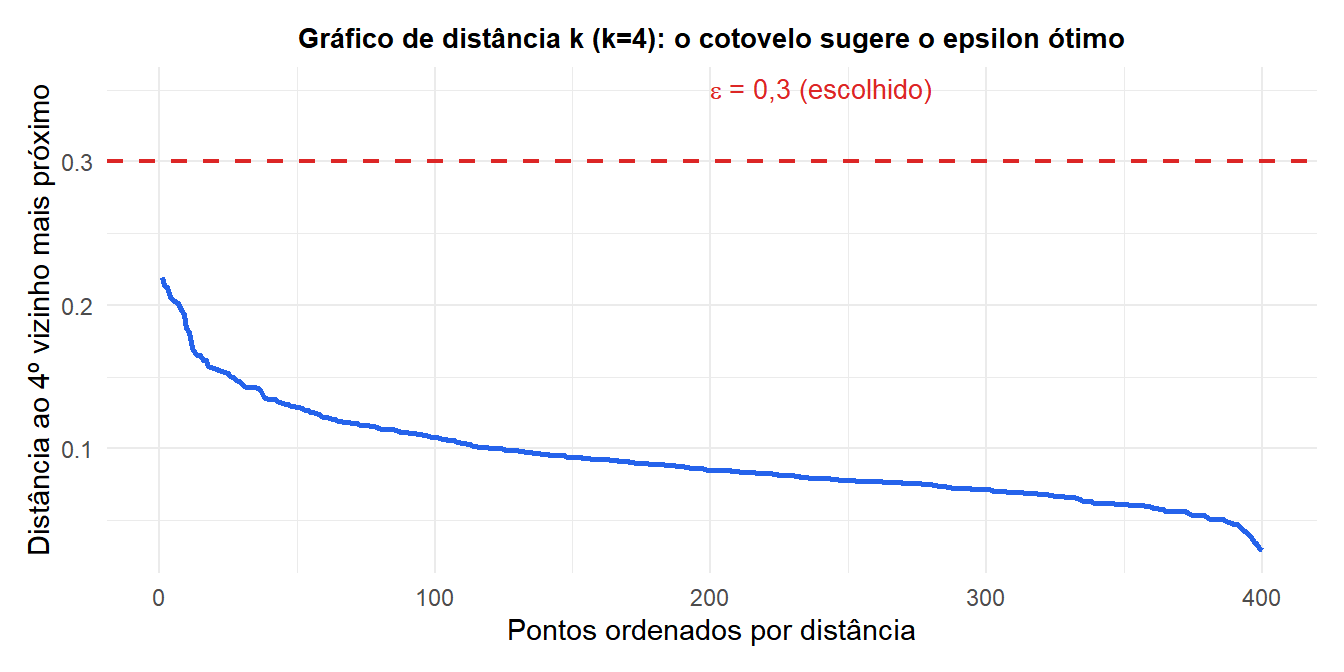
A queda brusca nas distâncias k ordenadas marca a fronteira entre pontos centrais e de ruído. A linha vermelha tracejada em \(\varepsilon=0{,}3\) é onde ocorre o cotovelo.
Quando o DBSCAN falha
O DBSCAN assume que os clusters têm densidade uniforme. Ele tem dificuldades quando:
- Clusters de densidade variável: um único \(\varepsilon\) pode ser muito pequeno para clusters esparsos (eles se fragmentam em ruído) e muito grande para os densos (eles se fundem). O HDBSCAN (DBSCAN hierárquico) resolve isso construindo uma hierarquia de níveis de densidade.
- Altas dimensões: a maldição da dimensionalidade faz com que todos os pontos fiquem aproximadamente equidistantes, então nenhum \(\varepsilon\) único separa regiões densas de esparsas. O DBSCAN perde seu significado além de \(d \approx 10\)-15 atributos.
- Conjuntos de dados muito grandes: mesmo com indexação espacial, as consultas de \(\varepsilon\)-vizinhança podem ser lentas em altas dimensões.
⚠️ Os rótulos de cluster do DBSCAN não são estáveis entre execuções com parâmetros diferentes
O DBSCAN é determinístico dados \(\varepsilon\) e minPts, mas os rótulos de cluster (qual cluster recebe o rótulo 1, 2, etc.) podem diferir entre implementações ou execuções com dados reordenados. Pontos de borda que caem dentro de \(\varepsilon\) de múltiplos clusters são atribuídos ao primeiro ponto central processado.
Mais importante: pequenas mudanças em \(\varepsilon\) podem causar grandes mudanças no agrupamento. Sempre teste uma faixa de valores de \(\varepsilon\) próximos ao cotovelo do gráfico de distância-k e verifique se os resultados são estáveis. Um resultado que muda completamente com uma mudança de 10% em \(\varepsilon\) não é confiável.
💡 DBSCAN em R
library(dbscan)

# k-distance plot to choose epsilon
kNNdistplot(X, k=4)
abline(h=0.3, col="red", lty=2)

# Fit DBSCAN
db <- dbscan(X, eps=0.3, minPts=5)
db$cluster   # 0 = noise, 1,2,... = clusters
table(db$cluster)

# Plot results
plot(X, col=db$cluster+1, pch=20)

# HDBSCAN (handles varying density)
hdb <- hdbscan(X, minPts=5)
plot(hdb$hc)   # dendrogram of condensed cluster tree

# LOF (Local Outlier Factor): continuous density-based anomaly score
lof_scores <- lof(X, minPts=5)
plot(X, col=ifelse(lof_scores > 2, "red","black"), pch=20)
