Análise discriminante
A Análise Discriminante Linear (LDA) e a Análise Discriminante Quadrática (QDA) classificam observações modelando a distribuição condicional à classe dos atributos como Gaussianas multivariadas e aplicando o teorema de Bayes. A LDA assume que todas as classes compartilham a mesma matriz de covariância, dando fronteiras de decisão lineares; a QDA permite que cada classe tenha sua própria covariância, dando fronteiras quadráticas. O Naive Bayes faz uma simplificação ainda mais forte, tratando os atributos como condicionalmente independentes dentro de cada classe, trocando alguma precisão por um modelo que escala para muito mais atributos.
O modelo generativo
Tanto a LDA quanto a QDA modelam cada classe \(k\) como uma Gaussiana multivariada:
\[P(\mathbf{x} \mid C=k) = \frac{1}{(2\pi)^{p/2}|\boldsymbol{\Sigma}_k|^{1/2}} \exp\!\left(-\frac{1}{2}(\mathbf{x}-\boldsymbol{\mu}_k)^T\boldsymbol{\Sigma}_k^{-1}(\mathbf{x}-\boldsymbol{\mu}_k)\right)\]
Aplicando o teorema de Bayes, a probabilidade posterior da classe \(k\) é:
\[P(C=k \mid \mathbf{x}) \propto \pi_k \cdot P(\mathbf{x} \mid C=k)\]
em que \(\pi_k = P(C=k)\) é a probabilidade a priori da classe \(k\), estimada como a proporção da classe nos dados de treinamento.
Análise Discriminante Linear (LDA)
A LDA adiciona a restrição \(\boldsymbol{\Sigma}_1 = \boldsymbol{\Sigma}_2 = \cdots = \boldsymbol{\Sigma}_K = \boldsymbol{\Sigma}\) (matrizes de covariância iguais). Sob essa restrição, a razão log-posterior entre duas classes se simplifica para uma função linear de \(\mathbf{x}\):
\[\delta_k(\mathbf{x}) = \mathbf{x}^T\boldsymbol{\Sigma}^{-1}\boldsymbol{\mu}_k - \frac{1}{2}\boldsymbol{\mu}_k^T\boldsymbol{\Sigma}^{-1}\boldsymbol{\mu}_k + \log\pi_k\]
\[\hat{c} = \arg\max_k \delta_k(\mathbf{x})\]
O termo quadrático \(\mathbf{x}^T\boldsymbol{\Sigma}^{-1}\mathbf{x}\) é o mesmo para todas as classes e se cancela na comparação, deixando uma função linear de \(\mathbf{x}\). A fronteira de decisão entre as classes \(j\) e \(k\) é o conjunto de pontos em que \(\delta_j(\mathbf{x}) = \delta_k(\mathbf{x})\): um hiperplano.
Estimação de parâmetros: \(\hat{\boldsymbol{\mu}}_k\) = médias amostrais por classe; \(\hat{\boldsymbol{\Sigma}}\) = covariância amostral combinada dentro da classe.
O critério de Fisher: maximizando a separação entre classes
Uma forma equivalente de derivar a LDA: encontrar a direção de projeção \(\mathbf{w}\) que maximiza a razão entre a variância entre classes e a variância dentro da classe depois de projetar os dados sobre \(\mathbf{w}\):
\[\mathbf{w}^* = \arg\max_{\mathbf{w}} \frac{\mathbf{w}^T \mathbf{S}_B \mathbf{w}}{\mathbf{w}^T \mathbf{S}_W \mathbf{w}}\]
em que \(\mathbf{S}_B = \sum_k n_k(\boldsymbol{\mu}_k - \boldsymbol{\mu})(\boldsymbol{\mu}_k - \boldsymbol{\mu})^T\) é a matriz de dispersão entre classes e \(\mathbf{S}_W = \sum_k \sum_{i \in C_k}(\mathbf{x}_i - \boldsymbol{\mu}_k)(\mathbf{x}_i - \boldsymbol{\mu}_k)^T\) é a matriz de dispersão dentro da classe.
A solução é \(\mathbf{w}^* = \mathbf{S}_W^{-1}(\boldsymbol{\mu}_1 - \boldsymbol{\mu}_2)\) para duas classes. Para \(K\) classes, as primeiras \(K-1\) direções discriminantes são os autovetores de \(\mathbf{S}_W^{-1}\mathbf{S}_B\) correspondentes aos maiores autovalores.
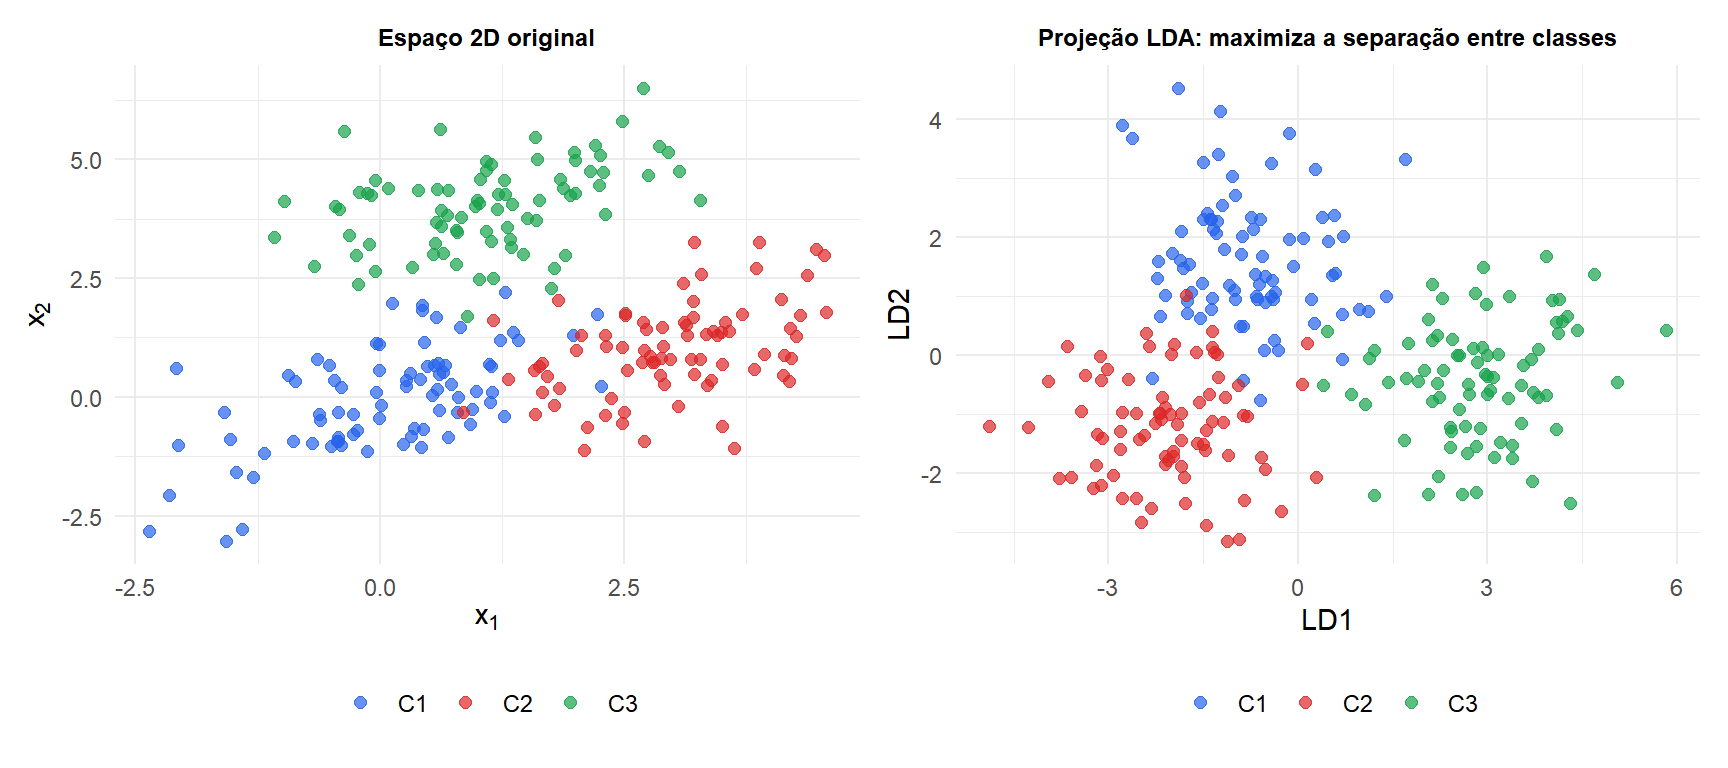
Essa é a perspectiva de redução de dimensionalidade da LDA: projetar sobre as \(K-1\) direções que melhor separam as classes, depois classificar no espaço reduzido.
Análise Discriminante Quadrática (QDA)
A QDA relaxa a suposição de covariância igual. Cada classe tem sua própria covariância \(\boldsymbol{\Sigma}_k\), e a log-posterior não se simplifica para uma função linear:
\[\delta_k(\mathbf{x}) = -\frac{1}{2}\log|\boldsymbol{\Sigma}_k| - \frac{1}{2}(\mathbf{x}-\boldsymbol{\mu}_k)^T\boldsymbol{\Sigma}_k^{-1}(\mathbf{x}-\boldsymbol{\mu}_k) + \log\pi_k\]
O termo \((\mathbf{x}-\boldsymbol{\mu}_k)^T\boldsymbol{\Sigma}_k^{-1}(\mathbf{x}-\boldsymbol{\mu}_k)\) é a distância de Mahalanobis ao quadrado de \(\mathbf{x}\) até o centroide da classe \(k\), ponderada pela covariância da classe. A fronteira de decisão entre as classes \(j\) e \(k\) é uma superfície quadrática (elipse, parábola ou hipérbole em 2D).
A QDA estima \(p(p+1)/2\) parâmetros por classe para a matriz de covariância, contra o único \(\boldsymbol{\Sigma}\) combinado da LDA. Com \(K\) classes: a QDA tem \(K \cdot p(p+1)/2\) parâmetros de covariância contra \(p(p+1)/2\) da LDA.
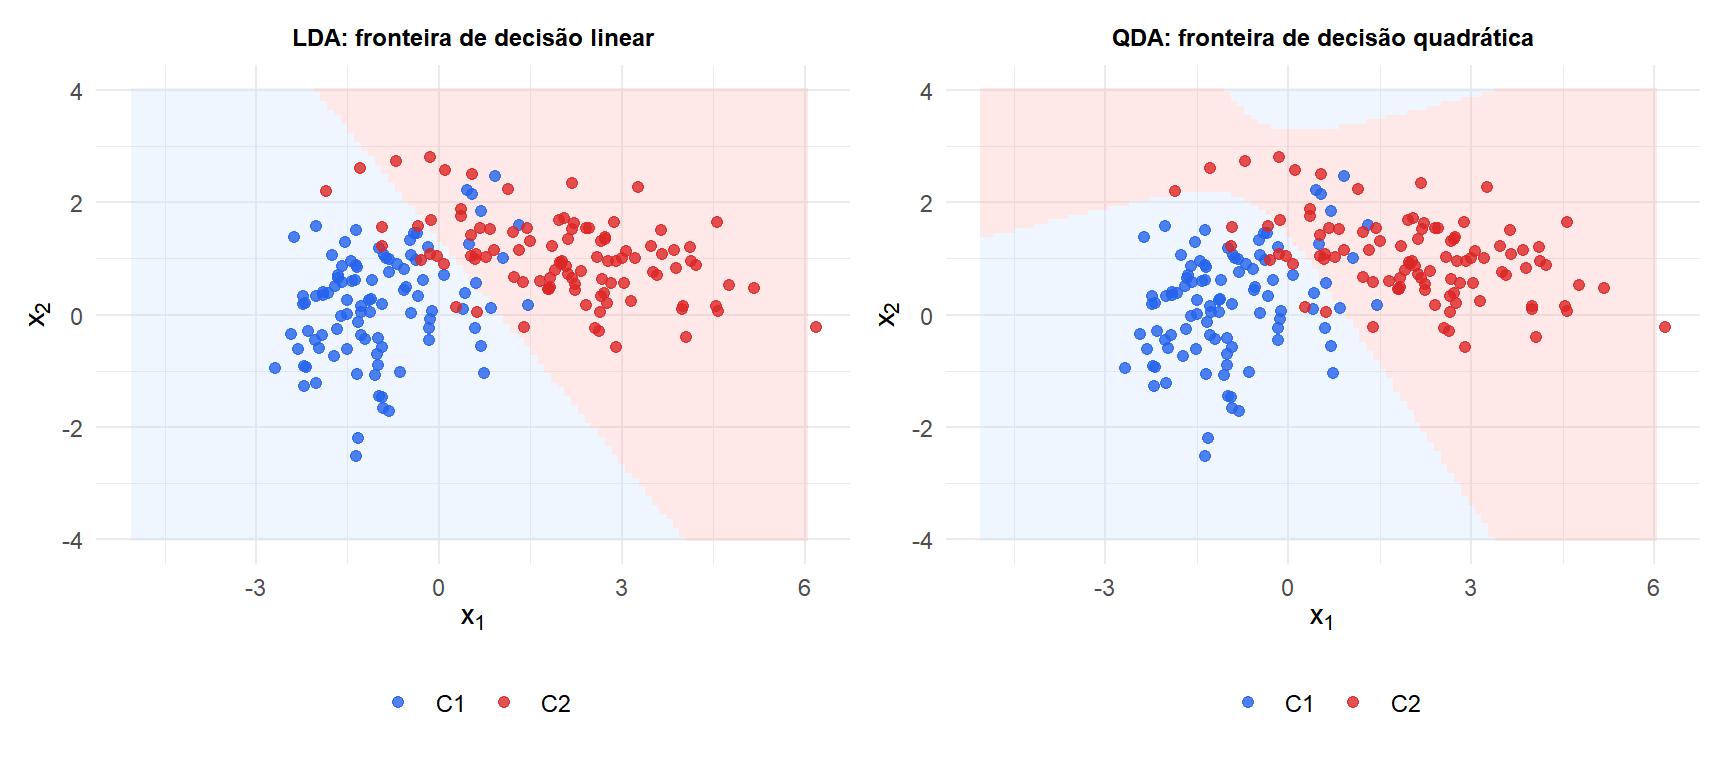
Com covariâncias desiguais (C2 tem variância maior e correlação negativa), a LDA força uma fronteira reta que classifica mal os pontos nas caudas. A QDA curva a fronteira para se ajustar melhor à verdadeira estrutura das classes.
LDA como redução de dimensionalidade
Para \(K\) classes em \(p\) dimensões, a LDA projeta os dados sobre no máximo \(K-1\) direções discriminantes antes de classificar. Isso torna a LDA um passo de pré-processamento útil:
- Reduz \(p\) dimensões para \(K-1\) para visualização ou como entrada para outro classificador.
- Diferentemente da PCA (que maximiza a variância total), a LDA maximiza a separação entre classes no espaço reduzido.
- Para \(K=2\): um único eixo discriminante separa as duas classes. Plote a projeção 1D para visualizar a separabilidade.
- Para \(K=3\): dois eixos discriminantes dão um gráfico 2D que mostra a estrutura das classes.
⚠️ A LDA falha quando a suposição de covariância igual é fortemente violada
Quando as classes têm covariâncias muito diferentes, a fronteira linear da LDA é mal especificada e a acurácia se degrada. Sinais de violação: dispersão ou forma muito diferente das nuvens de pontos por classe, as matrizes de covariância parecem muito diferentes numericamente.
Teste com o teste M de Box (biotools::boxM()) para a igualdade formal das matrizes de covariância. Se rejeitado, use a QDA. Note que a QDA precisa de mais dados: cada classe precisa de pelo menos \(p+1\) observações para estimar sua matriz de covariância, e idealmente muitas mais para estimativas estáveis.
LDA vs QDA vs regressão logística
| LDA | QDA | Regressão logística | |
|---|---|---|---|
| Fronteira de decisão | Linear | Quadrática | Linear (padrão) |
| Suposição | Gaussiana, \(\boldsymbol{\Sigma}\) igual | Gaussiana, \(\boldsymbol{\Sigma}\) diferentes | Nenhuma sobre \(P(\mathbf{x})\) |
| Parâmetros | Poucos | Mais (\(K\) covariâncias) | \(p+1\) |
| Estável com \(n\) pequeno | Sim | Precisa de mais dados | Sim |
| Também faz redução de dim. | Sim (\(K-1\) eixos) | Não | Não |
| Sensível a outliers | Moderada | Mais | Menos |
A LDA tende a superar a regressão logística quando a suposição Gaussiana é aproximadamente correta e \(n\) é pequeno. A regressão logística é mais robusta a atributos não Gaussianos e outliers. A QDA vence quando as classes genuinamente têm estruturas de covariância diferentes e há dados suficientes disponíveis para estimá-las de forma confiável.
💡 Análise discriminante em R
library(MASS)

# LDA
fit_lda <- lda(y ~ ., data=df_train)
predict(fit_lda, newdata=df_test)$class      # predicted classes
predict(fit_lda, newdata=df_test)$posterior  # posterior probabilities
predict(fit_lda, newdata=df_test)$x          # LD scores (for plotting)

# QDA
fit_qda <- qda(y ~ ., data=df_train)
predict(fit_qda, newdata=df_test)$class

# Test equal covariances (Box's M test)
library(biotools)
boxM(df_train[,-1], df_train$y)

# Regularized LDA (for p close to n)
library(klaR)
fit_rda <- rda(y ~ ., data=df_train, gamma=0.05, lambda=0.2)
