Naive Bayes
O Naive Bayes aplica o teorema de Bayes à classificação assumindo que todos os atributos são condicionalmente independentes dada a classe. A suposição quase sempre está errada na prática, mas o Naive Bayes tem um desempenho surpreendentemente bom, particularmente em classificação de texto, em que continua sendo uma das melhores linhas de base. Suas principais vantagens são a velocidade, a interpretabilidade, e o comportamento gracioso com conjuntos de treinamento pequenos, diferentemente de métodos baseados em instâncias como o k vizinhos mais próximos, que precisa armazenar e buscar todo o conjunto de treinamento no momento da previsão.
Do teorema de Bayes a um classificador
O objetivo é encontrar a classe \(c\) que maximiza a probabilidade posterior dados os atributos observados \(\mathbf{x} = (x_1, \ldots, x_p)\):
\[\hat{c} = \arg\max_c P(C=c \mid \mathbf{x}) = \arg\max_c \frac{P(\mathbf{x} \mid C=c)\, P(C=c)}{P(\mathbf{x})}\]
Como \(P(\mathbf{x})\) é o mesmo para todas as classes, só precisamos de:
\[\hat{c} = \arg\max_c P(\mathbf{x} \mid C=c)\, P(C=c)\]
O problema: estimar \(P(\mathbf{x} \mid C=c)\) exige a distribuição conjunta de todos os \(p\) atributos dada a classe, o que é intratável para \(p\) grande.
A suposição ingênua: os atributos são condicionalmente independentes dada a classe:
\[P(\mathbf{x} \mid C=c) = \prod_{j=1}^p P(x_j \mid C=c)\]
Isso reduz a estimação a \(p\) problemas univariados, um por atributo. O classificador se torna:
\[\hat{c} = \arg\max_c P(C=c) \prod_{j=1}^p P(x_j \mid C=c)\]
Na prática, produtos de muitas probabilidades pequenas sofrem underflow para zero. Tomar logaritmos converte o produto em uma soma:
\[\hat{c} = \arg\max_c \left[\log P(C=c) + \sum_{j=1}^p \log P(x_j \mid C=c)\right]\]
Três variantes
As três variantes diferem em como modelam \(P(x_j \mid C=c)\):
Naive Bayes Gaussiano
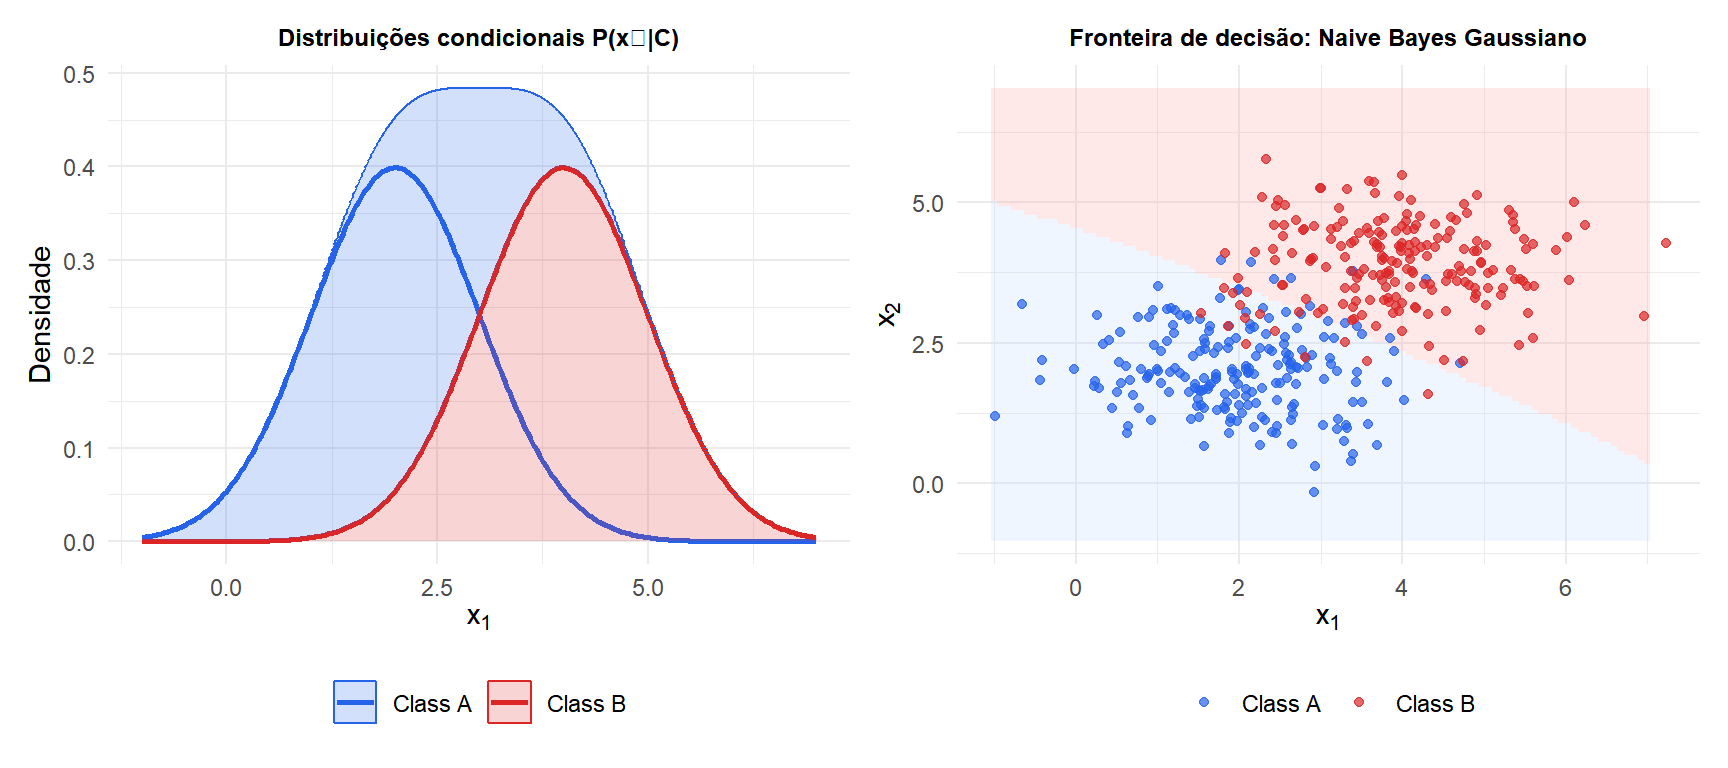
Para atributos contínuos, assume-se que cada atributo segue uma distribuição Gaussiana dentro de cada classe:
\[P(x_j \mid C=c) = \frac{1}{\sqrt{2\pi\sigma_{jc}^2}} \exp\!\left(-\frac{(x_j - \mu_{jc})^2}{2\sigma_{jc}^2}\right)\]
Os parâmetros \(\mu_{jc}\) e \(\sigma_{jc}^2\) são estimados como a média e a variância amostrais do atributo \(j\) dentro da classe \(c\). A fronteira de decisão entre duas classes é quadrática em geral (torna-se linear quando \(\sigma_{jc}^2 = \sigma_j^2\) para todo \(c\)).
Naive Bayes Multinomial
Para atributos de contagem (por exemplo, contagens de palavras em um documento), a verossimilhança de observar as contagens \(\mathbf{x} = (x_1, \ldots, x_p)\) dada a classe \(c\) segue uma distribuição multinomial:
\[P(\mathbf{x} \mid C=c) \propto \prod_{j=1}^p \theta_{jc}^{x_j}\]
em que \(\theta_{jc} = P(\text{palavra } j \mid C=c)\) é estimado como a frequência relativa da palavra \(j\) nos documentos da classe \(c\). Este é o modelo padrão para classificação de texto e filtragem de spam: cada e-mail é um saco de palavras e a contagem de cada palavra é um atributo.
Naive Bayes de Bernoulli
Para atributos binários (palavra presente/ausente), cada atributo segue uma distribuição de Bernoulli:
\[P(x_j \mid C=c) = \theta_{jc}^{x_j}(1-\theta_{jc})^{1-x_j}\]
Diferentemente do NB Multinomial, o NB de Bernoulli penaliza explicitamente a ausência de uma palavra: se uma palavra está ausente de um documento, mas é comum em uma classe, essa ausência é evidência contra essa classe.
Suavização de Laplace
Um problema de frequência zero surge no NB Multinomial e de Bernoulli: se uma palavra nunca aparece nos documentos de treinamento da classe \(c\), então \(\hat{\theta}_{jc} = 0\) e toda a posterior \(P(C=c \mid \mathbf{x}) = 0\), independentemente de todos os outros atributos.
A suavização de Laplace (suavização aditiva com \(\alpha=1\)) adiciona uma pseudocontagem de 1 a cada combinação atributo-classe:
\[\hat{\theta}_{jc} = \frac{n_{jc} + \alpha}{n_c + \alpha p}\]
em que \(n_{jc}\) é a contagem do atributo \(j\) na classe \(c\), \(n_c\) é a contagem total na classe \(c\), e \(p\) é o número de atributos. Isso garante que nenhuma probabilidade seja exatamente zero, ao mesmo tempo que encolhe as estimativas em direção a \(1/p\).
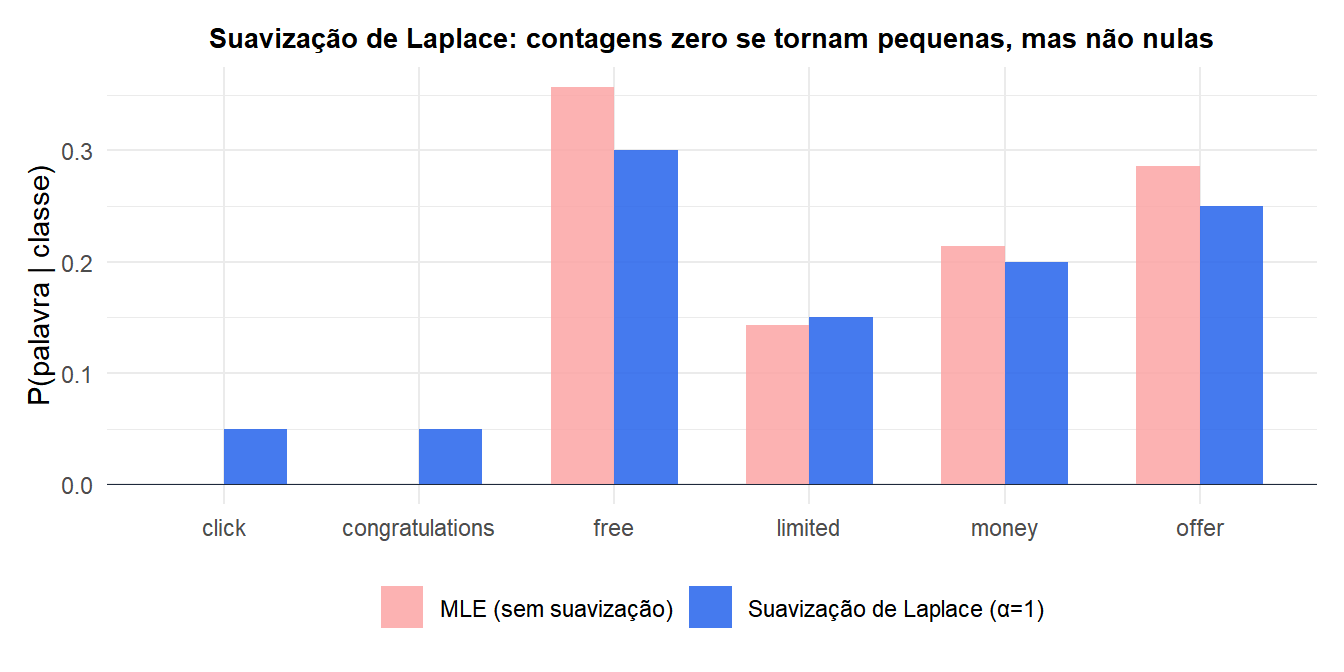
As palavras “click” e “congratulations” têm contagens zero sob MLE (vermelho), tornando-as catastróficas para qualquer documento que as contenha. A suavização de Laplace (azul) atribui a elas uma probabilidade pequena, mas não nula.
Por que funciona a despeito de suposições incorretas
A suposição de independência quase sempre é violada: palavras em uma frase são correlacionadas, atributos em um prontuário médico são correlacionados, valores de pixel em uma imagem são correlacionados. Ainda assim, o Naive Bayes frequentemente tem bom desempenho. Duas explicações:
A classificação só precisa da ordem correta, não das probabilidades corretas. Mesmo que as probabilidades estimadas estejam mal calibradas (e frequentemente estão), a ordenação das classes pela probabilidade posterior ainda pode estar correta. O Naive Bayes é um mau estimador de probabilidades, mas um bom classificador.
Os erros se cancelam. Quando os atributos são positivamente correlacionados dentro de uma classe, o Naive Bayes conta sua evidência em duplicidade. Mas ele conta em duplicidade igualmente para todas as classes, então a ordenação relativa é preservada.
O Naive Bayes falha quando as correlações diferem entre as classes: então a contagem em duplicidade é desigual e o classificador fica tendencioso em direção à classe com correlações intraclasse mais fortes.
Naive Bayes vs regressão logística
Ambos são classificadores lineares (no log-odds) para atributos binários. A diferença-chave é a abordagem de estimação:
- O Naive Bayes é um modelo generativo: estima \(P(\mathbf{x} \mid C=c)\) e \(P(C=c)\) separadamente, depois aplica o teorema de Bayes.
- A regressão logística é um modelo discriminativo: estima \(P(C \mid \mathbf{x})\) diretamente.
Com atributos Gaussianos e covariâncias iguais, o Naive Bayes e a LDA produzem a mesma fronteira linear. A regressão logística maximiza a verossimilhança condicional diretamente e é mais eficiente assintoticamente: precisa de menos dados para igualar a acurácia do Naive Bayes quando os atributos não são verdadeiramente independentes.
Na prática: o Naive Bayes vence com conjuntos de treinamento pequenos (menos a estimar); a regressão logística vence com conjuntos de treinamento grandes (explora totalmente a verossimilhança dos dados).
⚠️ As probabilidades do Naive Bayes são mal calibradas
As probabilidades posteriores produzidas pelo Naive Bayes costumam ser extremas: próximas de 0 ou 1, muito mais do que as probabilidades reais. Isso acontece porque a suposição de independência ignora as correlações, fazendo com que o modelo seja excessivamente confiante.
Se forem necessárias probabilidades calibradas (por exemplo, para limiares de decisão em diagnóstico médico), aplique regressão isotônica ou escalonamento de Platt após o Naive Bayes. Nunca use as probabilidades posteriores do Naive Bayes diretamente para decisões sensíveis a custo sem calibração.
💡 Naive Bayes em R
library(e1071)

# Gaussian Naive Bayes (continuous features)
fit_gnb <- naiveBayes(y ~ ., data=df_train)
predict(fit_gnb, newdata=df_test)                    # class labels
predict(fit_gnb, newdata=df_test, type="raw")        # posterior probs

# Laplace smoothing (for categorical/text features)
fit_mnb <- naiveBayes(y ~ ., data=df_train, laplace=1)

# For text classification with a document-term matrix
library(quanteda)
library(quanteda.textmodels)
dtm   <- dfm(corpus)
fit_t <- textmodel_nb(dtm[train_idx,], y[train_idx], smooth=1)
predict(fit_t, newdata=dtm[test_idx,])
